
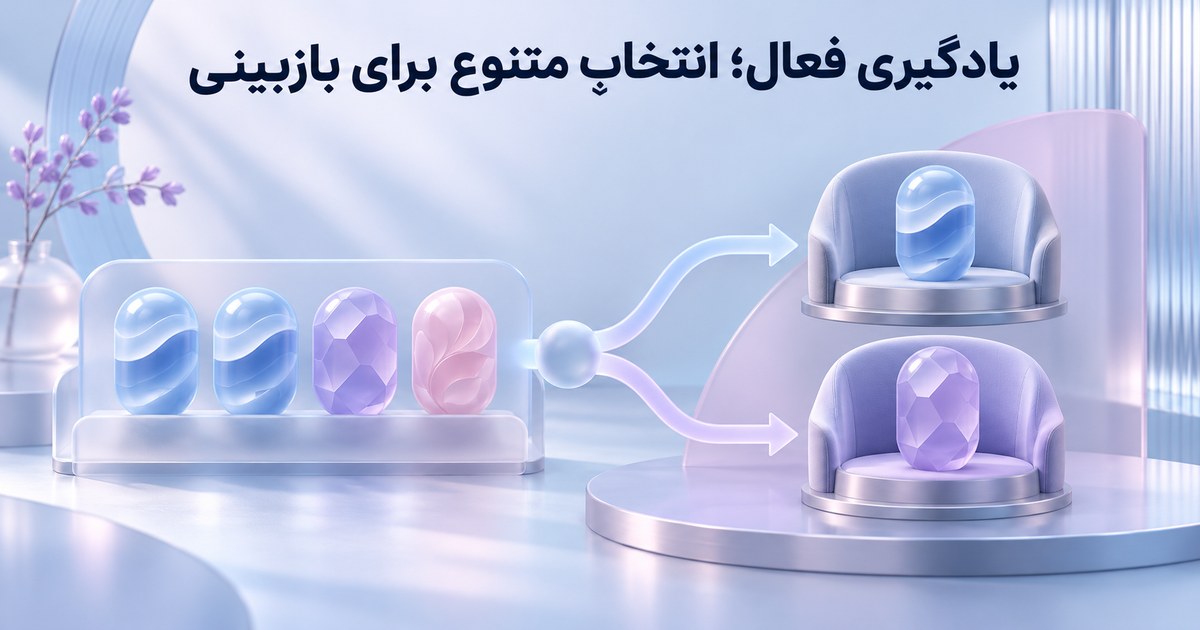
یادگیری فعال یا Active Learning، انتخاب هدفمند نمونههایی است که قرار است برچسب بگیرند و در چرخهٔ یادگیری استفاده شوند. سؤال نخست این است: با زمان محدودِ برچسبزن، کدام ورودیها را اول بررسی کنیم؟ با چهار بردار احتمالِ ساختگی نشان میدهیم چرا انتخاب دو نمونهٔ نامطمئن میتواند دو عضو بسیار نزدیک از یک خانواده را بردارد.
انتخاب نمونه با تعریف برچسب فرق دارد
در یک چرخهٔ معمول، مدل فعلی روی مجموعهٔ بدون برچسب خروجی میدهد؛ روش انتخاب، نمونههایی را برای برچسبگذاری پیشنهاد میکند؛ پاسخ انسانیِ معتبر وارد داده میشود و مدل بعداً دوباره آموزش یا بهروزرسانی میگیرد. برچسبزن هنوز به تعریف دسته و مثال مرزی نیاز دارد. روش انتخاب نمیتواند با رتبهبندی، پاسخ درستِ ناشناخته را از هیچ بسازد.
این مقاله فقط مرحلهٔ انتخاب یک دستهٔ کوچک را حساب میکند. هیچ احتمال از مدل واقعی نیامده، برچسب انسانی جمع نشده و چرخهٔ آموزش اجرا نشده است. نام یادگیری فعال را به معنی یادگیری خودکار و فوری از هر گفتوگو نگیرید.
چهار ورودی و دو فرصت بازبینی
دو برچسب احتمالی۰و۱داریم. خانوادهٔ g1شامل دو ورودی بسیار شبیهِ فرضی است؛ g2وg3دو خانوادهٔ دیگرند. شناسهٔ خانواده را نویسنده برای تمرین تعیین کرده است؛ الگوریتم خوشهبندی یا شباهت واقعی اجرا نشده است.
| نمونه | خانواده | احتمال ساختگی۰/۱ | آنتروپی بیت، گردشده |
|---|---|---|---|
| A | g1 | 0.50 / 0.50 | 1.000000 |
| B | g1 | 0.51 / 0.49 | 0.999711 |
| C | g2 | 0.60 / 0.40 | 0.970951 |
| D | g3 | 0.99 / 0.01 | 0.080793 |
آنتروپی را با -sum(p × log2(p))حساب کردهایم؛ جملهٔ p=0در این جمع صفر گرفته میشود. در همین مسئلهٔ دوکلاسه، توزیع نزدیک به نصف، عدمقطعیت بیشتری در خروجی فرضی نشان میدهد. این عدد، احتمال اشتباهبودن برچسب انسانی یا میزان اهمیت تجاری نمونه نیست.
عدمقطعیتِ تنها: AوB
اگر دو ردیف اولِ مرتبشده با آنتروپی نزولی را برداریم، AوBانتخاب میشوند. هر دو از g1هستند. ممکن است خواندن هر دو برای روشنشدن مرز مهم باشد؛ اما صرف بالابودن عدمقطعیت، پوشش متنوعِ مجموعه را تضمین نمیکند. در این تمرین، از برچسب واقعی و اثر بعدیشان خبری نداریم.
یک قاعدهٔ ساده برای تنوع: AوC
همان ترتیب را نگه میداریم، اما حداکثر یک ردیف از هر خانواده میگیریم. Aپذیرفته، Bبه دلیل خانوادهٔ تکراری رد و Cپذیرفته میشود. خروجیAوCاست. این فقط یک heuristicآموزشی است؛ بهترین دسته یا الگوریتم توصیهشده برای همهٔ پروژهها نیست. کیفیت خانوادهبندی، نقاط پرت و هزینهٔ متفاوت برچسبگذاری بر تصمیم واقعی اثر دارند.
بالابودن اطمینان هم دلیل حذف همیشگی نمونهDنیست: مدل میتواند با اطمینان اشتباه کند. برای ارزیابی، مجموعهٔ مستقل و نماینده و نمونههای کنترلِ خارج از انتخابِ صرفاً نامطمئن لازم است. چرخه را تنها روی ردیفهایی نسنجید که روش خودتان برای دیدن انتخاب کرده است.
نتیجهٔ حساب را از نتیجهٔ یادگیری جدا نگه داریم
کد واقعاً آنتروپی چهار ردیف، ترتیبA/B/C/Dو دو انتخابA/Bدر برابرA/Cرا کنترل کرده است. CSVستون human_labelرا خالی گذاشته تا پاسخ ناشناخته با عدد صفر پر نشود. از این چهار ردیف نمیتوان بهبود دقت، کاهش تعداد برچسب موردنیاز یا صرفهجویی زمانی را گزارش کرد؛ برای آن باید چرخهٔ واقعی و روش پایهٔ قابل مقایسه داشت.
پس از اجرای یک پروژهٔ واقعی، شناسهٔ مجموعه، مدل و روش انتخاب، نمونههای دیدهشده، هزینهٔ بازبینی و نتیجهٔ ارزیابیِ مستقل را نگه دارید. اگر قواعد دسته تغییر کردند، بازبینی برچسبهای قبلی هم مسئلهٔ جداگانهای است.
ادامهٔ تمرین
بودجه را به سه نمونه تغییر دهید و قبل از اجرا حدس بزنید هر روش چه چیزی برمیدارد؛ سپس توضیح دهید بدون برچسب، چرا هنوز نمیتوانید برندهٔ کیفی اعلام کنید. برای تفاوت هدفهای آموزشی و مسیر کاربرد، صفحهٔ آموزش هوش مصنوعی را ببینید. این کد قابلیت یادگیری فعالِ محصول اپرا را اعلام نمیکند.
فایل تمرین و منبع
چهار احتمال ساختگی؛ برچسب انسانی عمداً خالی است · کد انتخاب دو نمونه با عدمقطعیت و قاعدهٔ تنوع
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.