
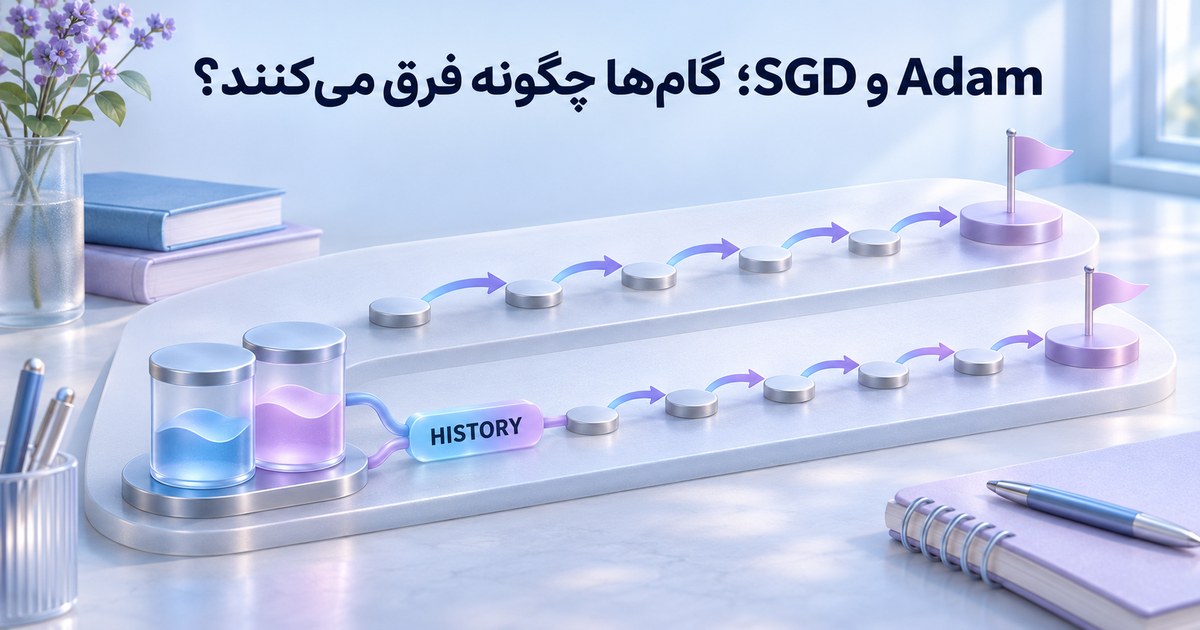
SGD ساده پارامتر را در جهت منفیِ گرادیان همان گام تغییر میدهد. Adam از میانگینهای متحرک گرادیان و مربع آن، همراه تصحیح سوگیری آغازین، برای اندازهٔ تغییر استفاده میکند. تفاوت را با دو گرادیانِ ازپیشتعیینشده حساب میکنیم؛ این تمرین رتبهبندی کیفیت یا سرعت دو بهینهساز نیست.
شرایط مثال را دقیق نگه داریم
یک پارامتر با مقدار اولیهٔ صفر، نرخ یادگیری۰٫۱ و دو ورودی گرادیان۲ و منفی۱ داریم. برای SGD، momentum و weight decay صفرند. برای Adam، beta1=0.9، beta2=0.999، epsilon=1e-8 و وزنکاهی صفر است؛ AMSGrad هم نداریم. گرادیانها را از تابع مدل حساب نکردهایم؛ آنها را عمداً ثابت دادهایم تا محاسبهٔ دو قانون جدا دیده شود.
در آموزش واقعی، با متفاوتشدن پارامترها، گرادیان گامهای بعدی نیز میتواند متفاوت باشد. پس این مقایسهٔ ورودی یکسان برای فهم قانون است، نه دو مسیر واقعیِ آموزش روی یک تابع. برای خود گرادیان نزولی، مثال گامبهگام گرادیان را ببینید.
دو گام چه نتیجهای میدهند؟
| گام | گرادیان دادهشده | پارامتر SGD | پارامتر Adam | m تصحیحشده | v تصحیحشده |
|---|---|---|---|---|---|
| 1 | 2 | -0.200000 | -0.100000 | 2.000000 | 4.000000 |
| 2 | -1 | -0.100000 | -0.126634 | 0.421053 | 2.499250 |
در گام اول، SGD از صفر به منفی۰٫۲ میرود. در Adam، m تصحیحشده۲ و v تصحیحشده۴ است؛ پس گام تقریباً۰٫۱ میشود و پارامتر تقریباً منفی۰٫۱ است. epsilon باعث میشود مقدار دقیق، کمی با منفی۰٫۱ فرق داشته باشد؛ CSV عدد کامل را نگه میدارد.
در گام دوم، SGD با گرادیان منفی۱ به سمت مثبت حرکت میکند و به منفی۰٫۱ میرسد. Adam در همین ورودی ساختگی هنوز به سمت منفی ادامه میدهد، چون میانگین متحرک تصحیحشدهٔ گرادیان هنوز مثبت است. این رفتار نه شاهد «اشتباهبودن Adam» است و نه شاهد برتری SGD؛ تاریخچه در قانون بهروزرسانی حضور دارد.
m و v چه کار میکنند؟
در Adamِ این تمرین، m برابر۰٫۹برابر مقدار قبلی بهاضافه۰٫۱برابر گرادیان تازه است. v برابر۰٫۹۹۹برابر قبلی بهاضافه۰٫۰۰۱برابر مربع گرادیان تازه میشود. سپس در گام t، m بر 1−0.9^t و v بر 1−0.999^t تقسیم میشوند. اندازهٔ تغییر برابر نرخ یادگیری ضربدر m تصحیحشده تقسیم بر مجموعِ ریشهٔ v تصحیحشده و epsilon است؛ این مقدار از پارامتر کم میشود: theta -= lr*m_hat/(sqrt(v_hat)+epsilon).
اینها قرارداد نسخهٔ پایهٔ مثالاند. Adam، AdamW، SGD با momentum و Nesterov را با نام کوتاه «بهینهساز» یکی نگیرید. مستند همان پیادهسازی، نوع وزنکاهی و حالتهای اختیاری را بخوانید. کد همراه با کتابخانهٔ استاندارد Python اجرا شده است؛ اجرای PyTorch یا آموزش مدل واقعی ادعا نمیشود.
برای انتخاب، چه مقایسهای منصفانهتر است؟
داده، تقسیمها، مدل آغازین، ترتیب batchها و معیار را ثبت کنید. بودجهٔ جستوجوی تنظیمها برای هر روش روشن باشد؛ یک نرخ یکسان الزاماً بهترین یا منصفانهترین تنظیم هر دو نیست. زمان، تعداد بهروزرسانی و میزان دادهٔ دیدهشده را جدا گزارش کنید؛ برابرکردن یکی به معنی برابرشدن همه نیست.
معیار انتخاب را روی اعتبارسنجی تعیین کنید و دادهٔ آزمون نهایی را برای تنظیم مکرر مصرف نکنید. اعتبارسنجی تودرتو دربارهٔ سوگیری انتخاب روش توضیح میدهد. افت سریع زیان آموزش هم بهتنهایی تعمیم بهتر را ثابت نمیکند؛ بیشبرازش مسئلهای جداست.
فایلها را چگونه بررسی کنیم؟
CSV، دو گام و مقدارهای میانی را دارد؛ Python همان محاسبه را تکرار و چند انتظار مرجع را کنترل میکند. برای تمرین، تنها ترتیب دو گرادیان را عوض کنید و اثر تاریخچه را ببینید. عددهای این صفحه عملکرد محصول، پیشنهاد خرید یا اعلام بهینهساز داخلی اپرا نیستند. مسیر ادامهٔ مبانی در صفحهٔ هوش مصنوعی است.
فایل تمرین و منبع
محاسبهٔ دو گام با گرادیانهای ازپیشتعیینشده؛ CSV · کد محلی بهروزرسانی SGD و Adam؛ Python
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.