
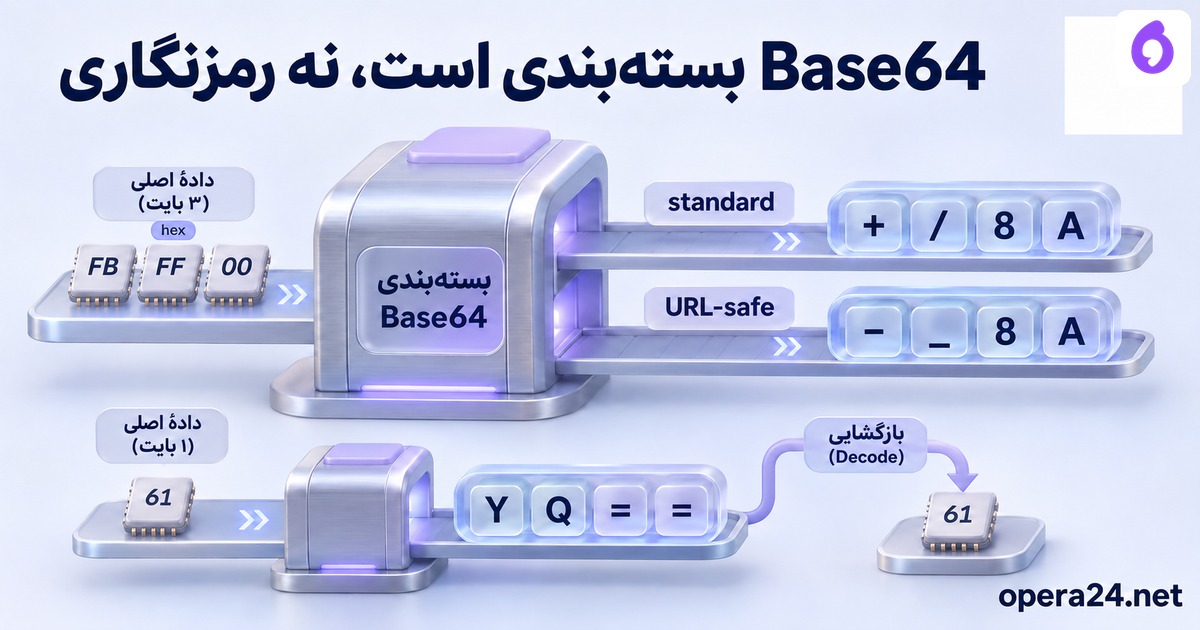
Base64 بایتها را به نویسههایِ ASCII تبدیل میکند تا در یک مسیرِ متنی حمل شوند؛ رمزنگاری و فشردهسازی نیست. قبل از decode باید قراردادِ الفبا، padding و شکلِ پذیرفتهشده روشن باشد. این راهنما پنج ورودیِ بایتیِ اصیل را رفتوبرگشت میدهد و نشان میدهد موفقیتِ decode الزاماً به معنیِ یکتابودنِ نوشتارِ ورودی نیست.
از بایت شروع کنیم، نه از حدسِ متن
fixtureهای ما طولهای۰،۱،۲ و۳ دارند و یک سهبایتیِ غیرمتنی هم کنارشان است. بایتِ a بهYQ==،دو بایتِ ab بهYWI= وabc بهYWJj تبدیل میشوند. رشتهٔ خالی نیز خروجیِ خالی دارد. هر کدام با decoder به همان بایتهایِ اولیه برمیگردند؛ کد، برابری را رویِ bytes کنترل میکند، نه رویِ ظاهرِ چاپشده.
این مثال برایِ رمزگشاییِ صوت یا تشخیصِ زبان نیست. بعد از برگشتِ بایت، تفسیرِ آن به PCM،تصویر یا متن هنوز به قالبِ جدا نیاز دارد. اگر انتظارِ UTF-8 دارید، decodeِ متنی مرحلهٔ دیگری است؛ موفقیتِ Base64 بهتنهایی معتبربودنِ آن encoding را تأیید نمیکند.
الفبایِ عادی و URL-safe را جدا بنویسیم
بایتهایِ hexِ fbff00 در الفبایِ عادی +/8A و در نوعِ URL-safe،−_8A با علامتِ ASCIIِ minus در آغاز میشوند. تفاوت فقط زیباییِ چاپ نیست؛ دو قرارداد برایِ نویسههایِ ۶۲و۶۳ داریم. در فایل، صورتِ دقیقِ ASCII ثبت شده است و نویسهٔ نمایشیِ فارسی جای آن قرار نمیگیرد.
| ورودیِ بایتی | نوعِ استاندارد | نوعِ URL-safe |
|---|---|---|
| 61 | YQ== | YQ== |
| 6162 | YWI= | YWI= |
| 616263 | YWJj | YWJj |
| fbff00 | +/8A | -_8A |
URL-safe لزوماً padding را حذف نمیکند. خروجیِ تابعِ مربوط در Python هنوز میتواند=داشته باشد. پروتکلِ دیگری ممکن است بیpadding را صریح مجاز کند؛ قراردادِ محدودِ این تمرین همان شکلِ paddedِ تولیدشده را میپذیرد و آن سیاست را به تمامِ APIها تعمیم نمیدهد.
decoderِ سهلگیر چه چیزی را کنار میگذارد؟
رشتهٔY!Q== را واقعاً با b64decodeِ پیشفرض میخوانیم؛!کنار گذاشته میشود و بایتِ 61 برمیگردد. همان ورودی با validate=True خطایِ binascii.Error میدهد. پس بهتر است برای قراردادِ ورودی، رفتارِ موردانتظار را صریح انتخاب کنیم؛ سکوتِ مسیرِ پیشفرض را با پاکبودنِ متن یکی نگیریم.
تابعِ canonicalِ اصیلِ ما علاوه بر validate، یک الفبایِ مشخص و سقفِ ۱۲۸نویسه دارد. برای حالتِ URL-safe، الفبایِ عادی را رد میکند. این سختگیری، سیاستِ همین wrapper است؛ نمیگوییم decoderِ عمومیِ کتابخانه تمامِ همین ردها را خودکار انجام میدهد.
validate=True هنوز شاهدِ شکلِ یکتا نیست
دو صورتِ YQ== وYR== با validate=True در اجرایِ ثبتشده هر دو به بایتِ a میرسند. تفاوت در pad bitهایِ بدونِ نقشِ محتوایی است. RFC4648 برای encoderِ سازگار صفرشدنِ آن بیتها را بیان میکند؛ امکانِ decodeِ دو متنِ متفاوت، تمایزِ بایتِ محتوا و نوشتار را روشن میکند.
در profileِ این تمرین، پس از decode دوباره با همان الفبا encode میکنیم و فقط برابریِ دقیق با متنِ ورودی را میپذیریم. به این ترتیب YR== رد میشود. چهار مسیرِ رد در JSON آمدهاند: نویسهٔ بیرونِ الفبا، paddingِ حذفشده، pad bitِ غیرصفر و الفبایِ عادی در قراردادِ URL-safe.
این آزمون چه چیزی را تأیید نکرد؟
هیچ کلید، امضا، توکنِ واقعی، اتصالِ شبکه یا دادهٔ مشتری استفاده نشده است. تبدیلِ Base64 بهتنهایی اصالت یا محرمانگی نمیسازد. برایِ حفظِ هویتِ بایت، هش و مانفیستِ فایلِ اصلی پرسشِ دیگری دارد؛ برایِ تفسیرِ ساختارِ صوت، parserِ فریمِ باینری را ببینید.
تمامِ پنج رفتوبرگشت و چهار رد با Python۳٫۱۲٫۱۴ اجرا شدهاند. برای ادامه به مبانی هوش مصنوعی بروید و هنگامِ طراحیِ اتصال، نامِ الفبا، سیاستِ padding، حدِ طول و قالبِ بایتِ مقصد را ثبت کنید. وجودِ چنین profile یا قالبی در APIِ محصولات اپرا از این تمرین نتیجه نمیشود.
فایل تمرین و منبع
کد مستقلِ تمرینِ محدود · تمام خروجیِ واقعیِ همین تمرین؛ JSON
- Python۳٫۱۲؛ b64decode/validate،الفبایِ جایگزین و URL-safe
- RFC4648،اکتبر۲۰۰۶؛ بخشهای۳٫۱تا۳٫۵و۴و۵،padding،الفبا وpad bits
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.