
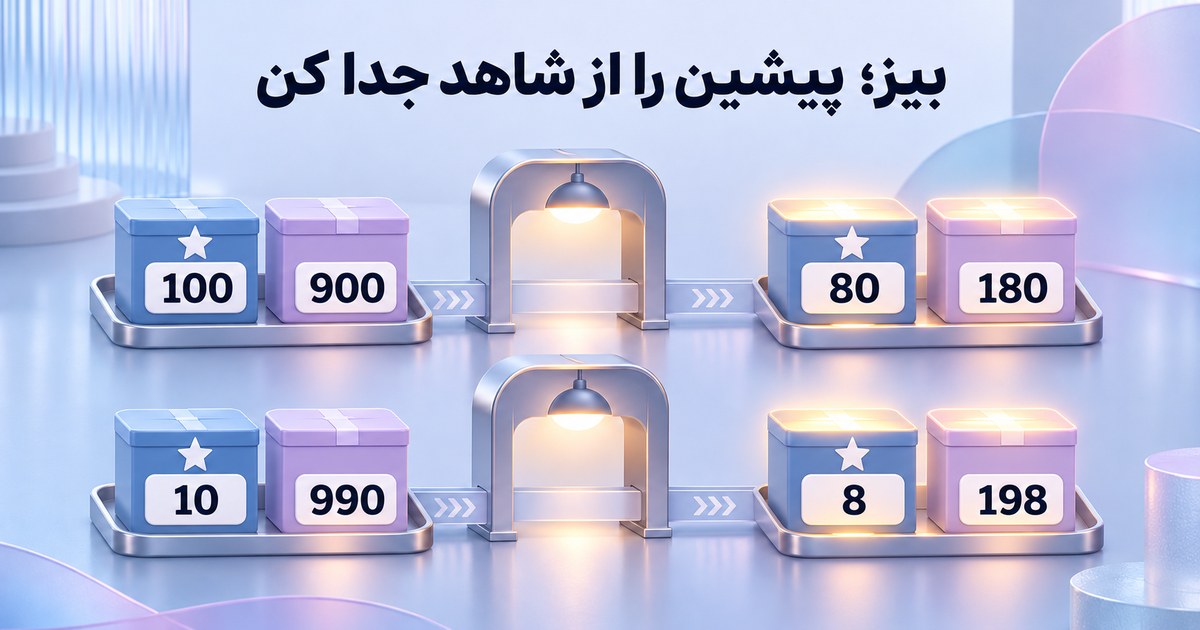
قضیهٔ بیز احتمالِ یک حالت را پس از مشاهدهٔ شاهد، با پیشین و احتمالِ آن شاهد در حالتهای مختلف بهروز میکند. اگر پیشین عوض شود، حتی با درستنماییهای ثابت، پسین میتواند فرق کند. اینجا دو جمعیتِ کاملاً ساختگی از جعبهها را با فرمول احتمال، oddsو درختِ تعداد کنترل میکنیم؛ مدل یا نرخِ واقعیِ کسبوکار برآورد نشده است.
دو جهتِ شرط را جابهجا نکنیم
Aیعنی جعبه در مجموعهٔ فرضی نشان ستاره دارد؛ Eیعنی چراغِ بررسیِ فرضی روشن شده است. P(E|A)=۰٫۸وP(E|notA)=۰٫۲را برای تمرین دادهایم. اولی میپرسد در بین جعبههای ستارهدار، چراغ چند بار روشن میشود؛ P(A|E)میپرسد بین چراغروشنها، چند جعبه ستارهدار است. اینها یک مخرج ندارند.
مخرج شاهد از دو مسیر میآید
با پیشین p=P(A)، احتمال Eبرابر p×0.8+(1-p)×0.2 است. دو حالتِ AوnotAدر این تمرین همهٔ حالات را پوشش میدهند و اشتراک ندارند. صورتِ پسین p×۰٫۸و مخرج همان مجموعِ دو مسیر است؛ سهم چراغروشنِ جعبهٔ بدون ستاره را حذف نمیکنیم.
| کمیت | پیشین۱÷۱۰ | پیشین۱÷۱۰۰ |
|---|---|---|
| جمعیت ساختگی | ۱۰۰۰ | ۱۰۰۰ |
| تعداد ستارهدار | ۱۰۰ | ۱۰ |
| ستارهدار با چراغ روشن | ۸۰ | ۸ |
| بدون ستاره با چراغ روشن | ۱۸۰ | ۱۹۸ |
| P(A|E) | ۸۰÷۲۶۰=۴÷۱۳≈۰٫۳۰۷۶۹۲ | ۸÷۲۰۶=۴÷۱۰۳≈۰٫۰۳۸۸۳۵ |
درستنماییهای دو ستون یکساناند، ولی ترکیبِ جمعیت فرق دارد. بنابراین عدد۰٫۸بهتنهایی پسینِ چراغروشن را مشخص نمیکند. این جدول، اجرای حسگر یا مثال پزشکی نیست؛ جعبه و چراغ فقط نامهای رویدادِ صورت تمریناند.
همان حساب با odds
oddsاز p÷(۱−p)به دست میآید و با خودِ احتمال برابر نیست. نسبتِ درستنمایی در اینجا۰٫۸÷۰٫۲=۴است. برای پیشین۱÷۱۰، oddsپیشین۱÷۹وoddsپسین۴÷۹میشود؛ تبدیل آن به احتمال،۴÷۱۳را میدهد. برای پیشین۱÷۱۰۰، oddsاز۱÷۹۹به۴÷۹۹و احتمال به۴÷۱۰۳میرسد.
کد با Fractionواقعاً برابریِ سه مسیرِ احتمال، oddsو تعدادِ فرضی را کنترل کرده است. هیچ عددِ ممیزشناورِ گردشده در تصمیمِ این برابریها به کار نرفته است. فرمول oddsبرای p=۱مخرج صفر دارد؛ مسیر احتمالِ کد جداست و این حالت را بیخبر به یک کسرِ معمول تبدیل نمیکند.
اگر شاهد ناممکن باشد
وقتی هر دو احتمالِ شرطیِ Eصفر باشند، مخرجِ شاهد صفر است. تابع پسین را Noneبرمیگرداند؛ نه صفر، نه صددرصد. این وضعیت با شاهدِ کماحتمالِ غیرصفر تفاوت دارد. دامنهٔ همهٔ احتمالهای ورودی هم در[۰،۱]کنترل میشود؛ ورودیِ نامعتبر برای پُرکردن جدول اصلاحِ حدسی نمیشود.
چه تفاوتی با طبقهبند Naive Bayes دارد؟
مثال Naive Bayes فارسی شمارش واژه، هموارسازی و امتیازِ چند ویژگی را محاسبه میکند. اینجا یک شاهد و دو پیشین داریم و اثرِ تغییرِ نرخِ پایه بر مخرج و oddsرا جدا میبینیم. همچنین PrecisionوRecall از جدولِ برچسب و هشدارِ مشاهدهشده حساب میشوند؛ این صفحه نرخ عملکردِ سامانهٔ هشدار را اندازه نگرفته است.
قبل از استفاده از پیشینِ تازه
نرخِ واقعی، نمایندگی نمونه و ثابتماندنِ احتمالِ شاهد در هر حالت باید با داده سنجیده شوند. عوضکردن یک عدد در این تمرین، کالیبراسیونِ خودکار مدل واقعی یا کشف پیشینِ درست نیست. برای ادامهٔ مبانی راهنمای هوش مصنوعی را ببینید؛ این محاسبه دربارهٔ نتیجهٔ فروش یا کیفیت محصول اپرا ادعایی ندارد.
فایل تمرین و منبع
دو پیشین، مخرج شاهد و برابریِ فرمول oddsبا فراوانی · دو جمعیت فرضیِ جعبهها؛ پارامترها آمار واقعی نیستند
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.