
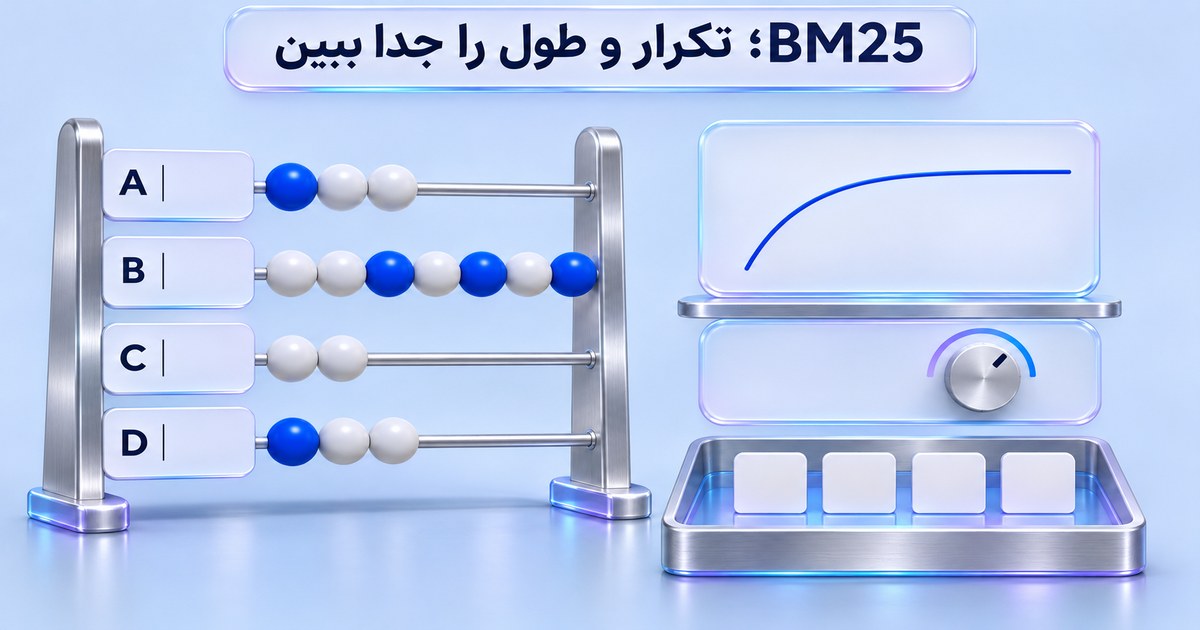
BM25 یک روش امتیازدهیِ بازیابیِ واژهای است: حضورِ واژهٔ پرسش، فراوانیِ آن در سند و آمارِ مجموعه روی امتیاز اثر میگذارند. تکرارِ بیشترِ واژه معمولاً به همان نسبت امتیاز اضافه نمیکند؛ عاملِ طول هم میتواند دو سند با فراوانیِ برابر را متفاوت کند. این امتیاز، احتمالِ درستبودنِ پاسخ نیست.
یک مجموعهٔ کوچکِ قابل شمردن
پرسشِ این تمرین فقط «تماس» است. چهار متنِ ساختگی داریم: A «تماس پیگیری مشتری»، B «تماس تماس تماس پرداخت سفارش زمان امروز»، C «سفارش زمان» و D «تماس پرداخت پرونده». جداکردن با فاصله، قراردادِ محدودِ همین داده است؛ تحلیلگر کاملِ فارسی یا ریشهیاب اجرا نشده است.
| سند | تعداد توکن | فراوانی تماس |
|---|---|---|
| A | ۳ | ۱ |
| B | ۷ | ۳ |
| C | ۲ | ۰ |
| D | ۳ | ۱ |
میانگینِ طول برابر۱۵÷۴=۳٫۷۵ است. واژه در سه سند حضور دارد؛ df برابر۳ است، نه مجموعِ پنج رخداد. برخلاف مثال TF-IDF، اینجا بردارِ واحد یا وزنِ خطیِ فراوانی نمیسازیم؛ سهمِ یک واژه در امتیازِ رتبهبندی را حساب میکنیم.
فرمولِ دقیقِ این تمرین
idf را ln(1+(N−df+0.5)/(df+0.5)) میگیریم؛ برای این مجموعه ln(10/7) است. امتیازِ تکواژه برابر idf×tf/(tf+k1×(1−b+b×dl/avgdl)) است. پارامترها k1=۱٫۲ و b=۰٫۷۵ هستند. dl تعدادِ توکنِ همان سند و avgdl میانگینِ مجموعه است.
در بعضی نوشتارهای BM25، صورت ضریبِ ثابتِ k1+1 هم دارد. در صورتِ ثابتبودنِ k1، حذفِ آن مقیاسِ امتیازِ این مقایسه را عوض میکند، اما ترتیب را عوض نمیکند. اینجا فرمولِ بدونِ آن ضریب را صریح انتخاب کردهایم؛ خروجیِ دو قرارداد را عددبهعدد مساوی معرفی نکنید.
اثرِ طول را جدا ببینیم
دو طولِ فرضی۳و۱۲ را با tf=۱ و همان آمارِ ثابت حساب میکنیم. با b=۰٫۷۵، سهمِ سندِ بلندتر کمتر میشود. با b=۰، طول از مخرج کنار میرود و دو عدد برابر میشوند. این آزمایشِ کنترلشده، افزودنِ واقعیِ سند به مجموعه نیست؛ در مجموعهٔ واقعی، تغییر متن میتواند avgdl یا df را هم تغییر دهد.
سپس در طولِ ثابت۷، فراوانیهای۱،۲،۴ را مقایسه میکنیم. امتیاز افزایش دارد ولی مقدارِ tf=۴ کمتر از چهار برابرِ مقدارِ tf=۱ است؛ اشباع را از همین رشدِ غیرخطی میبینیم. این محاسبه دلیلی برای پُرکردنِ صفحات با تکرارِ کلیدواژه نیست؛ بازیابیِ درست به تطبیقِ سؤال و مرجعِ معتبر هم نیاز دارد.
این کد موتور جستوجو نیست
کدِ Python واقعاً چهار سند و دو آزمایشِ طول/فراوانی را اجرا کرده است. کنترلِ یکنوایی در۲۳۰حالتِ محدود هم موفق بوده است. در این صفحه Lucene یا Elasticsearch راهاندازی نشده؛ طولها دقیقاند و فشردهسازیِ norm، تحلیلگر، shard، چند فیلد، boost و چندواژهایبودنِ پرسش مدل نشدهاند. پس عدد را خروجیِ دقیقِ یک موتورِ نصبشده ننامید.
پیش از تغییرِ بازیابی، مجموعهٔ سؤال و سندِ مرجع بسازید و کیفیت را با همان پرسشها بسنجید. برای پاسخگوییِ مبتنی بر راهنماهای کسبوکار، نمونههای مجاز را در درخواستِ راهاندازیِ چتِ اپرا بررسی کنید؛ استفادهٔ محصول از BM25 یا تنظیماتِ این نمونه ادعا نشده است.
فایل تمرین و منبع
محاسبهٔ تکواژه با طول دقیق و آمار مجموعهٔ ثابت · چهار سندِ اصیل و اثرِ جداگانهٔ طول و فراوانی
- مستند اصلی Lucene9.12.1؛ idf، طول متوسط و پارامترها
- کد منبع همان نسخه؛ بخش score و explainTF، نه اجرای موتور
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.