
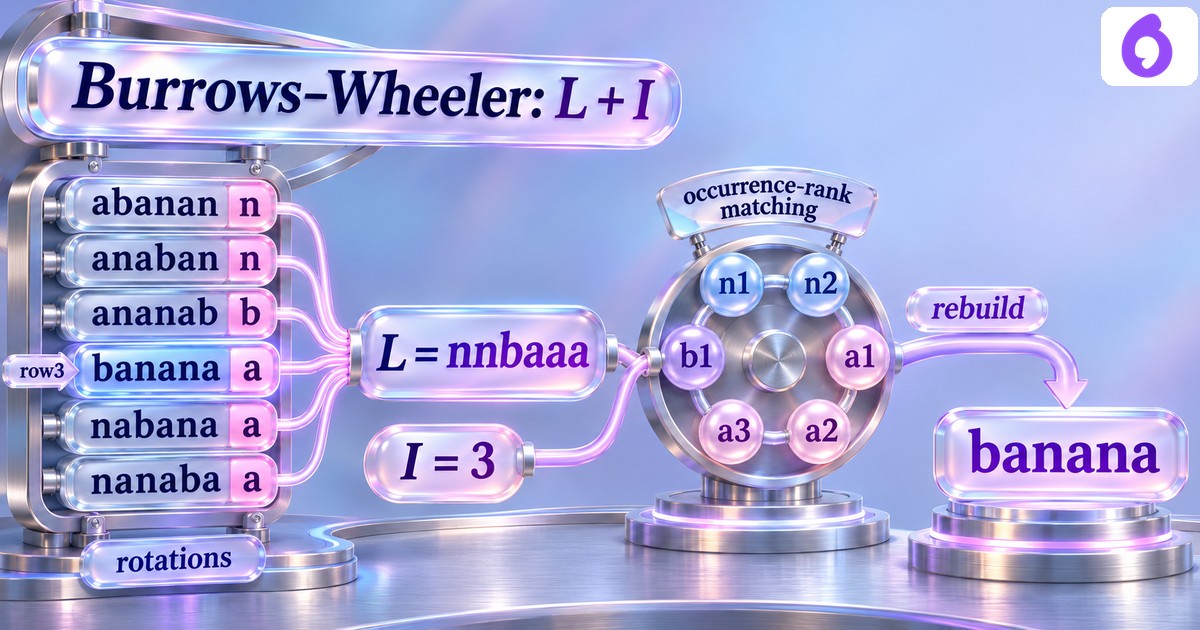
تبدیل Burrows–Wheeler یک بلوکِ متن را بازچینی میکند؛ طول و شمارِ نویسهها عوض نمیشود و خودِ این مرحله فشردهسازیِ فایل نیست. برای برگشت، ستونِ آخر و شمارهٔ ردیفِ متنِ اصلی هر دو لازماند. این تمرین بازسازی را بدونِ دسترسیِ decoder به متنِ اولیه اجرا میکند.
چرخشها و شمارهٔ ردیف
banana یک نمونهٔ آموزشیِ شناختهشده است و ادعایِ ابداعِ آن نداریم. شش چرخشِ دوریِ آن را میسازیم و با ترتیبِ واژگانی مرتب میکنیم. آخرین نویسهٔ هر ردیف، ستونِ L=nnbaaaرا میسازد؛ متنِ اصلی در ردیفِ صفرمبنای۳قرار دارد، پس I=۳است.
اگر چند چرخش دقیقاً برابر باشند، نخستین ردیفِ برابر با متن را شمارهٔ اصلی میگیریم. این سیاست برای رشتههای تناوبی مهم است. الگوریتمِ محدودِ ما حداکثر۱۲codepoint میپذیرد و چرخشهای کامل را نگه میدارد؛ پیادهسازیِ بهینهٔ صنعتی یا مدلِ byte-level معرفی نمیشود.
مرتبکردنِ ستونِ آخر کافی نیست
sort(L)رشتهٔ aaabnnمیدهد، نه banana. ستونِ مرتب Fفقط نویسههای آغازینِ ردیفهای مرتب را میگوید. تمام ستونها همان چندمجموعهٔ نویسههای ورودیاند، اما ترتیبِ آنها فرق دارد؛ برابریِ هیستوگرام متن را بازسازی نمیکند.
یک Lیکسان میتواند با Iهای معتبرِ متفاوت، چرخشهای مختلفی را بازگرداند. فایل این حالتها را واقعاً میسازد و بیش از یک پیامِ بازسازیشده دارد. بنابراین حذفِ شمارهٔ ردیف، اطلاعاتِ لازم برای انتخابِ آغازِ متن را کنار میگذارد.
رخدادِ همرتبه را دنبال کنیم
برای هر نویسهٔ L، شمارهٔ رخدادِ آن را در همان ستون میشماریم. اولین aدرLبه اولین aدرF،دومین به دومین و همینطور وصل میشود. این تناظر Tیک جایگشتِ اندیسهاست و با حفظِ رتبهٔ رخداد، نویسههای تکراری را از هم تشخیص میدهد.
از ردیفِ Iشروع میکنیم؛ L[I]آخرین نویسهٔ متن است. سپس با Tبه ردیفِ پیشینِ دوری میرویم و نویسهٔ قبلی را میگیریم. پس از Nگام، فهرستِ خواندهشده را برعکس میکنیم. دفترِ هر گام ردیف،نویسه و ردیفِ بعدی را ثبت میکند.
oracleِ بازسازیِ جدول مستقل است
روشِ دوم از Nرشتهٔ خالی شروع میکند. در هر دور، نویسههای Lرا به ابتدایِ ردیفها میچسباند و ردیفهای تازه را مرتب میکند. پس از Nدور، ردیفِ Iباید پیامِ اصلی باشد. این oracle از Tیا حلقهٔ decoder اول استفاده نمیکند.
تمام۱۲۷رشتهٔ دودوییِ طولِ صفر تا۶در هر دو مسیر رفتوبرگشت شدهاند؛ طول و شمارِ هر نویسه نیز برابر میمانند. رشتههای استانداردِ ababوaaaaو نمونههای اصیلِ «کارکار» و«a a»هم جدا اجرا میشوند؛ فاصله و Unicode بدونِ نرمالسازی حفظ میشوند.
رشتهٔ تناوبی را به چرخهٔ Nعضوی مجبور نکنیم
برای متنِ تناوبی ممکن است دنبالکردنِ Tزودتر به همان ردیف برسد، ولی تکرارِ آن مسیر هنوز تمامِ متن را با طولِ درست میسازد. شرطِ ساختگیِ «هر اندیس باید دقیقاً یک بار دیده شود» میتواند ورودیِ صحیح را رد کند. کنترلِ اصلی،بازسازیِ طولِ Nو قراردادِ رمزگذاری است.
decoder پیامِ بازسازیشده را دوباره encode میکند و برابریِ دقیقِ( L،I)را میخواهد. زوجِ بدساخت یا شمارهٔ غیرکانونیِ متنِ تناوبی در سیاستِ نخستین ردیف رد میشود. برای ورودیِ خالی فقط Lخالی وI=۰پذیرفته است؛ عددِ منفی،بولین یا خارج از دامنه معتبر نیست.
هشت نمونهٔ منفی واقعاً کنترل میشوند. LZW واژهنامه و codeword و Huffman کدِ بیتی میسازند؛ خروجیِ اینجا بازچینیِ برگشتپذیر است. ادامه در آموزش هوش مصنوعی؛ bzip2،MTF،نسبتِ فشردهسازی یا حفاظتِ متنِ خصوصی اجرا یا تضمین نشده است.
فایل تمرین و منبع
کد کاملِ تمرینِ مستقل و کنترلها؛ Python · ورودی و تمامِ خروجیِ اجرای واقعی؛ JSON
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.