
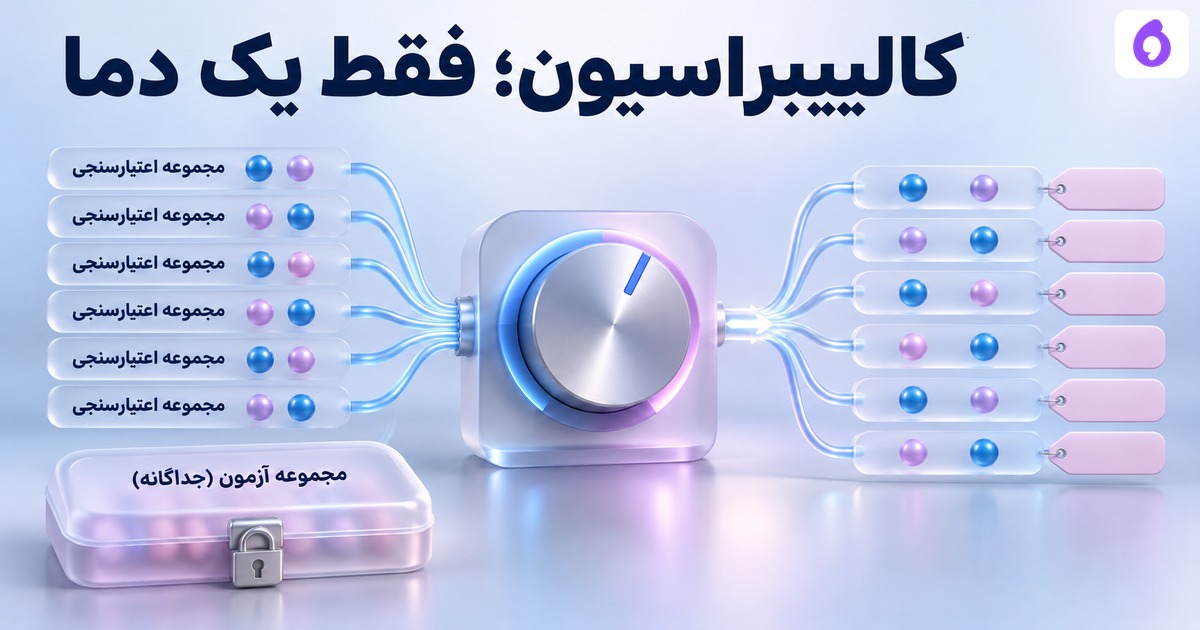
Temperature Scaling برایِ کالیبراسیون، یک پارامترِ مثبت را رویِ دادهٔ اعتبارسنجی برازش میکند تا احتمالهایِ یک دستهبند را تنظیم کند. این با تغییرِ دستیِ دمایِ تولیدِ متن به هدفِ تنوع یک کار نیست. در تمرینِ ما، یک دما واقعاً با کمینهکردنِ NLL انتخاب میشود و سپس نتیجه رویِ دادهٔ کنارگذاشتهشده جدا سنجیده میشود.
مدلِ عصبی اجرا نکردهایم
شش logitِ اعتبارسنجی، یعنی ۴،۲،۱،منفیِ۱،منفیِ۲ و منفیِ۴، همگی دستسازند. برچسبها ۱،۱،۰،۰،۱،۰ هستند. آنها خروجیِ ثبتشدهٔ شبکه، مشتری یا محصول نیستند. برایِ دو کلاس، احتمال را sigmoid(z/T) میگذاریم؛ z تفاوتِ دو logitِ آموزشی و T مثبت است.
با T=1 همان احتمالِ اولیه را داریم. T بزرگتر از یک، این توزیعِ دودویی را به نیم نزدیکتر میکند؛ اما نزدیکشدن به نیم بهخودیخود گواهِ بهترشدنِ احتمال نیست. باید هدف، دادهٔ انتخاب و سنجهٔ مستقل معلوم باشند.
برازشِ یک عدد را با دادهٔ جدا انجام دهیم
کد بهجایِ جستوجویِ مستقیمِ T، β=1/T را در بازهٔ ۰٫۰۰۱ تا چهار بررسی میکند. گرادیانِ NLL نسبت به β از خودِ شش ردیف حساب میشود. در این داده، علامتِ گرادیان در دو سر مخالف است؛ هشتاد مرحلهٔ دونیمسازی، ریشهٔ آن را پیدا میکند. با تفاضلِ محدود هم گرادیانِ نهایی مستقلاً کنترل شده است.
وزنِ هیچ دستهبندی آموزش ندادهایم؛ فقط پارامترِ پسپردازشِ همین logitها را برازش کردهایم. شش ردیفِ مجموعهٔ کنارگذاشتهشده واردِ fit نمیشوند. آن بخش را پس از انتخابِ β، با همان β ارزیابی میکنیم. کوچکبودنِ مجموعهها برای آموزشِ روش است، نه ادعایِ ارزیابیِ معتبرِ محصول.
نتیجهٔ واقعیِ همین تمرین
| بخشِ داده | NLL پیش از برازش | NLL پس از برازش |
|---|---|---|
| اعتبارسنجی؛ محلِ انتخابِ دما | 0.652780 | 0.554059 |
| کنارگذاشتهشده؛ بدونِ دخالت در انتخاب | 0.241359 | 0.404455 |
دمایِ انتخابشده حدودِ 2.165733 است. NLL اعتبارسنجی پایین آمده، اما NLL دادهٔ کنارگذاشتهشده بالا رفته است. این ضدنمونه نشان میدهد موفقیتِ هدفِ برازش، تضمینِ بهبودِ هر دادهٔ تازه نیست. هیچ نمودارِ فراوانی، ECE یا تضمینِ کالیبراسیونِ جمعیتِ واقعی از این عددها نتیجه نمیگیریم.
چرا برچسبهایِ سخت عوض نشدند؟
در همین قراردادِ دودویی، T مثبت علامتِ z را عوض نمیکند؛ با آستانهٔ نیم، برچسبِ سخت قبل و بعد یکسان است. کد این برابری را برایِ هر دوازده ردیف بررسی کرده است. اگر قاعدهٔ تصمیمِ دیگری انتخاب کنید، اثرِ احتمالِ تازه بر آن تصمیم را جدا بسنجید؛ برابریِ این آستانه را به هر سیاستِ ارجاع تعمیم ندهید.
بالا یا پایینرفتنِ NLL با تغییرِ تعدادِ پاسخِ درست یک معنی ندارد. NLL احتمالِ دادهشده به مرجع را هم در نظر میگیرد. یک پاسخِ غلطِ بسیار مطمئن میتواند سهمِ بزرگی در آن داشته باشد؛ حفظِ برچسبها به معنیِ ثابتماندنِ کیفیتِ احتمال نیست.
دامنهٔ مرجع و دامنهٔ ادعایِ ما
مقالهٔ اصلیِ سالِ ۲۰۱۷، تقسیمِ logitها بر یک T مثبت و برازش با NLL اعتبارسنجی را توضیح میدهد. ما بخشِ تعریفِ روش را خوانده و مثالِ دودوییِ مستقل نوشتهایم؛ آزمایشها یا نتیجههایِ آن مقاله را بازتولید نکردهایم. هیچ GPU، کتابخانهٔ شبکه یا API فراخوانی نشده است.
معنیِ کالیبراسیونِ احتمال دربارهٔ تطبیقِ امتیاز و فراوانی است؛ اینجا خودِ پارامتر واقعاً انتخاب شده است. دمایِ تولیدِ متن هم هدف و قراردادِ دیگری دارد. برایِ تحلیلِ تماس، تعریفِ امتیاز و مسیرِ نتیجهٔ نامطمئن را در بررسیِ اپرابین مطرح کنید؛ تنظیمِ دمایِ کالیبراسیون در محصول از این تمرین وعده داده نمیشود.
فایل تمرین و منبع
برازشِ واقعیِ یک دمایِ مثبت با NLL رویِ اعتبارسنجی · احتمالها، گرادیان و نتیجهٔ جداگانهٔ مجموعهٔ کنارگذاشتهشده
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.