
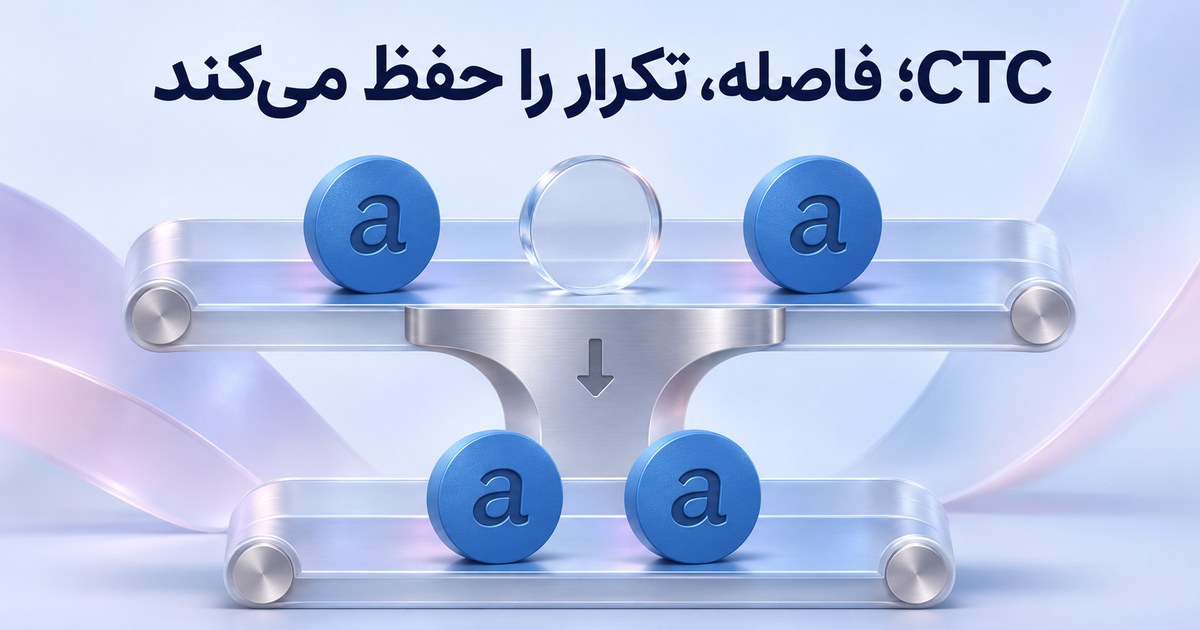
CTC یا Connectionist Temporal Classification روشی برای آموزش نگاشت دنبالهٔ ورودی به دنبالهٔ خروجی است، وقتی همترازی دقیق هر واحد از قبل معلوم نیست. در یک مثال گفتار، تعداد گامهای ورودی با تعداد نویسههای متن برابر نیست. CTC مسیرهای شامل برچسب و blank را به متن نگاشت میکند؛ blank را نباید خودکار معادل فاصلهٔ نوشتاری یا سکوت واقعی گرفت.
اول تکرار مجاور را ادغام کنیم، بعد blank را برداریم
در این تمرین، نماد ∅ فقط نمایش blank است و در کد با None مشخص میشود. مسیر «ا،ا،∅،ا» ابتدا به «ا،∅،ا» و سپس به «ا،ا» میرسد. اگر اول blank را حذف و بعد تکرار را ادغام کنید، فقط یک «ا» میماند؛ ترتیب اشتباه، خروجی را عوض کرده است.
| مسیر آموزشی | متن پس از نگاشت | علت |
|---|---|---|
| ا،ا | یک ا | تکرارهای مجاور یکی میشوند |
| ا،∅،ا | دو ا | blank دو تکرار را جدا میکند |
| ∅،ا،∅ | یک ا | blankها وارد متن نهایی نمیشوند |
| ∅،∅ | خروجی خالی | برچسب نوشتاری وجود ندارد |
بهترین مسیر لزوماً محتملترین متن نیست
دو گام ساختگی داریم؛ در هر گام احتمال blank برابر ۰٫۶ و احتمال «ا» برابر ۰٫۴ است. انتخاب حریصانه در هر گام، مسیر blank،blank با احتمال ۰٫۳۶ را میسازد و متنش خالی است. اما سه مسیر دیگر همگی به یک «ا» نگاشت میشوند: blank،ا و ا،blank هرکدام ۰٫۲۴؛ ا،ا برابر ۰٫۱۶. مجموع احتمال متن «ا» برابر ۰٫۶۴ است.
بنابراین بیشترین احتمال یک مسیر با بیشترین مجموع احتمال یک متن یکسان نیست. این نمونه، خروجی یک موتور واقعی یا معیار دقت فارسی نیست؛ توزیعهای آن عمداً برای فهم تفاوت ساخته شدهاند. تعداد مسیرها در مسئلهٔ واقعی زیاد میشود و شمردن کامل همهٔ آنها روش عملی عمومی نیست.
کد مستقل نگاشت و محاسبهٔ چهار مسیر
import itertools,math
from collections import defaultdict
def collapse(path):
    result=[];previous=object()
    for token in path:
        if token is not None and not isinstance(token,str):
            raise ValueError('string tokens or None blank required')
        if token!=previous and token is not None:result.append(token)
        previous=token
    return tuple(result)
assert collapse(['ا','ا',None,'ا'])==('ا','ا')
assert collapse(['ا','ا'])==('ا',)
assert collapse([None,None])==()
assert collapse([])==()
# Two independent time-step distributions, conditional on a toy fixed input.
frames=[{None:.6,'ا':.4},{None:.6,'ا':.4}]
scores=defaultdict(float)
for path in itertools.product(*[tuple(f) for f in frames]):
    prob=math.prod(frames[t][token] for t,token in enumerate(path))
    scores[collapse(path)]+=prob
best_path=tuple(max(f,key=f.get) for f in frames)
print('greedy path',best_path,'greedy output',collapse(best_path))
print('summed sequence probabilities',dict(scores))
assert collapse(best_path)==()
assert abs(scores[('ا',)]-.64)<1e-12
assert abs(scores[()]-.36)<1e-12
assert max(scores,key=scores.get)==('ا',)
assert abs(sum(scores.values())-1)<1e-12
تابع اول فقط قرارداد collapse را اجرا میکند؛ بخش دوم، چهار مسیر مثال دوگامی را میشمارد و احتمالها را جمع میزند. این کد تابع زیان کامل CTC، آموزش مدل، beam search یا تبدیل فایل صوتی به متن نیست. فقط دو خطِ مهم «نگاشت» و «جمع احتمال مسیرها» را قابل کنترل میکند.
نویسهٔ تکراری را از خروجی نهایی حذف نکنید
قاعدهٔ ادغام، مربوط به مسیر برچسبها پیش از نگاشت است. اجرای حذف تکرار روی متن نهایی میتواند نوشتهٔ درست را خراب کند. همچنین همترازی اجباری وظیفهٔ دیگری است؛ اینجا متنِ ازپیشمعلوم را روی صوت واقعی زمانبندی نکردهایم.
برای بررسی مدل واقعی، خروجی را با متن مرجع و معیار مشخص مقایسه کنید؛ تفاوت CER و WER فارسی معیارهای متن را توضیح میدهد. این آموزش هیچ معماری داخلیای به اپرانگار نسبت نمیدهد. اگر تبدیل گفتار فارسی به متن میخواهید، کاربرد و خروجی موردنیاز را در همان مسیر درخواست توضیح دهید.
فایل تمرین و منابع
دریافت کد آموزشی CTC؛ بدون نصب مدل، فایل صوتی یا اتصال شبکه اجرا میشود.
منابع در ۳ نوامبر ۲۰۲۶ مطالعه شدند؛ مقالهٔ تصویری Distill در ۲۷ نوامبر ۲۰۱۷ منتشر شده و خبر امروز نیست.