
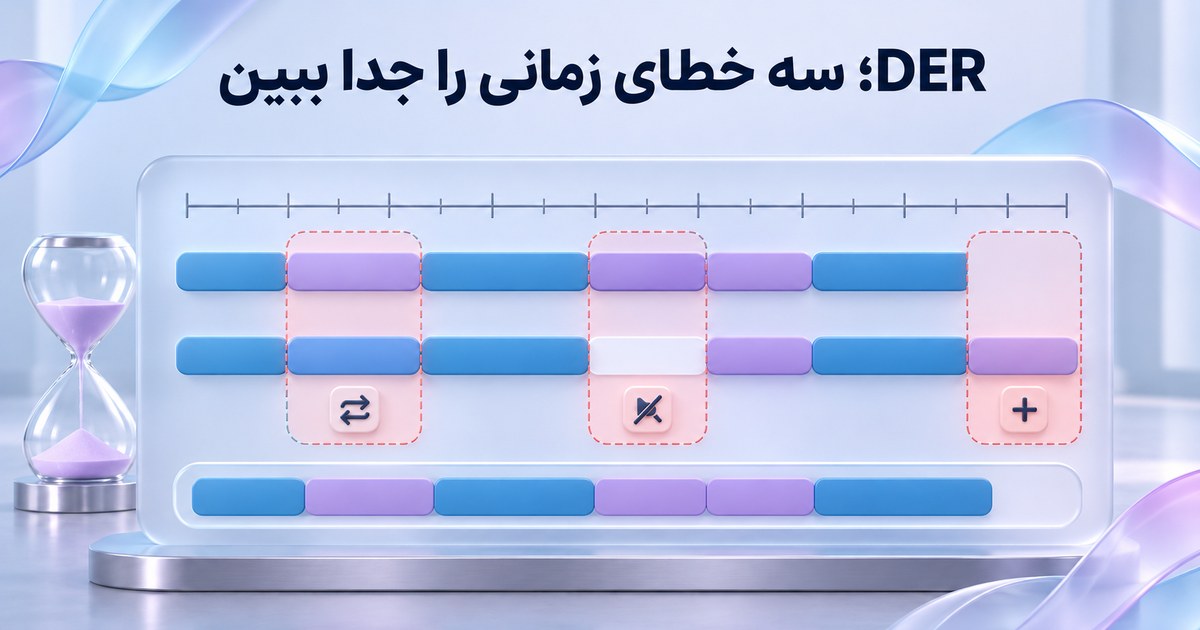
DER یا نرخ خطای تفکیک گوینده، خطا را بر حسب زمان میسنجد، نه تعداد کلمههای متن. برای خواندن عددش باید دامنهٔ ارزیابی، نگاشت برچسبها، مرزهای زمانی و رفتار صحبت همزمان را بدانیم. در این مثال دهثانیهایِ ساختگی، سه نوع خطا را جدا حساب میکنیم؛ هیچ صدای واقعی یا مدل تشخیص گوینده اجرا نشده است.
سه جزء صورت و یک مخرج مشخص
تعریف مورد استفاده، مجموعِ گفتار ازدسترفته، گفتار اضافی و اشتباه گوینده تقسیم بر کل زمانِ گوینده در مرجع است. در نمونهٔ بدون همزمانی ما، هر ثانیه حداکثر یک گوینده دارد. پس مخرج همان مجموع ثانیههای گفتار مرجع میشود؛ سکوتِ مرجع را به آن اضافه نمیکنیم.
| بازهٔ نیمهباز، ثانیه | مرجع | خروجی فرضی | پس از نگاشت |
|---|---|---|---|
| [۰،۳) | A | x | درست |
| [۳،۴) | A | y | اشتباه گوینده |
| [۴،۷) | B | y | درست |
| [۷،۸) | B | سکوت | گفتار ازدسترفته |
| [۸،۹) | سکوت | x | گفتار اضافی |
| [۹،۱۰) | سکوت | سکوت | بدون خطای گفتار |
چرا اول باید برچسبها نگاشت شوند؟
x نام واقعی فرد نیست و لازم نیست با A همنام باشد. دو نگاشت یکبهیک را برای کل فایل میآزماییم: x→A و y→B در برابر x→B و y→A. در اولی شش ثانیه نسبت درست و یک ثانیه اشتباه گوینده داریم؛ در دومی یک ثانیه درست و شش ثانیه اشتباه. نگاشت اول کمترین confusion را دارد و برای کل فایل ثابت میماند؛ برای هر قطعه نگاشت تازه انتخاب نمیکنیم.
کد برای همین دو گوینده همهٔ دو جایگشت را واقعاً امتحان میکند؛ الگوریتم عمومی Hungarian یا کتابخانهٔ pyannote را اجرا نکردهایم. تغییر نام x و y در خروجی، بعد از نگاشت دوباره نباید امتیاز را تغییر دهد؛ این آزمون هم در فایل هست. تفاوت برچسب گوینده و هویت واقعی را برای تفسیر نامها جدا بخوانید.
محاسبهٔ مثال: سه ثانیه خطا، هشت ثانیه مرجع
مرجع چهار ثانیه A و چهار ثانیه B دارد؛ مخرج۸ است. گفتار ازدسترفته۱، گفتار اضافی۱ و اشتباه گوینده۱ ثانیه است؛ پس DER=(۱+۱+۱)÷۸=۰٫۳۷۵، یعنی۳۷٫۵درصد. تقسیم بر کل مدت۱۰ثانیه، عدد۳۰درصد میدهد که DER همین قرارداد نیست.
در این محاسبه کلمهای بررسی نشده است. ممکن است متن واژهها درست باشد ولی نسبت گوینده غلط باشد، یا برعکس. DER پایین را شاهد دقت نام، عدد، نفی یا خلاصه معرفی نکنید؛ کنترل متن، گوینده و زمان این محورهای جدا را دنبال میکند.
مرز کاربرد فایل آموزشی
بازهها در این داده دقیقاً یکثانیهایاند؛ collar صفر، دامنهٔ ارزیابی [۰،۱۰) و همزمانی غایب است. کد، تقریب یکثانیهای را برای قطعههای با مرز کسری پیشنهاد نمیکند. برای دادهٔ واقعی باید ابزارِ سنجش، دقت مرزها، حذف یا نگهداشتن overlap و روش نگاشت ثبت شوند. در صحبت همزمان، زمان گوینده میتواند با زمان دیواری متفاوت باشد؛ این تمرین آن حالت را پیاده نکرده است.
اگر دو گزارش collar یا دامنهٔ ارزیابی متفاوت دارند، مقایسهٔ مستقیم عددشان گمراهکننده است. نامعلومبودن برچسب مرجع هم با سکوت یکی نیست؛ null در فایل حاضر فقط «نبود گفتار در بازه» است، نه مرجع نامشخص.
برای سفارش خروجی چه بگوییم؟
اگر متن جلسه با تفکیک گوینده میخواهید، نمونهٔ مجاز، نوع برچسب لازم و معیار زمانی را در درخواست اپرانگار بنویسید تا امکان تحویل با تیم روشن شود. عدد این صفحه نتیجهٔ محصول اپرا یا مقایسهٔ موتورهای واقعی نیست. JSON و Python برای بازتولید حسابِ همین مثالاند؛ امتیازدهی عمومی فایل صوتی انجام نمیدهند.
فایل تمرین و منبع
ده بازهٔ یکثانیهای ساختگی با گفتار مرجع و خروجی فرضی · کد نگاشت سراسری دو برچسب و تفکیک سه خطای زمانی
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.