
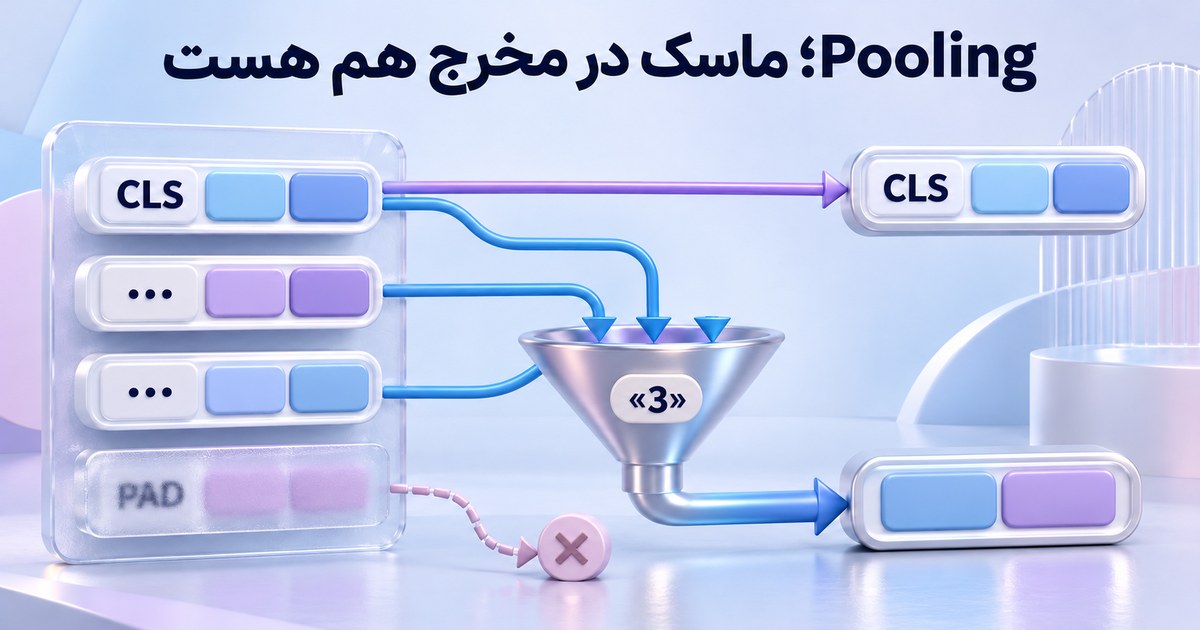
مدلِ متن میتواند برای چند جایگاهِ توکن چند بردار بسازد، درحالیکه جستوجو به یک بردارِ متن نیاز داشته باشد. Pooling مرحلهٔ تبدیلِ این مجموعه به نمایشِ ثابت است. با چهار بردارِ ساختگی، میانگینِ دارای ماسک را از میانگینِ همهٔ جایگاهها و انتخابِ یک ردیفِ CLSنمادین جدا حساب میکنیم؛ مدل واقعی بارگذاری نشده است.
چهار جایگاه و دو بُعد
| نقشِ فرضی | بردار | ماسکِ اصلی |
|---|---|---|
| CLSنمادین | [۲،۰] | ۱ |
| محتوا۱ | [۰،۲] | ۱ |
| محتوا۲ | [۲،۲] | ۱ |
| paddingآزمایشی | [۱۰۰،۱۰۰] | ۰ |
عدد بزرگِ paddingرا عمداً انتخاب کردهایم تا اثرِ خطا دیده شود؛ این عدد خروجیِ واقعیِ یک مدل نیست. ماسک مشخص میکند کدام ردیف در جمع و مخرجِ میانگین باشد. در قرارداد اصلی، CLSهم حضور دارد؛ این تصمیم را پنهان نکردهایم و به همهٔ مدلها تعمیم نمیدهیم.
سه حسابِ متفاوت
جمع سه ردیفِ مجاز [۴،۴] و تعدادشان۳است؛ meanدارای ماسک [۴÷۳،۴÷۳] میشود. اگر هر چهار ردیف را بیماسک میانگین بگیریم، [۲۶،۲۶] به دست میآید. اگر فقط دو ردیفِ محتوا را انتخاب کنیم، میانگین [۱،۲] است. هر سه حساب از همان ماتریساند؛ اختلافشان از قرارداد انتخابِ ردیف و مخرج میآید.
انتخابِ بردار CLSدر این مثال فقط ردیف اول یعنی[۲،۰]را میدهد. این مقدار را با BERT pooler_output یا یک نمایشِ آموزشدیدهٔ مناسبِ شباهت یکسان ننامید. «گرفتن ردیف اول» و «داشتن مدل آموزشدیده برای همان هدف» دو ادعای متفاوتاند.
آزمونِ padding و همهماسکشده
کد واقعاً مقدار paddingرا از۱۰۰به۱۰۰۰۰۰۰تغییر میدهد؛ meanبا همان ماسک عوض نمیشود. تغییرِ یک مؤلفه در ردیفِ مجاز نتیجه را عوض میکند. اگر ماسک همه صفر باشد، تابع Noneبرمیگرداند و بردار یا نمرهٔ معتبر جعل نمیکند؛ این سیاستِ محلی با سیاست احتمالیِ یک کتابخانهٔ دیگر یکی فرض نمیشود.
ماسک باید با تعداد ردیفها برابر و شامل۰یا۱صحیح باشد؛ boolدر این قرارداد پذیرفته نیست. ردیفها هم باید طول مشترک و عددهای محدود داشته باشند. این کنترلها برای ماتریسِ کوچک آموزشیاند، نه مدیریت خودکار همهٔ tensorها یا خروجیهای مدلها.
نرمالسازی L2 مرحلهٔ دیگری است
پس از meanدارای ماسک، نرمالسازی L2بردار را به[۱÷√۲،۱÷√۲]میرساند. بردار CLSنمادین پس از همان نرمالسازی[۱،۰]است. نرمالکردن، انتخابِ ردیف یا اثر paddingرا اصلاح نمیکند؛ مسیرِ غلط میتواند برداری با طولِ یک هم بدهد. شباهت کسینوسی را با قراردادِ بردار نهایی بخوانید.
از مستند مدل، قراردادِ همان مدل را بگیریم
ماژولهای Sentence Transformersچند روش poolingدارند و کارتِ مدلِ معرفیشده در منبع، نمونهای از meanبا attention maskرا نشان میدهد. این شاهد، بهترینبودنِ همیشگیِ meanیاCLSبرای فارسی نیست. روش آموزش، special tokenها، include_prompt و خروجیِ موردنیاز را برای همان مدل بررسی کنید؛ در این تمرین هیچ tokenizer، SentenceTransformerیاTorchاجرا نشده است.
تفاوت embedding و تولید متن دربارهٔ نقش دو خروجی در فرایند پاسخ است؛ اینجا شکلِ بردار نهایی و ماسکش را حساب کردیم. برای نیازِ جستوجوی راهنمای مشتری، پرسش و سند مورد انتظار را در بررسی چت سایت اپرا مطرح کنید؛ این فایلها کیفیت یا معماری محصول را گزارش نمیکنند.
فایل تمرین و منبع
محاسبهٔ meanباماسک، بدون ماسک، CLSنمادین و نرمالسازی جدا · چهار بردارِ ساختگی و قرارداد صریحِ حضورِ جایگاه ویژه
- مستندات اصلی Sentence Transformers؛ روشهای Pooling و Normalize
- کارت اصلی مدل؛ نمونهٔ mean poolingبا attention mask
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.