
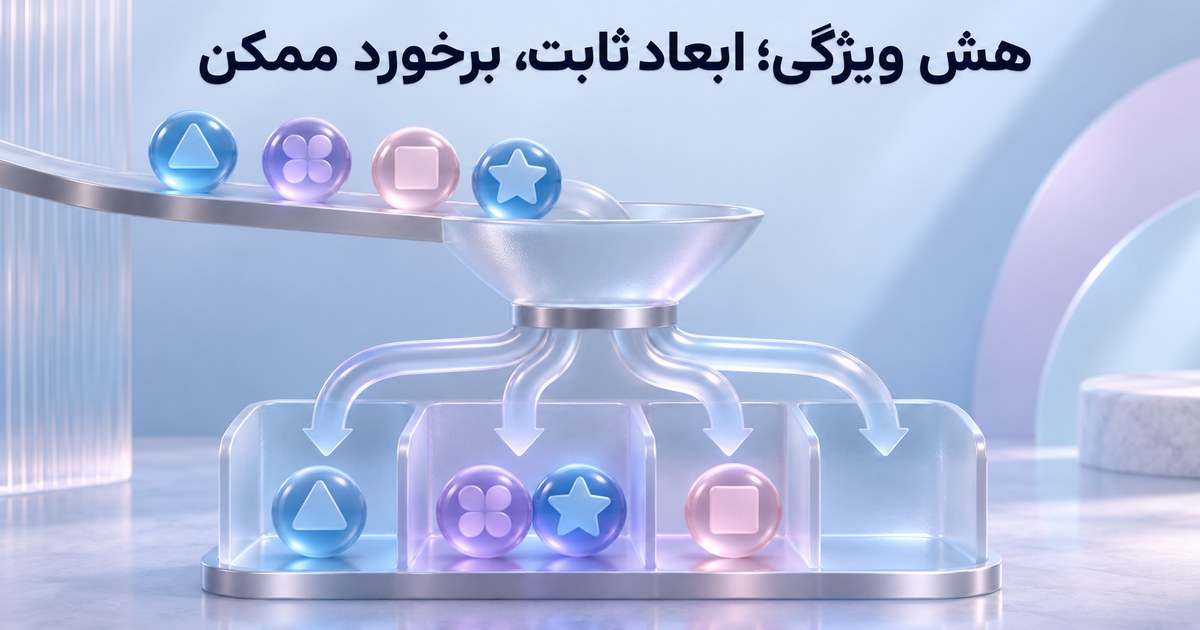
Feature Hashing نام ویژگیها را با یک تابع هش به تعداد ثابتی ستون نگاشت میکند. لازم نیست برای هر واژهٔ تازه ستونی تازه به واژهنامه اضافه کنیم، اما ممکن است چند نام در یک ستون قرار بگیرند. این برخورد، بخشی از معاملهٔ روش است؛ خروجی را نباید به معنی شناسایی یکتای واژهها گرفت.
یک نگاشت کوچک که برخورد را پنهان نمیکند
برای فهم قرارداد، تابع آموزشی بسیار سادهای انتخاب میکنیم: مجموع کد Unicode نویسههای واژه، پیمانهٔ چهار. این تابع برای مدل واقعی توصیه نمیشود و پیادهسازی FeatureHasher نیست. هدف آن است که برخورد، قابل پیشبینی و با دست قابل بررسی باشد؛ سپس تفاوتش با ابزار کتابخانهای روشن بماند.
ورودی نخست «اب» و «با» است. ترتیب دو نویسه در جمع اثری ندارد، پس هر دو به ستون ۴ میروند. اگر هرکدام یک بار دیده شود، مقدار همان ستون ۲ خواهد بود. ورودی «اب اب» نیز همین بردار را میدهد؛ از خروجی تنها نمیتوان فهمید کدام متن اولیه وجود داشته است.
| ورودی آموزشی | بردار چهارستونی | نکته |
|---|---|---|
| اب، با | [۰،۰،۰،۲] | دو نام در یک ستون |
| اب، اب | [۰،۰،۰،۲] | بردار یکسان، ورودی متفاوت |
| نام تازه | همچنان چهار ستون | ابعاد عوض نمیشود |
کد مستقل؛ فقط نمایش سازوکار
def toy_bucket(name,n_features=4):
    if type(n_features) is not int or n_features<=0:
        raise ValueError('positive integer feature count required')
    if not isinstance(name,str):raise ValueError('string feature required')
    return sum(ord(c) for c in name)%n_features
def vector(names,n_features=4):
    if type(n_features) is not int or n_features<=0:
        raise ValueError('positive integer feature count required')
    result=[0]*n_features
    for name in names:result[toy_bucket(name,n_features)]+=1
    return result
print('two different names',vector(['اب','با']))
print('same name twice',vector(['اب','اب']))
print('new name fixed width',vector(['تازه']))
assert toy_bucket('اب')==toy_bucket('با')==3
assert vector(['اب','با'])==vector(['اب','اب'])==[0,0,0,2]
assert len(vector(['تازه']))==4
کد هیچ مدل آموزشی را اجرا نمیکند. در scikit-learn، FeatureHasher از Murmurhash3 با قرارداد علامت استفاده میکند؛ عددهای این تمرین با خروجی آن برابر نیستند. تغییر الگوریتم هش، تعداد ستون یا روش ساخت ویژگی پس از آموزش، معنای ستونها را تغییر میدهد و مدل قبلی را بدون آزمون سازگار نگه نمیدارد.
تعداد ستون و علامت چه تصمیمی میسازند؟
تعداد ستون کمتر، فضای برخورد را محدودتر میکند؛ اما اثر واقعی بر کیفیت به داده و وظیفه بستگی دارد. در نسخههای دارای علامت، سهم ویژگی میتواند مثبت یا منفی شود؛ این راهحل به معنی حذف کامل برخورد نیست. نتیجه را با چند اندازهٔ مشخص روی اعتبارسنجی مقایسه و مصرف حافظه را جدا اندازهگیری کنید. مثال چهارستونی، معیار انتخاب ابعاد پروژهٔ واقعی نیست.
در نمایش شمارشی ممکن است به ستون با مقدار غیرمنفی نیاز داشته باشید. پیش از وصلکردن خروجی به الگوریتم بعدی، قرارداد ورودی آن را بخوانید. همچنین اگر بررسی علت یک نتیجه مهم است، نبود واژهنامهٔ معکوس هزینه دارد؛ نگاشت یک ستون به یک نام یکتا در این روش تضمین نمیشود.
هش ویژگی، رمزگذاری اطلاعات نیست
هشکردن نام ویژگی بهتنهایی داده را ناشناس نمیکند و مجوز انتشار متن خصوصی نمیسازد. این موضوع را با کنترل هش فایل دانلودشدهٔ مدل یکی نگیرید: آنجا یکپارچگی فایل با مقدار مرجع سنجیده میشود؛ اینجا نمایش ورودیِ مدل ساخته میشود.
برای مقایسه، کلید تکراری در JSON هم مسئلهٔ دیگری است؛ دو کلید برابر با دو نام متفاوتِ همستونشده یکی نیستند. اگر نیاز شما یافتن پاسخ معتبر از محتوای کسبوکار است، معیار پاسخ و ارجاع را در شروع با تیم اپرا تعیین کنید. این راهنما ادعایی دربارهٔ الگوریتم داخلی خدمات اپرا ندارد.
فایل تمرین و منابع
دریافت کد مستقل این راهنما. دادهها ساختگی و آموزشیاند؛ کد اتصال شبکه، فایل شخصی یا فراخوانی سرویس ندارد.
تاریخ مطالعهٔ منبع: ۳ نوامبر ۲۰۲۶. محاسبهها و مثال این مطلب برای آموزش طراحی شدهاند.