
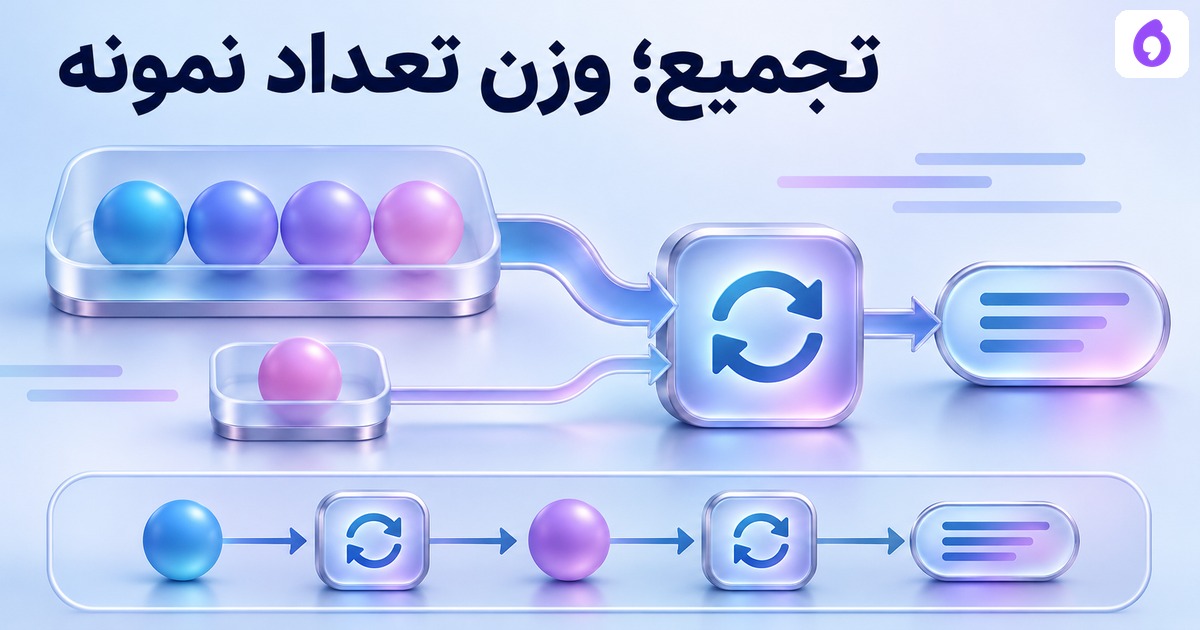
تجمیعِ گرادیان یعنی سهمِ چند زیردسته را پیش از یک گامِ بهینهساز کنارِ هم نگه داریم. اگر هدف میانگینِ خطا رویِ نمونهها باشد، دستههایِ نابرابر باید به اندازهٔ واقعیِ خود وزن بگیرند. در این تمرین، یک دستهٔ چهارتایی و یک دستهٔ تکنمونه را با گرادیانِ کاملِ پنج نمونه مقایسه و یک گامِ دقیقِ SGD اجرا میکنیم.
تابعِ زیان و پارامتر را ثابت نگه داریم
پنج زوجِ ساختگیِ x,y داریم: [۱،۰]،[۲،۰]،[۳،۰]،[۴،۰] و[۵،۱۰]. مدل فقط w×x است و در آغاز w=1 داریم. زیان نصفِ میانگینِ مربعِ خطاهاست؛ مشتقِ هر ردیف نسبت به w برابرِ (w×x−y)×x میشود. این دادهٔ آموزشی، خروجیِ مشتری یا شبکهٔ واقعی نیست.
در پارامترِ آغازین، سهمِ پنج ردیف بهترتیب یک،چهار،نه،شانزده و منفیِ بیستوپنج است. جمع پنج و میانگین یک میشود. تا وقتی گرادیانهایِ دو زیردسته را جمع میکنیم، w همان یک میماند؛ حرکتِ پارامتر در میانهٔ کار، محاسبه را عوض میکند.
دستهٔ کوچک، وزنِ کوچکتر دارد
میانگینِ گرادیانِ چهار ردیفِ نخست ۳۰÷۴ یعنی ۷٫۵ و میانگینِ دستهٔ آخر منفیِ ۲۵ است. با وزنهایِ چهارپنجم ویکپنجم، حاصل ۶−۵ یعنی یک میشود و با گرادیانِ میانگینِ کامل برابر است. کد هر دو مسیر را جدا از خودِ ردیفها محاسبه میکند.
| قراردادِ جمع | گرادیان | w پس از یک گام با نرخِ ۰٫۱ |
|---|---|---|
| میانگینِ کاملِ پنج ردیف | ۱ | ۰٫۹ |
| دو میانگین با وزنِ تعدادِ نمونه | ۱ | ۰٫۹ |
| میانگینِ سادهٔ دو میانگین | منفیِ ۸٫۷۵ | ۱٫۸۷۵ |
در ردیفِ سوم، به تکنمونهٔ آخر همان وزنِ کلِ چهار نمونهٔ دیگر داده شده است؛ جهتِ گام هم عوض میشود. تقسیمِ هر loss بر تعدادِ زیردستهها فقط وقتی همان میانگینِ ردیفها را میسازد که اندازهها و قراردادِ reduction مناسب باشند. دستهٔ آخرِ ناقص را پنهان نکنید.
دو گامِ پیاپی همان یک گام نیست
حالا عمداً بعد از هر زیردسته یک بهروزرسانی انجام میدهیم. دستهٔ اول w را از یک به ۰٫۲۵ میبرد؛ مشتقِ دستهٔ دوم در همین پارامترِ تازه محاسبه و w در پایان ۴٫۶۲۵ میشود. این مسیر، گرادیانِ هر دو زیردسته در پارامترِ مشترک و یک گامِ نهایی نیست.
کد traceِ پارامترِ قبل، مشتقِ فعلی و پارامترِ بعد را نگه میدارد. برایِ مسیرِ درست، زیانِ کل پیش و پس از گام هم حساب شده، اما کاهشِ همین مثال تضمینِ نزول با هر نرخ یا هر تابع نیست. مدلِ ما فقط یک پارامتر و زیانِ تجزیهپذیرِ ردیفی دارد.
چه زمانی برابریِ ساده برقرار نمیماند؟
اگر عملیاتِ مدل به خودِ ترکیبِ batch وابسته باشد، محاسبهٔ چند زیردسته الزاماً همان forwardِ دستهٔ بزرگ را نمیدهد. آمارِ BatchNorm، تصادفیبودنِ Dropout، حالتِ بهینهساز، ترتیبِ clipping و دقتِ ممیزشناور میتوانند نیازمندِ قراردادِ جدا باشند. این موارد را این کد شبیهسازی نکرده است.
مرجعِ PyTorch دربارهٔ تجمیع و زمانِ unscale و update در AMP توضیح میدهد؛ این تمرین AMP،GPU یا PyTorch اجرا نمیکند. کاهشِ حافظه، زمانِ آموزش یا برابریِ بیتی را اندازه نگرفتهایم. Fraction فقط برابریِ ریاضیِ همین مثالِ خطی را قابلِ کنترل میکند.
شمارشِ گام و مقدارِ گرادیان را جدا ثبت کنیم
Epoch،Batch وStep تعدادِ رویدادهایِ آموزش را میشمارد؛ اینجا مقدارِ واقعیِ گرادیان و پارامتر را حساب کردیم. در گامهایِ گرادیانِ نزولی نیز نرخ و تابعِ هدف اهمیت دارند. برایِ گزارش، تعدادِ نمونهٔ هر زیردسته، reductionِ زیان و زمانِ اجرایِ optimizer را کنارِ هم نگه دارید.
اگر هدفِ شما پاسخگویی یا پیگیریِ مشتری است، معیارِ خروجی را در بررسیِ نیاز با اپرا روشن کنید. نامِ روشِ آموزش بهتنهایی معیارِ خرید نیست و این تمرین روشِ داخلیِ محصولاتِ اپرا را اعلام نمیکند.
فایل تمرین و منبع
گرادیانِ کامل، تجمیعِ وزندار و دو بهروزرسانیِ متفاوت را حساب کنید · پنج گرادیانِ ردیفی، وزنِ دستهها و ردِ گامهایِ پیاپی
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.