
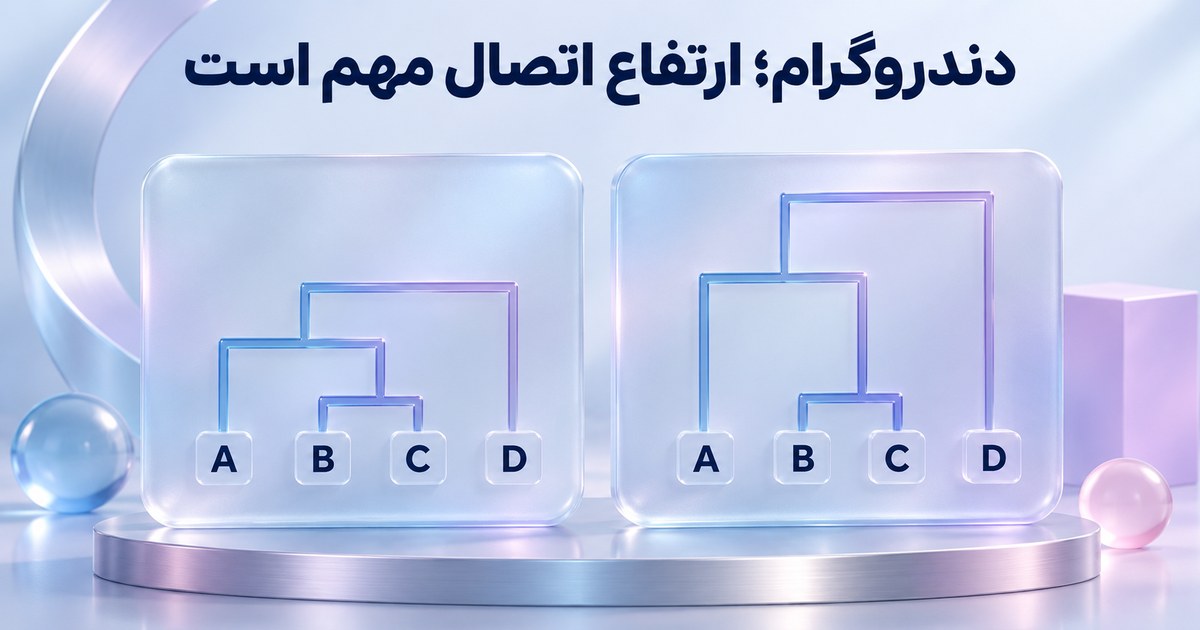
خوشهبندی سلسلهمراتبی، رابطه گروهها را در چند سطح نشان میدهد. در روش تجمعی، ابتدا هر نمونه یک گروه است و در هر مرحله دو گروه نزدیکتر ادغام میشوند. دندروگرام، درخت همین ادغامهاست. انتخاب نحوه اندازهگیری فاصله بین دو گروه، بخشی از الگوریتم است و میتواند ارتفاع ادغامها یا خود گروهها را عوض کند.
برگ و ارتفاع را چگونه بخوانیم؟
برگهای دندروگرام نمونهها هستند؛ ارتفاع یک اتصال، مقدار معیار ادغام در همان مرحله است. ترتیب ظاهری برگها روی محور افقی، بهتنهایی فاصله واقعی دو نمونه را نشان نمیدهد. برای انتخاب گروهها میتوان در یک ارتفاع، درخت را برید؛ این ارتفاع را باید همراه سنجه و linkage ثبت کرد.
چهار نقطه با دو قرارداد فاصله
نقطههای یکبعدی ۰،۲،۳ و۱۰ را در نظر بگیرید. فاصله دو نقطه قدر مطلق اختلاف آنهاست. در Single linkage فاصله دو گروه کمترین فاصله یک جفت عضو از دو طرف است. در Complete linkage بیشترین فاصله میان جفتهای دو طرف را میگیریم. داده در هر دو اجرا یکی است؛ فقط این قرارداد عوض میشود.
در هر دو روش، ابتدا ۲ و۳ با فاصله ۱ ادغام میشوند. سپس در Single فاصله گروه {۲،۳} تا۰ برابر۲ است، ولی در Complete همان فاصله۳ میشود. در مرحله نهایی نیز فاصله {۰،۲،۳} تا۱۰ با Single برابر۷ و با Complete برابر۱۰ است.
| مرحله ادغام | Single | Complete |
|---|---|---|
| ۲ با۳ | 1 | 1 |
| ۰ با گروه {۲،۳} | 2 | 3 |
| ۱۰ با گروه {۰،۲،۳} | 7 | 10 |
اگر در ارتفاع ۲٫۵ ببریم، Single دو گروه {۰،۲،۳} و{۱۰} دارد، اما Complete هنوز سه گروه {۰}،{۲،۳} و{۱۰} دارد. پس «ارتفاع یکسان» بدون نام روش، قاعده یکسان گروهبندی نیست. این مثال به معنی بهتربودن یکی از دو روش برای داده واقعی نیست.
کد ساخت دفتر ادغام
points=[0.0,2.0,3.0,10.0]
def hierarchy(linkage):
    clusters=[(i,) for i in range(len(points))]
    merges=[]
    while len(clusters)>1:
        candidates=[]
        for i in range(len(clusters)):
            for j in range(i+1,len(clusters)):
                ds=[abs(points[a]-points[b]) for a in clusters[i] for b in clusters[j]]
                d=min(ds) if linkage=='single' else max(ds)
                candidates.append((d,clusters[i],clusters[j],i,j))
        d,ca,cb,i,j=min(candidates)
        combined=tuple(sorted(ca+cb))
        merges.append((ca,cb,d))
        clusters=[c for k,c in enumerate(clusters) if k not in (i,j)]+[combined]
        clusters.sort()
    return merges
single=hierarchy('single')
complete=hierarchy('complete')
print('single',single)
print('complete',complete)
assert [d for _,_,d in single]==[1.0,2.0,7.0]
assert [d for _,_,d in complete]==[1.0,3.0,10.0]
کد شماره ردیف از صفر را در دفتر ادغام چاپ میکند، نه مقدار واقعی نقطه را بهعنوان شناسه. برای مثال، ردیفهای ۱ و۲ همان مقدارهای ۲ و۳ هستند. در صورت برابرشدن فاصلهها، ترتیب tupleها تصمیم را تعیین میکند؛ این قرارداد آموزشی را نباید رفتار همه ابزارها فرض کرد.
اتصال زنجیرهای و اندازه گروهها
با Single، نزدیکبودن یک جفت عضو میتواند دو گروه با اعضای دورتر را به هم وصل کند. در Complete، دورترین جفت در فاصله بین گروهها نقش دارد. هیچکدام نام یا معنای تجاری گروه را از فاصله عددی استخراج نمیکنند. برای تمرین، یک نقطه میان۳ و۱۰ اضافه کنید و ببینید دفتر ادغام چطور تغییر میکند.
در K-means مرکزها جابهجا میشوند؛ در این تمرین مرکز میانگین نداریم و فقط گروهها را ادغام کردهایم. سنجش پایداری با ARI مرحله دیگری است که دو تقسیمبندی آماده و همردیف را مقایسه میکند.
قبل از استفاده در تحلیل درخواستها
نمایش داده، سنجه فاصله، روش linkage و ارتفاع یا تعداد گروه را نسخهدار نگه دارید. خواندن چند نمونه از هر گروه برای تفسیر لازم است؛ شکل زیبای درخت، اعتبار دستهها را ثابت نمیکند. برای مسئله پاسخگویی و رسیدگی مشتری، نیاز و نمونههای مجاز را در بررسی مسیر اپرا مطرح کنید؛ این راهنما محصول خوشهبندی آماده یا نتیجه تحلیل مشتریان را اعلام نمیکند.
فایل تمرین و منابع
دریافت کد کامل این تمرین؛ این فایل فقط از کتابخانه استاندارد پایتون استفاده میکند. ورودیهای آن ساختگی و برای بازتولید محاسبهاند؛ اجرای آموزشی آن نتیجه یک محصول یا مشتری را نشان نمیدهد.
تاریخ بررسی منابع: ۳ نوامبر ۲۰۲۶. منابع، مرجع روشاند؛ دادهها، اعداد و کد مثال برای همین راهنما طراحی شدهاند.