
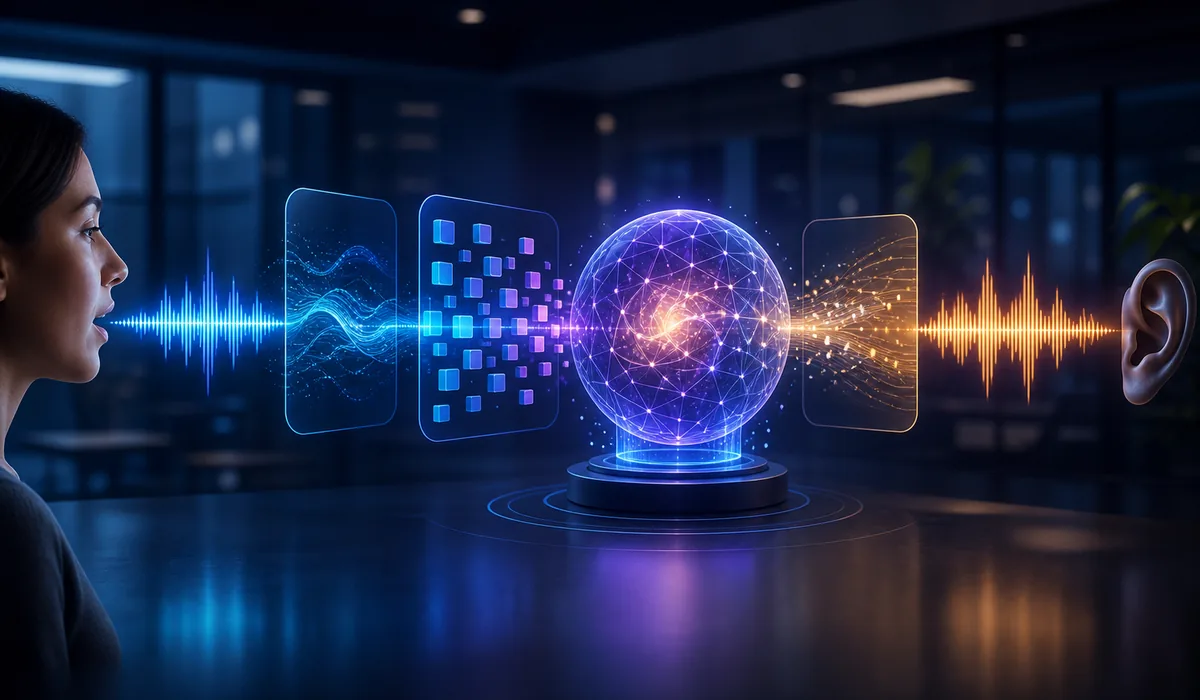
هوش مصنوعی صوتی در ظاهر شبیه یک گفتوگوی ساده است: مشتری حرف میزند و سامانه پاسخ میدهد. اما پشت هر رفتوبرگشت، چند جزء باید همزمان صدا را دریافت کنند، گفتار را بفهمند، زمینه را نگه دارند، تصمیم بگیرند و پاسخ شنیدنی تولید کنند.
شناخت این مسیر برای مدیر محصول یا مرکز تماس مهم است؛ زیرا کیفیت یک تماس فقط به طبیعیبودن صدا بستگی ندارد. تشخیص درست گفتار، زمانبندی پاسخ، دسترسی به اطلاعات معتبر، مدیریت وقفه و تحویل امن به انسان همگی روی تجربه نهایی اثر میگذارند.
صدا چگونه به پاسخ تبدیل میشود؟
مسیر معمول را میتوان به سه مرحله اصلی خلاصه کرد:
- تبدیل گفتار به متن یا STT: صدای تماسگیرنده به کلمات قابل پردازش تبدیل میشود.
- مدل زبانی یا LLM: متن، دستورها، سابقه مکالمه و دادههای مجاز را بررسی میکند و تصمیم میگیرد چه بگوید یا چه اقدامی انجام دهد.
- تبدیل متن به گفتار یا TTS: پاسخ متنی به صوت تبدیل و برای تماسگیرنده پخش میشود.
دو لایه مهم دور این سه مرحله قرار دارند: تشخیص نوبت صحبت و مدیریت وقفه. سامانه باید بفهمد مشتری هنوز در حال فکرکردن است یا جملهاش تمام شده؛ همچنین اگر مشتری وسط پاسخ صحبت کرد، باید گوشدادن را از سر بگیرد.
مرحله اول: ورود صدا از شبکه تلفنی
تماس ابتدا از شبکه تلفن، شماره سازمان یا مسیر SIP وارد سامانه میشود. صدا یک فایل کامل نیست که پس از پایان تماس ارسال شود؛ جریان کوچکی از بستههای صوتی است که پیوسته میرسند. کیفیت شبکه، نوع کدک، نویز محیط و فاصله جغرافیایی میتوانند بر کیفیت این ورودی اثر بگذارند.
در این مرحله سامانه باید مشخص کند کدام صدا متعلق به تماسگیرنده است، سکوت را از گفتار جدا کند و جریان را بدون گمشدن بخشهای مکالمه به موتور تشخیص گفتار برساند. اگر صدای ورودی یکطرفه، بریده یا بسیار ضعیف باشد، حتی بهترین مدل زبانی نیز اطلاعات کافی برای پاسخ درست ندارد.
مرحله دوم: تشخیص فعالیت صوتی و نوبت گفتوگو
تشخیص فعالیت صوتی یا VAD بررسی میکند که آیا در جریان ورودی گفتار وجود دارد یا نه. این بخش ظاهراً ساده است، اما صدای محیط، تنفس، مکث و کلمات کوتاه میتوانند تشخیص را دشوار کنند.
پس از آن، سامانه باید تصمیم بگیرد نوبت مشتری تمام شده است یا خیر. یک آستانه سکوت ثابت ممکن است مشتری را هنگام مکث طبیعی قطع کند یا پاسخ را بیش از حد به تأخیر بیندازد. مدل نوبتگیری بهتر، صدا، متن ناقص و زمینه مکالمه را با هم در نظر میگیرد.
این مرحله یکی از تفاوتهای اصلی میان دموی خوب و تجربه پایدار است. صدای بسیار طبیعی نیز اگر مدام روی حرف مشتری بیاید یا پس از هر جمله مکث نامعمول داشته باشد، مکالمه را مصنوعی نشان میدهد.
مرحله سوم: تبدیل گفتار به متن
موتور تبدیل گفتار به متن، جریان صوتی را به واژهها تبدیل میکند. در سامانه بلادرنگ، موتور منتظر پایان کامل جمله نمیماند و رونوشتهای موقت تولید میکند. با رسیدن صدای بیشتر، این متنها اصلاح و کامل میشوند.
دقت این مرحله به عوامل مختلفی وابسته است:
- لهجه و شیوه تلفظ تماسگیرنده؛
- سرعت صحبت و مکثهای طبیعی؛
- کیفیت خط، پژواک و صدای پسزمینه؛
- نامهای خاص، شمارهها و اصطلاحات تخصصی؛
- زبان یا جابهجایی میان دو زبان در یک جمله.
برای ارزیابی، فقط تماسهای آرام آزمایشگاهی کافی نیست. نمونههای واقعی مانند تماس از خیابان، بلندگوی خودرو، صدای کم، تلفظهای مختلف و اصلاح جمله باید در مجموعه آزمون وجود داشته باشند.
مرحله چهارم: مدل زبانی چه چیزی را میبیند؟
مدل زبانی فقط آخرین جمله را دریافت نمیکند. معمولاً چند نوع ورودی در اختیار آن قرار میگیرد: دستور اصلی ایجنت، تاریخچه مکالمه، اطلاعات بازیابیشده از منابع مجاز و فهرست اقدامهایی که اجازه انجام آنها را دارد.
برای مثال، مشتری میپرسد «سفارشم کجاست؟». مدل باید تشخیص دهد ابتدا به شناسه سفارش نیاز دارد، سپس از ابزار مجاز وضعیت را بگیرد و پاسخی متناسب با نتیجه بسازد. اگر داده معتبر در دسترس نباشد، نباید وضعیت را حدس بزند.
یک پایگاه دانش قابل نگهداری میتواند سیاستها و پاسخهای تأییدشده را در اختیار سامانه قرار دهد. کیفیت پاسخ به کیفیت و تازگی همین محتوا وابسته است؛ سندهای متناقض یا قدیمی، پاسخ متناقض تولید میکنند.
پاسخدادن یا انجامدادن یک کار
مدل گاهی پاسخ متنی میسازد و گاهی یک تابع یا ابزار را فراخوانی میکند. بررسی موجودی، ثبت درخواست یا واکشی پرونده نمونههایی از اقداماند. برای هر اقدام باید ورودی مجاز، تأیید لازم، مدیریت خطا و سطح دسترسی روشن باشد.
تصمیمهای حساس مانند تغییر مالی، افشای اطلاعات شخصی یا پذیرش استثنای سیاستی نباید صرفاً به یک پاسخ آزاد مدل واگذار شوند. قواعد قطعی و در صورت نیاز تأیید انسانی باید دور مدل قرار گیرند.
مرحله پنجم: تبدیل متن به گفتار
پس از تولید پاسخ، موتور تبدیل متن به گفتار آن را به صوت تبدیل میکند. انتخاب صدا فقط موضوع سلیقه نیست. وضوح، سرعت، مکث، تلفظ نامها، اعداد و واژههای تخصصی باید با سناریوی تماس سازگار باشند.
پاسخهای طولانی حتی با صدای طبیعی خستهکنندهاند. متن مناسب تماس باید کوتاه، مرحلهای و قابل قطع باشد. اگر چند گزینه وجود دارد، بهتر است سامانه آنها را دستهبندی کند و پس از هر بخش فرصت پاسخ بدهد.
چرا پخش جریانی یا Streaming اهمیت دارد؟
اگر هر مرحله منتظر تکمیل مرحله قبلی بماند، میان صحبت مشتری و پاسخ مکث زیادی ایجاد میشود. در معماری جریانی، تشخیص گفتار پیش از پایان کامل جمله متن موقت میسازد، مدل پاسخ را تدریجی تولید میکند و موتور صوتی نیز پیش از کاملشدن همه متن، پخش را آغاز میکند.
بااینحال، سرعت نباید به قیمت پاسخ اشتباه باشد. سامانه باید در جاهایی که به داده خارجی، تأیید یا محاسبه نیاز است مکث طبیعی ایجاد کند و وضعیت را شفاف بگوید. هدف حذف هر مکث نیست؛ هدف حذف سکوت بیدلیل و قابل پیشگیری است.
مدیریت وقفه و صحبت همزمان
مشتری ممکن است وسط پاسخ بگوید «نه، منظورم فرداست». سامانه باید پخش صدا را متوقف کند، بخش شنیدهشده پاسخ را در زمینه نگه دارد و گفته جدید را پردازش کند. اگر صوت قبلی ادامه پیدا کند، مشتری احساس میکند شنیده نمیشود.
در مقابل، کلمات کوتاهی مانند «بله»، «درست است» یا صدای پسزمینه همیشه به معنای قطعکردن نیستند. قواعد وقفه باید با نوع مکالمه آزمایش شوند. تماس فروش، پشتیبانی فنی و دریافت اطلاعات ممکن است رفتار متفاوتی نیاز داشته باشند.
اطلاعات بیرونی و فراخوانی ابزارها
برای پاسخ عملی، ایجنت اغلب باید به سامانه دیگری متصل شود. این اتصال میتواند وضعیت سفارش را بخواند، درخواست ثبت کند یا زمان خالی را بررسی کند. مستندات فنی باید ورودی و خروجی هر ابزار، خطاهای احتمالی و زمان انقضا را روشن کند.
مدل نباید مستقیماً به هر دادهای دسترسی داشته باشد. کمینهسازی دسترسی، ثبت رویداد، پوشاندن داده حساس و تفکیک محیط آزمایش از واقعی از الزامات طراحیاند. هنگام خطا نیز پاسخ باید صادقانه باشد و مسیر جایگزین ارائه دهد.
چه زمانی تماس باید به انسان منتقل شود؟
هدف یک سامانه صوتی، جلوگیری مطلق از رسیدن تماس به انسان نیست. درخواست خارج از دامنه، ابهام تکراری، تصمیم حساس، نارضایتی شدید یا درخواست صریح مشتری میتواند دلیل انتقال باشد.
در طراحی انتقال تماس به اپراتور، فقط شماره مقصد مهم نیست. خلاصه مسئله، اطلاعات تأییدشده، اقدامهای انجامشده و دلیل انتقال باید همراه تماس باشد تا مشتری مجبور به تکرار همه چیز نشود.
محدودیتها و خطاهای محتمل
- خطای شنیداری: نام، عدد یا واژه تخصصی اشتباه تشخیص داده میشود.
- پاسخ بیپایه: مدل در نبود منبع معتبر، پاسخی محتمل اما نادرست میسازد.
- قطع زودهنگام: سامانه مکث طبیعی را پایان جمله فرض میکند.
- تأخیر ابزار: سامانه بیرونی دیر پاسخ میدهد و مکالمه بدون توضیح میماند.
- ازدسترفتن زمینه: پس از چند رفتوبرگشت، بخشی از اطلاعات قبلی نادیده گرفته میشود.
- دسترسی نامناسب: ابزار یا دادهای بیش از نیاز در اختیار ایجنت قرار میگیرد.
هیچیک از این موارد فقط با انتخاب صدای بهتر حل نمیشود. طراحی سناریو، داده معتبر، آزمون واقعی، پایش و بازبینی انسانی اجزای ضروریاند.
چگونه ایجنت هوش مصنوعی صوتی را ارزیابی کنیم ؟
- آیا لهجهها، نویز و تلفظ نامهای واقعی را درست مدیریت میکند؟
- آیا هنگام مکث طبیعی صبر میکند و روی حرف مشتری نمیآید؟
- آیا پاسخ از منبع معتبر میآید و در نبود داده، حدس نمیزند؟
- آیا درخواست حساس را تأیید یا به انسان ارجاع میدهد؟
- آیا خطای ابزار بیرونی به مسیر امن و قابل فهم منجر میشود؟
- آیا پس از وقفه، گفتوگو بدون تکرار بیدلیل ادامه پیدا میکند؟
- آیا لاگ و رونوشت برای بررسی کیفیت در دسترس افراد مجاز است؟
- آیا مشتری در صورت درخواست میتواند به اپراتور برسد؟
برای شناخت اجزای یک ایجنت صوتی هوش مصنوعی، این چکلیست را با سناریوهای واقعی سازمان ترکیب کنید. دموی ازپیشتمرینشده نمیتواند رفتار سامانه در تماس نامنظم را نشان دهد.
جمعبندی
هوش مصنوعی صوتی یک زنجیره بلادرنگ است: صدا وارد میشود، فعالیت صوتی و پایان نوبت تشخیص داده میشود، گفتار به متن تبدیل میشود، مدل زبانی بر اساس دستور و داده معتبر تصمیم میگیرد و پاسخ دوباره به صوت برمیگردد.
کیفیت نهایی حاصل هماهنگی همه این اجزاست. برای ارزیابی، به صدا بهتنهایی گوش نکنید؛ دقت شنیدن، زمانبندی، منبع پاسخ، مدیریت وقفه، امنیت ابزار و تحویل به انسان را هم بسنجید.