
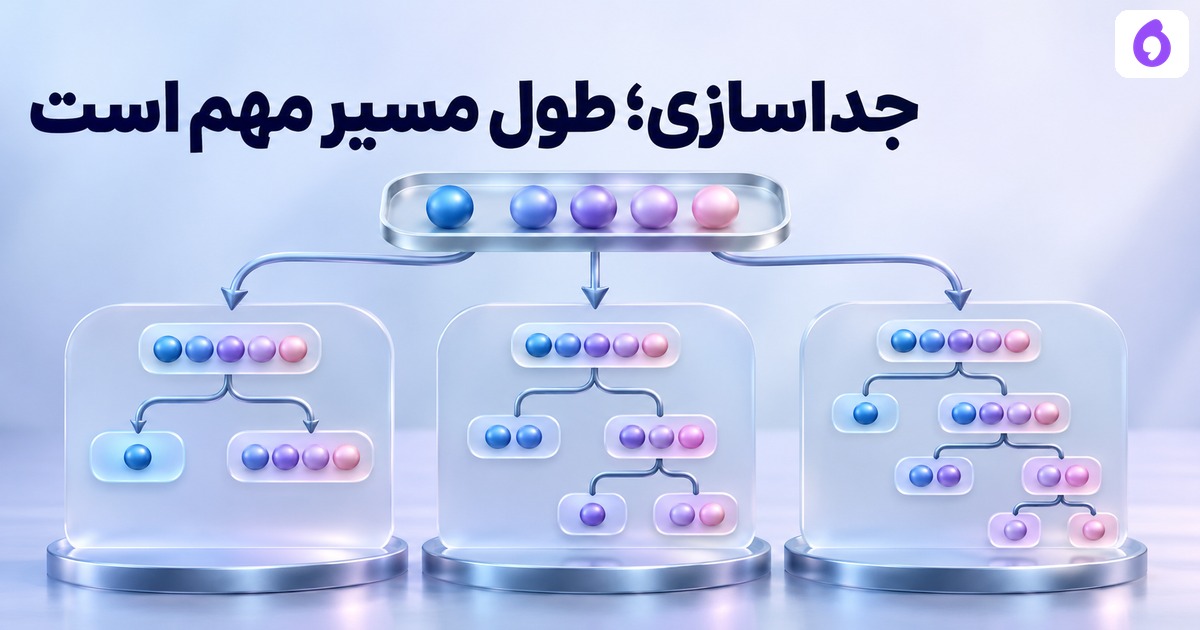
Isolation Forestداده را با تقسیمهای تصادفی جدا میکند؛ نقطهای که در چند درخت با مسیر کوتاهتری به برگ برسد، میتواند برای بررسیِ ناهنجاری جالب باشد. این با «عضوِ خوشه نشدن» یا بزرگبودنِ خطای بازسازی یکسان نیست. برای دیدن سازوکار، سه درختِ یکبعدیِ آموزشی میسازیم و عمقِ برگ را واقعاً میشماریم.
پنج نقطه و تقسیمِ قابل بازتولید
دادههای اصیل۰،۱،۲،۳و۱۰هستند. هر گره فقط یک ویژگی دارد، پس شمارهٔ ویژگی همیشه صفر است. مرز از فاصلهٔ بین کمینه و بیشینهٔ نقاطِ همان گره انتخاب میشود؛ برای بازتولید دقیقِ این مثال، سهمِ مرز یکی از۹۹۹کسرِ یکهزارم تا۹۹۹هزارم است. این انتخاب روی شبکهٔ محدود است، نه نمونهگیریِ پیوستهٔ کاملِ پیادهسازی مرجع.
عددهای آغازگرِ تصادفی۷،۱۱و۱۹برای سه درختاند. سمت چپ مقادیرِ کوچکتر از مرز و سمت راست مقادیرِ بزرگتر یا مساوی آناند. تقسیم تا تکنمونهشدن یا یکسانشدنِ همهٔ مقدارهای برگ ادامه مییابد. همهٔ نقاط در هر درخت حاضرند و سقف عمق و زیرنمونهگیریِ نسخههای تولیدی را اجرا نکردهایم.
خروجیِ واقعی سه درخت
عمقِ ریشه صفر است و هر تقسیم یک واحد اضافه میکند. فایل JSONتمامِ گرهها و کسرِ مرز را دارد؛ جدول زیر از همان اجرای کد ساخته شده است. میانگین، فقط میانگینِ عمقِ برگِ این سه درخت است.
| مقدار | عمق در سه درخت | میانگینِ دقیق |
|---|---|---|
| 0 | 3, 4, 2 | 3 |
| 1 | 4, 4, 4 | 4 |
| 2 | 4, 3, 4 | 11/3 |
| 3 | 2, 2, 3 | 7/3 |
| 10 | 1, 1, 1 | 1 |
از این جدول آستانهٔ عمومیِ تشخیص تقلب یا مجوز حذف داده نمیسازیم. تغییرِ نمونه، آغازگر یا قاعدهٔ ساخت میتواند طول مسیرها را عوض کند. نقطهٔ دورافتاده ممکن است کاملاً معتبر باشد؛ علتِ عملیِ آن به اطلاعاتِ مسئله نیاز دارد.
برگِ چندنمونهای را پنهان نکنیم
اگر ورودی[۱،۱]باشد، هیچ مرزی دو مقدارِ یکسان را جدا نمیکند؛ کد یک برگ با دو شناسه و عمق صفر میسازد. این صفر یعنی درختِ ما آنها را تفکیک نکرده، نه اینکه هر دو ناهنجاری قطعیاند. در امتیازِ استاندارد Isolation Forest، برگِ چندنمونهای و نرمالسازیِ طول مسیر قراردادهای تکمیلی دارند؛ این تمرین آن امتیاز را حساب نمیکند.
همچنین میانگینِ عمق را score_samplesیا decision_functionکتابخانه نمینامیم. هیچ sklearn.IsolationForestاجرا نشده است. دادهٔ خالی و مقدار نامتناهی یا غیرعددی رد میشود؛ تکنقطه و دو مقدارِ یکسان جدا کنترل شدهاند. تصادفیبودنِ تقسیم، صحتِ نهاییِ برچسب را تضمین نمیکند.
تفاوت با دو روشِ نزدیک
DBSCAN با تراکم و اتصالِ همسایهها کار میکند؛ خروجیِ noiseدر آن، طول مسیرِ درخت نیست. Autoencoder نیز خطای بازسازی دارد. این سه عدد را بدون قرارداد و ارزیابی روی دادهٔ نماینده قابل جایگزینی فرض نکنید.
برای کاربرد واقعی ابتدا معلوم کنید هشدار به چه رسیدگیِ انسانی منتهی میشود و خطای مثبتِ کاذب چه هزینهای دارد؛ این فایل آموزشی روی دادهٔ مشتری چیزی را حذف یا برچسبگذاری نمیکند. برای ادامهٔ مفاهیم به راهنمای هوش مصنوعی بروید. اجرای این درختها به معنی ارائهٔ سرویس آمادهٔ کشف تقلب از سوی اپرا نیست.
فایل تمرین و منبع
ساخت واقعی سه درخت و ثبتِ طول مسیر هر نقطه · گرهها، مرزِ تقسیم و عمقِ برگِ هر سه درخت
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.