
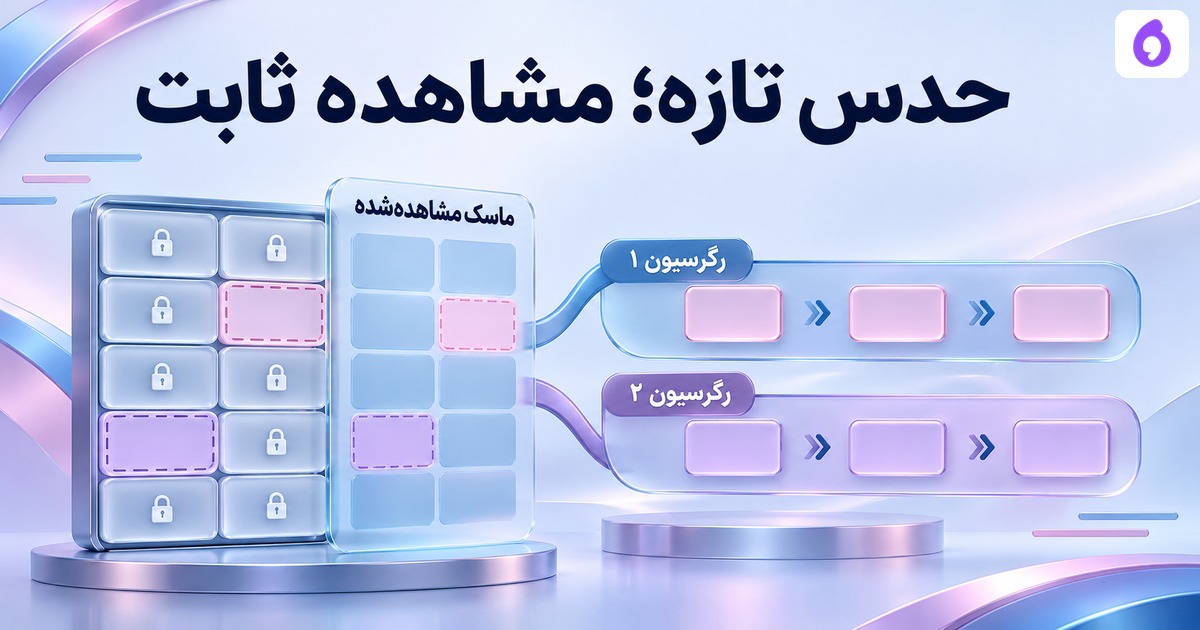
جایگزینیِ تکراریِ مقدارِ گمشده میتواند هر ستون را با استفاده از ستونهایِ دیگر تخمین بزند و این کار را چند دور تکرار کند. حدسِ یک خانه ممکن است به حدسِ ستونِ دیگر وابسته باشد. برایِ دیدنِ سازوکار، در این تمرینِ دوستونه دو رگرسیونِ ساده را نوبتی برازش میدهیم؛ مشاهدههایِ اصلی در تمامِ دورها ثابت میمانند.
جدولِ ناقصِ دستساز
پنج ردیفِ آموزش عبارتاند از [۱،۴]،[۲،ناموجود]،[ناموجود،۱۰]،[۴،۱۳] و[۵،۱۶]. برایِ ساختِ مثال، نویسنده رابطهٔ 3x+1 را در نظر گرفته است؛ اما دو مقدارِ پنهانِ هفت و سه به تابعِ برازش داده نمیشوند و فقط پس از پایان برایِ کنترلِ تمرین استفاده میشوند. این رابطه، دادهٔ واقعی یا شاهدِ صحتِ روش در جهان نیست.
برایِ شروع، میانگینِ مشاهدهشدهٔ هر ستون را میگذاریم: سه برایِ ستونِ اول و ۱۰٫۷۵ برایِ دوم. همزمان ماسکِ اصلیِ خانههایِ ناموجود را جدا نگه میداریم. پس برنامه میداند کدام عدد مشاهده بوده و کدام فقط مقدارِ آغازینِ حدس است؛ پُرشدنِ خانه، منشأ آن را عوض نمیکند.
یک دور شاملِ دو برازش است
ابتدا ستونِ اول هدف و ستونِ دومِ تکمیلشدهٔ فعلی، پیشبین است. فقط ردیفهایی که هدفِ ستونِ اولشان در دادهٔ اصلی معلوم بود واردِ OLS میشوند. خطِ حاصل، خانهٔ ناموجودِ همان ستون را پیشبینی میکند. سپس نوبتِ ستونِ دوم میرسد و از مقدارهایِ فعلیِ ستونِ اول استفاده میکند؛ باز هم هدفها فقط از خانههایِ واقعاً مشاهدهشدهاند.
این ترتیبِ نوبتی بخشی از قرارداد است و در trace ثبت میشود. دادههایِ پیشبین میتوانند حدسِ بهروزِ خانهٔ دیگر باشند، اما هدفِ ساختگی را بهعنوانِ مشاهده وارد نکردهایم. برایِ هر برازش، شناسهٔ ردیفهایِ هدفِ معلوم، شیب، عرض از مبدأ و محلِ خانههایِ تغییرکرده در JSON آمده است.
چه چیزی تا توقف تغییر کرد؟
در هر دور بیشترینِ تغییرِ مطلقِ خانهها نسبت به دورِ قبل حساب میشود. اگر از یکمیلیاردم کمتر شود، در همین قرارداد توقف میکنیم؛ سقفِ چهل دور هم جدا تعیین شده است. اجرایِ واقعی پس از 10 دور به این شرط رسید. جدول، دو دورِ نخست و دورِ پایانی را نشان میدهد؛ فایل همهٔ دورها را نگه داشته است.
| دور | حدسِ ردیفِ دوم،ستونِ دوم | حدسِ ردیفِ سوم،ستونِ اول | بیشترین تغییر |
|---|---|---|---|
| 1 | 7.296489564 | 2.684684685 | 3.45 |
| 2 | 7.021556727 | 2.975062066 | 0.29 |
| 10 | 7.000000000 | 3.000000000 | 2.22e-10 |
در این دادهٔ طراحیشده، دو حدس به هفت و سه نزدیک میشوند. این نتیجهٔ خوب از رابطه و الگویِ غیبتِ همین تمرین جدا نیست. رسیدن به شرطِ توقف، درستبودنِ عددِ گمشده یا یکتابودنِ جواب را ثابت نمیکند؛ در مسئلهٔ دیگر میتواند حدسِ پایدار ولی نامناسب داشته باشیم.
مشاهده و مقدارِ جایگزینشده را جدا نگه داریم
کد پس از هر دور کنترل میکند هیچ خانهٔ مشاهدهشدهٔ اصلی عوض نشده باشد. ستونی که تماماً ناموجود است رد میشود؛ میانگینِ ساختگیِ صفر برایِ آن اختراع نمیکنیم. رگرسیون هم به حداقلِ دو هدفِ معلوم و پیشبینِ غیرثابت نیاز دارد. این محدودیتها را بهجایِ علامتِ موفقیتِ ظاهری گزارش میکنیم.
علتِ نبودِ داده همچنان مهم است. اگر غیبت به خودِ مقدارِ پنهان یا فرایندِ ثبت وابسته باشد، دو خطِ رگرسیون آن سازوکار را خودکار حل نمیکنند. همبستگیِ ناشی از حدسهایِ مشترک و اطمینانِ بیش از حد هم باید در ارزیابیِ واقعی بررسی شوند.
این تمرین، multiple imputation نیست
فقط یک تکمیلِ قطعی تولید کردهایم؛ نمونهگیریِ پسین، چند جدولِ تکمیلشده و تجمیعِ عدمقطعیت انجام نشده است. مدلِ هر ستون OLSِ خودمان است، نه تنظیماتِ پیشفرضِ sklearn.IterativeImputer. منبعِ اصلی، تفاوتِ روشِ چندستونه و تکستونه و تکمیلِ واحد و چندگانه را توضیح میدهد؛ کتابخانه اینجا اجرا نشده است.
این تابع رویِ ماتریسِ آموزشِ مثال کار میکند و مسیرِ transformِ دادهٔ جدا را پیاده نکرده است. در یک خطِ لولهٔ واقعی، برازش و دنبالهٔ تبدیل باید داخلِ آموزشِ همان تقسیم بمانند؛ اتصالِ بیبررسیِ آزمون به این ماتریس مجاز نیست. سیاستِ مقدارِ گمشده معنیِ نبود و انتخابِ روش را جدا بررسی میکند.
برایِ سنجشِ دادهٔ تحلیلِ تماس، منشأِ خانهٔ خالی و معیارِ خروجی را در درخواستِ بررسیِ اپرابین روشن کنید. دقتِ مدلِ پاییندستی، دادهٔ مشتری و روشِ داخلیِ محصول در این تمرین آزمایش نشدهاند.
فایل تمرین و منبع
دو رگرسیونِ شرطی را تا توقف، فقط رویِ هدفهایِ مشاهدهشده برازش دهید · ماسکِ اصلی، هر ضریب، خانهٔ تغییرکرده و شرطِ توقفِ واقعی
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.