
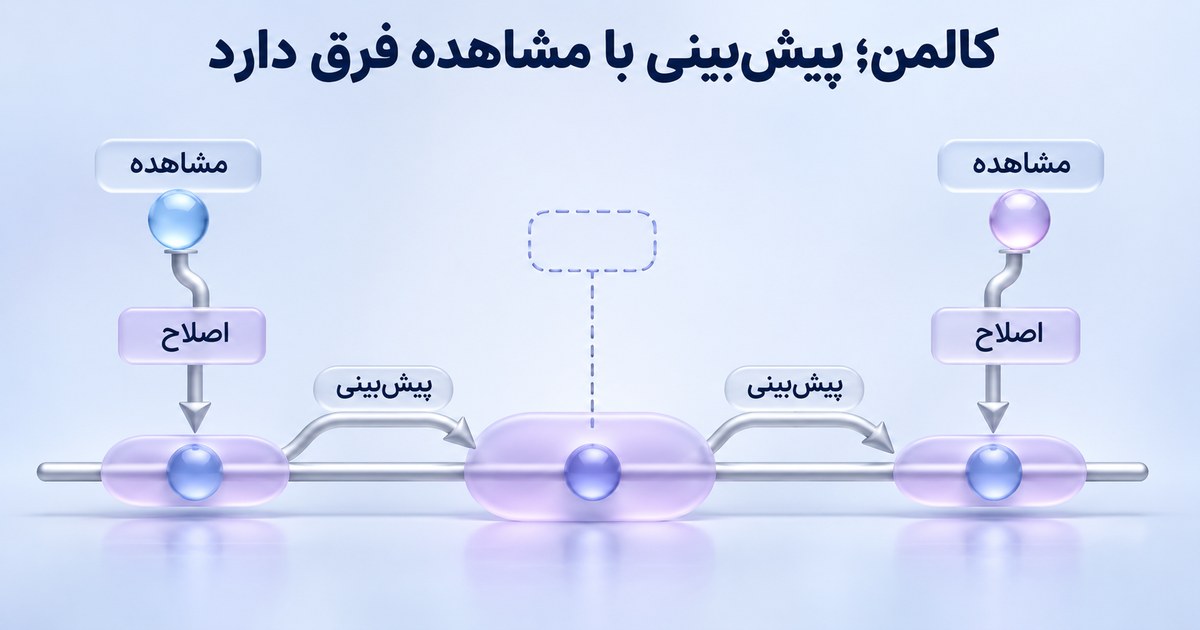
فیلترِ کالمن در مدلِ خطی، برآوردِ حالت و عدمقطعیتِ آن را ابتدا پیشبینی و بعد با مشاهده اصلاح میکند. وزنِ مشاهده از واریانسهایِ فرضشده محاسبه میشود؛ صرفاً یک آلفایِ ثابتِ انتخابی نیست. این صفحه سه مرحلهٔ یک مدلِ یکبعدیِ ساختگی را با کسرهایِ دقیق اجرا میکند و نبودِ مشاهده را صفر فرض نمیکند.
مدل را پیش از فرمول بنویسیم
حالتِ بعدی برابرِ حالتِ قبلی بهعلاوهٔ نویزِ فرایند و مشاهده برابرِ حالت بهعلاوهٔ نویزِ اندازهگیری فرض شده است؛ F=H=۱ و ورودیِ کنترلی صفر است. میانگینِ آغازین۱۰، واریانسِ آغازین P=۴، واریانسِ فرایندِ هر گام Q=۱ و واریانسِ مشاهده R=۴ را خودمان انتخاب کردهایم. فاصلهٔ زمانیِ هر مرحله یک واحدِ ثابت فرض میشود.
نویزها را صفرمیانگین و از هم و حالتِ آغازین مستقل فرض میکنیم. برایِ تفسیرِ کاملِ توزیعِ پسین در مدلِ معمولِ خطیِ گاوسی، فرضِ گاوسی هم لازم است؛ این تمرین دادهٔ تصادفی تولید یا آن فرض را از داده اثبات نمیکند. Q و R واریانساند، نه انحرافِ معیار؛ آنها را از فایلِ صوتی یا مشتری استخراج نکردهایم.
پیشبینی و اصلاح دو لحظهٔ متفاوتاند
x_prior = x_previous
P_prior = P_previous + Q
innovation = z - x_prior
S = P_prior + R
K = P_prior / S
x_post = x_prior + K * innovation
P_post = (1-K)**2 * P_prior + K**2 * R
دو خطِ اول پیش از استفاده از مشاهدهٔ تازه اجرا میشوند. innovation اختلافِ مشاهده با پیشبینیِ مشاهده است و S واریانسِ همین اختلاف در فرضهایِ مدل است. در این حالتِ یکبعدی، فرمولِ آخر با(۱−K)P_prior برابر میشود؛ کد هر دو شکل را با حسابِ دقیق مقایسه میکند. این تساوی به معنیِ یکسانبودنِ رفتارِ عددیِ همهٔ پیادهسازیهایِ ممیزشناور نیست.
مشاهدهٔ۱۲ چگونه برآوردِ۱۰ را عوض میکند؟
در مرحلهٔ اول priorِ میانگین۱۰ و واریانس۵ است. مشاهدهٔ۱۲، innovationِ۲ میدهد؛ S=۹ و K=۵÷۹ میشود. میانگینِ اصلاحشده۱۰+(۵÷۹)×۲=۱۰۰÷۹، حدود۱۱٫۱۱۱۱ است. واریانسِ پسین۲۰÷۹، حدود۲٫۲۲۲۲ میشود. وزنِ مشاهده از۵و۴ آمده؛ از کوچک یا بزرگ بودنِ خودِ مشاهده انتخاب نشده است.
مرحلهٔ دوم مشاهده ندارد. فقط پیشبینی انجام میشود: میانگین همان۱۰۰÷۹ میماند ولی واریانس با افزودنِQبه۲۹÷۹ میرسد. فیلدهایِ K و S و innovation در دفتر null هستند؛ نه بهرهٔ صفرِ یک مشاهدهٔ واقعی. دادهٔ ناموجود را در این مدل با اندازهگیریِ عددِ صفر عوض نمیکنیم.
مرحلهٔ سوم را با همان ترتیب ادامه بدهیم
پیش از مشاهدهٔ۱۱، واریانسِ prior برابرِ۳۸÷۹ و S=۷۴÷۹ است؛ K=۱۹÷۳۷ و innovation=−۱÷۹ میشود. میانگینِ تازه۴۰۹÷۳۷، حدود۱۱٫۰۵۴۱ و واریانس۷۶÷۳۷، حدود۲٫۰۵۴۱ است. بهرهٔ۵÷۹ در مرحلهٔ اول و۱۹÷۳۷ در مرحلهٔ سوم یکسان نیست، چون عدمقطعیتِ ورودیِ اصلاح تغییر کرده است.
| مرحله | مشاهده | P پیش از اصلاح | K | میانگینِ خروجی | P خروجی |
|---|---|---|---|---|---|
| ۱ | ۱۲ | ۵ | ۵÷۹ | ۱۰۰÷۹ | ۲۰÷۹ |
| ۲ | ناموجود | ۲۹÷۹ | محاسبه نشد | ۱۰۰÷۹ | ۲۹÷۹ |
| ۳ | ۱۱ | ۳۸÷۹ | ۱۹÷۳۷ | ۴۰۹÷۳۷ | ۷۶÷۳۷ |
اگر اعتمادِ فرضی به مشاهده را تغییر دهیم
فقط برایِ همان مرحلهٔ اول، با R=۱ بهره۵÷۶ و با R=۹ بهره۵÷۱۴ میشود. در این قرارداد، واریانسِ کمترِ مشاهده وزنِ بیشتری به آن میدهد. این دو مقدار انتخابِ آموزشیاند؛ کاهشِ دلخواهِ R، اندازهگیری را در دنیایِ واقعی دقیقتر نمیکند. اگر مدلِ نویز غلط باشد، خروجیِ ظاهراً مطمئن میتواند گمراهکننده باشد.
واریانس در مرحلهٔ بیمشاهده از۲۰÷۹ به۲۹÷۹ افزایش یافت. پس «کالمن همیشه با گذشتِ زمان عدمقطعیت را کمتر میکند» درست نیست. کاهشِ واریانس پس از یک مشاهده در همین فرضها، شاهدِ کاهشِ خطایِ واقعیِ هر نمونه هم نیست؛ آن خطا به حالتِ واقعیِ معلوم نیاز دارد که اینجا نداریم.
فایل چه چیزهایی را آزمایش نکرده است؟
سه ورودیِ Pمنفی، Qمنفی و Rصفر در قراردادِ محدودِ ابزار رد میشوند. صفر بودنِ R در همهٔ مدلها ممنوع نیست؛ این فایل برایِ سادگی Rمثبت میخواهد. حالتِ چندبعدی، زمانِ نامنظم، نویزِ همبسته، تشخیصِ دادهٔ پرت و تخمینِQ/R در آن پیاده نشده است. FilterPy اجرا نشده؛ مستندات و بخشِ مربوطِ کدِ آن مرجعِ ترتیبِ predict/update و نبودِ مشاهده بودهاند.
هموارسازیِ نمایی در تمرینِ خودش آلفایِ ثابت دارد؛ اینجا واریانس و بهره از مدل و مرحلهٔ پیشبینی میآیند. این آموزش حذفِ نویزِ گفتار یا قابلیتِ اثباتشدهٔ محصولِ اپرا نیست. اگر نیازِ واقعیِ شما پاسخگویی یا پیگیریِ مشتری است، ورودی و نتیجهٔ قابلِ آزمایش را در راهکارهایِ اپرا مشخص کنید.
فایل تمرین و منبع
سه مرحلهٔ کسری، مشاهدهٔ ناموجود و مقایسهٔ R؛ Python · دفترِ prior، innovation، S، K و posterior با فرضهایِ مدل
- FilterPy؛ معنایِ حالت و P/Q/R و ترتیبِ پیشبینی و اصلاح
- کدِ اصلیِ FilterPy؛ بخشِ update و predict و حفظِ prior در نبودِ مشاهده، بدونِ اجرایِ کتابخانه
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.