
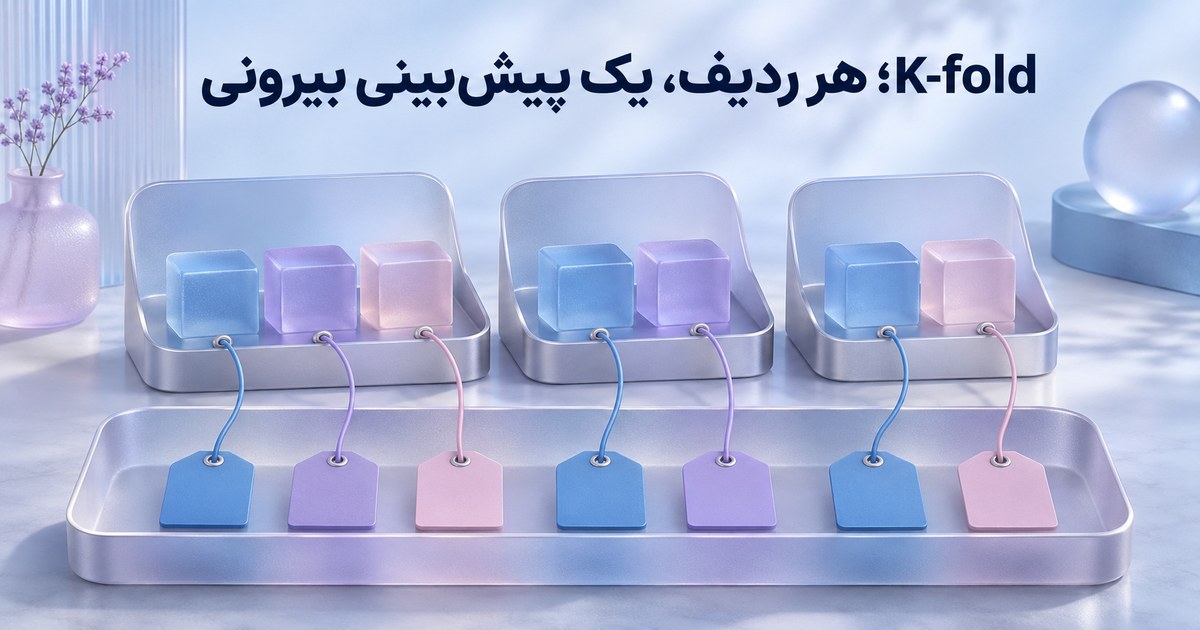
در اعتبارسنجیK-fold،هر بخش یک نوبت کنار گذاشته میشود و مدل روی بخشهای باقیمانده برازش میگیرد. پیشبینی خارج ازfoldیاOOFبرای هر ردیف از مدلی میآید که همان ردیف را در آموزش ندیده است. اما میانگین سادهٔ امتیازِfoldها همیشه با امتیازِ همهٔOOFها برابر نیست؛ با هفت ردیف و سه بخش نابرابر آن را دقیق حساب میکنیم.
برنامهٔ سهfoldرا روشن کنیم
هدفهای ساختگی بهترتیب۰،۰،۰،۰،۰،۰و۷هستند. شناسهٔ ردیفها از۰تا۶است. foldاول ردیفهای۰،۱،۲؛دوم۳،۴؛وسوم۵،۶را کنار میگذارد. اندازهها۳،۲،۲هستند و shuffleنداریم. این تقسیم نمونهٔ آموزشی است،نه توصیه برای دادهٔ زمانی یا مشتریهای تکراری.
خطمبنای هر دور فقط میانگینِyدر بخش آموزش را پیشبینی میکند. پس برای دور اول میانگین۷/۴،برای دوم۷/۵وبرای سوم صفر است. همهٔ ردیفهای کنارگذاشتهشدهٔ هر دور همان پیشبینی ثابتِ آن دور را میگیرند. هیچ پارامتری با استفاده ازyهمان بخشِ کنارگذاشتهشده انتخاب نشده است.
یک پیشبینی برای هر ردیف
| دور | ردیفهای کنارگذاشتهشده | پیشبینیِ میانگین آموزش | MSEهمان بخش |
|---|---|---|---|
| ۱ | ۰،۱،۲ | 1.75 | 3.0625 |
| ۲ | ۳،۴ | 1.4 | 1.96 |
| ۳ | ۵،۶ | 0 | 24.5 |
در دور سوم،دو هدف۰و۷هستند؛جمع مربع اختلاف۴۹وMSEبرابر۲۴٫۵است. فایلCSVهر هفت پیشبینی و خطای ردیف را دارد. هر ردیف دقیقاً یک بارOOFگرفته است؛این پیشبینیها از یک مدل واحدِ آموزشدیده روی همهٔ داده نیامدهاند.
میانگین دورها یا میانگین ردیفها؟
میانگین سادهٔ سهMSEبرابر۹٫۸۴۰۸۳۳است. اگر هر ردیف وزن برابر داشته باشد،باید امتیازِ هرfoldرا با تعداد ردیف آن وزن دهیم: (3×3.0625 + 2×1.96 + 2×24.5)/7 = 8.8725. محاسبهٔMSEروی هفتOOFهم دقیقاً۸٫۸۷۲۵میشود.
این برابری به تجزیهپذیربودنMSEبه خطای ردیفها و همین وزندهی مربوط است. همهٔ معیارها،مثل سنجههای رتبهبندیِ زوجی،این قرارداد را ندارند. از نتیجهٔ این مثال،برابری همیشگیِ pooledOOFو میانگین امتیازها را نتیجه نگیرید. مستنداتcross_val_predictهم دربارهٔ تفاوت اندازهٔ بخشها و نوع معیار هشدار میدهد.
این امتیاز چه چیزی را ثابت نمیکند؟
عددِ نمونه دربارهٔ همین هفت هدف و خطمبنای دستساز است؛کیفیت پروژهٔ واقعی را نشان نمیدهد. اگر دادهها به یک فرد،زمان یا سند مشترک وابسته باشند،جداشدن شمارهٔ ردیف برای استقلال کافی نیست. همهٔ تبدیلهای آموختنیِ ورودی هم باید فقط داخل بخش آموزشِ هر دور برازش شوند.
اعتبارسنجی تودرتو مسئلهٔ انتخاب تنظیم و آزمون بیرونی را جدا حل میکند. این صفحه حلقهٔ انتخاب تنظیم ندارد؛موضوعش نسبتِ هر پیشبینی باfoldو روش درستِ جمعکردن امتیاز بخشهای نابرابر است. انتخاب بهترین روش با دیدن مکررOOFنیز میتواند ارزیابی بعدی را تحت تأثیر قرار دهد.
کد و ادامهٔ تمرین
PythonباFractionمیانگینهای سه بخش،پوشش یکبارهٔ هر ردیف و دو امتیاز۸٫۸۷۲۵و۹٫۸۴۰۸۳۳را واقعاً کنترل کرده است. فقط خطمبنای میانگین محاسبه شده و هیچ کتابخانهٔ مدل یا دادهٔ مشتری استفاده نشده است. برای تمرین،سهfoldهماندازه روی دادهٔ تازهٔ ساختگی تعریف و تفاوت دو تجمیعِMSEرا دوباره بررسی کنید.
برای ادامهٔ مبانی و انتخاب موضوع بعدی، صفحهٔ هوش مصنوعی را ببینید. این مثال روش ارزیابی یا نتیجهٔ کیفیت محصولات اپرا را اعلام نمیکند.
فایل تمرین و منبع
هفت پیشبینیِ خارج ازfoldبا خطمبنای میانگینِ همان آموزش · کد مستقلِ پوشش هر ردیف و دو روش تجمیعMSE
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.