
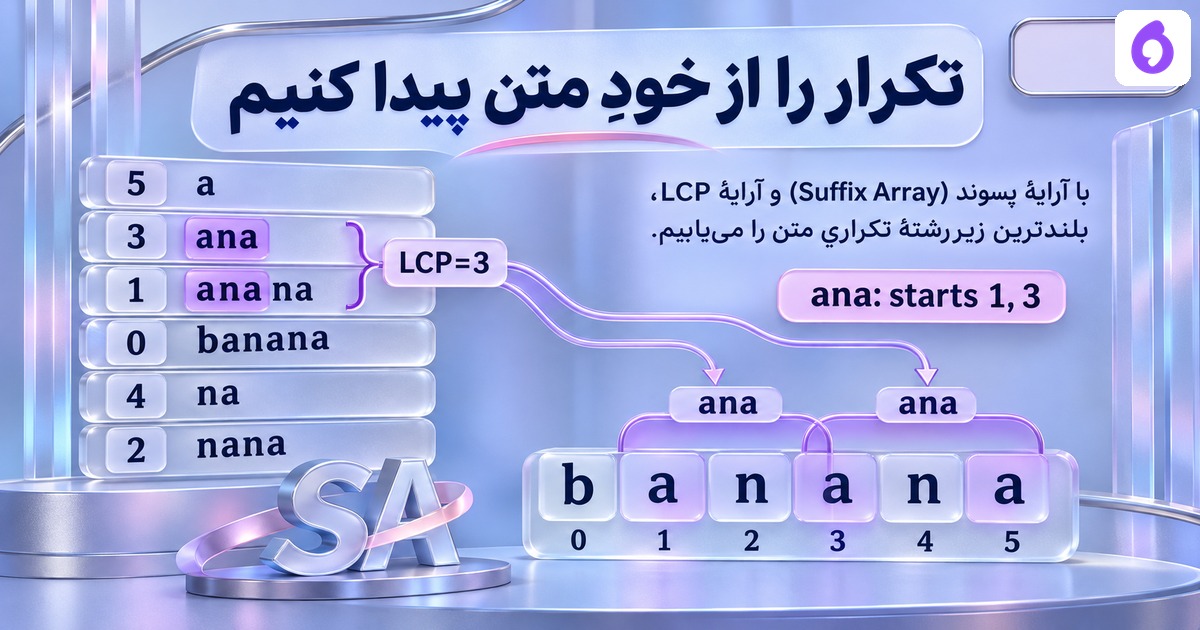
اگر الگویی از قبل نداریم و میخواهیم بلندترین تکهٔ تکراریِ خودِ یک متن را کشف کنیم، مسئله با جستوجویِ یک واژهٔ معلوم فرق دارد. آرایهٔ پسوندها و طولِ پیشوندِ مشترکِ همسایهها، یک راهِ دیدنِ این تکرار است. این تمرین هم متنِ پیداشده و هم همهٔ محلهایِ رخداد را تحویل میدهد.
از متن به فهرستِ پسوندها
banana وaaaa نمونههایِ متداولِ آموزشیاند؛ دادهٔ فارسی و کنترلهایِ تکمیلی را جدا برایِ این تمرین ساختهایم. برای banana، هر جایگاهِ صفر تا۵ شروعِ یک پسوند است: خودِ متن،anana،nana،ana،na وa. این رشتهها را واژگانی مرتب میکنیم، اما اندیسِ آغازِ هر کدام را نگه میداریم. ترتیبِ اندیسهایِ حاصل۵،۳،۱،۰،۴ و۲ است؛ ترتیبِ تازه، جایگاهِ اصلیِ نویسهها را عوض نمیکند.
پیادهسازیِ این صفحه برای متنِ کوچک از برشِ رشته وsort استفاده میکند. آن را سازندهٔ خطیِ suffix array یا روشِ مناسبِ فایلهایِ بسیار بزرگ نمینامیم. هدف، دیدنِ رابطهٔ پسوند و تکرار با یک اجرایِ قابلِ کنترل است.
LCPِ همسایهها را واقعاً حساب کنیم
برای هر دو پسوندِ کنارِ هم، از آغازِ آنها تا اولینِ تفاوت جلو میرویم. تعدادِ نویسههایِ برابر، LCP است. در banana، طولهایِ همسایه۱،۳،۰،۰ و۲ میشوند؛ بیشترینِ آنها۳ است و پیشوندِ مشترکِ مربوط «ana» است.
این تکه از اندیسِ ۱ و۳ متنِ اصلی آغاز میشود. دو رخداد، جایگاههایِ متفاوت دارند ولی همپوشانی دارند؛ همین قرارداد مجاز است. اگر مسئلهٔ شما دو تکهٔ بدونِ همپوشانی بخواهد، این کد عیناً آن قیدِ اضافه را حل نمیکند.
چرا همسایههایِ مرتب مرتبطاند؟
پسوندهایی که با یک رشتهٔ مشترک شروع میشوند، در ترتیبِ واژگانی کنارِ هم قرار میگیرند. اگر تکهای در دو شروعِ متفاوت تکرار شده باشد، در گروهِ پسوندهایِ آن پیشوند، جفتِ همسایهای هم وجود دارد که دستکم همان طول را مشترک دارد. بنابراین برای بیشینهٔ طول، مقایسهٔ LCPِ همسایهها کافی است.
اما کافیبودنِ این مقایسه، ادعایِ ارزانبودنِ همهٔ عملیاتِ پیادهسازیِ آموزشی نیست. برشهایِ رشته، مرتبسازی و محاسبهٔ سادهٔ LCP هزینه دارند. فایل هیچ زمانسنجی یا مقایسهٔ سرعت با KMP یا موتورِ جستوجو اجرا نمیکند.
تساوی و همپوشانی را قراردادی کنیم
در aaaa، جوابِ «aaa» در شروعهایِ صفر ویک است؛ overlap واقعاً در خروجی حضور دارد. اگر چند تکهٔ با بیشترین طول داشته باشیم، این فایل تکهٔ کوچکترِ واژگانی بر حسبِ code point را انتخاب میکند و سپس همهٔ شروعهایِ آن را با بررسیِ مستقیم مییابد.
متنِ فارسیِ «کارکار»، نمونهٔ دارایِ فاصلهٔ «a a a» و متنِ چندتکراریِ «ababcdcd» جدا اجرا شدهاند. هیچ فاصله، نیمفاصله یا شکلِ حرفی پنهانی حذف نمیشود. اندیسها code point هستند؛ مکانِ بایتِ UTF-8 یا خوشهٔ دیداریِ نویسه نیستند.
oracle همهٔ تکهها را میشمارد
مسیرِ مستقلِ کنترل، تمامِ زیررشتههایِ غیرخالیِ هر متن و شروعهایِ آنها را در یک فرهنگ جمع میکند. از میانِ تکههایِ دارایِ دستکم دو شروع، همان قاعدهٔ طول و تساوی را انتخاب میکند. این oracle برای ساختِ جوابِ خودش از آرایهٔ پسوند یا LCP استفاده نمیکند.
تمامِ ۲۵۵رشتهٔ دودویی با طولِ صفر تا۷، بهاضافهٔ مثالهایِ مشخص، با آن برابر شدهاند. متنِ خالی، تکنویسه و بدونِ تکرار، رشتهٔ جوابِ خالی و فهرستِ شروعِ خالی میدهند؛ نبودِ جواب را تکرارِ تهیِ بینهایتبار نمینامیم. بولین،None و متنِ بیش از۱۶نویسه طبقِ قراردادِ محلی رد شدهاند.
KMP الگویِ معلوم را پیدا میکند؛ MinHash شباهتِ مجموعهها را تخمین میزند. اینجا بلندترین تکرارِ دقیقِ داخلِ یک متن کشف میشود، نه معنا یا صحتِ محتوا. ادامه در مبانی هوش مصنوعی؛ نتیجهٔ این تمرین، قابلیتِ تأییدشدهٔ محصولاتِ اپرا نیست.
فایل تمرین و منبع
کد مستقلِ تمرین و کنترلها؛ Python · تمامِ ورودیها و نتیجهٔ اجرای واقعیِ تمرین؛ JSON
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.