
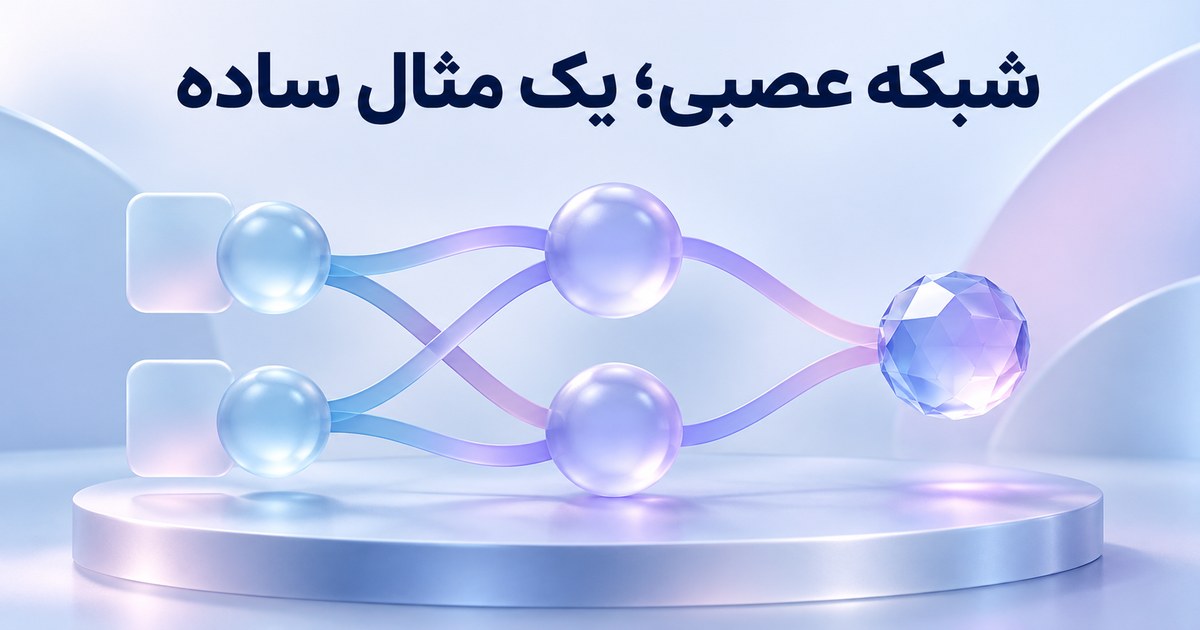
شبکه عصبی مدلی عددی است که ورودیها را از چند لایه عبور میدهد و با وزنها، بایاسها و تابعهای فعالسازی به خروجی تبدیل میکند. برای فهم آن لازم نیست از یک مدل بسیار بزرگ شروع کنیم. در این راهنما، شبکهای با دو ورودی، دو نورون پنهان و یک خروجی را دستی حساب میکنیم. این محاسبه آموزش مدل نیست؛ فقط نشان میدهد یک شبکه با پارامترهای معلوم چگونه پاسخ میدهد.
ورودی، وزن و بایاس چه نقشی دارند؟
فرض کنید برای یک تمرین، دو ویژگی عددی را از قبل آماده کردهایم: x1 برابر ۱ و x2 برابر ۰٫۵ است. این دو عدد اطلاعات مشتری واقعی نیستند و هیچ معنای تجاری به آنها نسبت ندادهایم. هر نورون ورودیها را با وزن مخصوص خود ترکیب میکند، سپس یک بایاس به آن میافزاید. وزن منفی میتواند سهم یک ورودی را کم کند؛ اندازه بزرگتر وزن هم فقط در کنار مقیاس همان ورودی قابل تفسیر است.
اگر نام شبکه و روش یادگیری برایتان مبهم است، ابتدا تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق را بخوانید. آن راهنما خانواده روشها را توضیح میدهد؛ اینجا خود محاسبه داخل یک شبکه را میبینیم.
یک شبکه دوورودی را حساب کنیم
برای نورون اول وزنها را ۰٫۶ و منفی ۰٫۲ و بایاس را منفی ۰٫۱ انتخاب میکنیم. مجموع آن برابر ۰٫۴ میشود. برای نورون دوم وزنها منفی ۰٫۴ و ۰٫۸ و بایاس ۰٫۱ هستند؛ مجموع برابر ۰٫۱ است. این وزنها صرفاً برای آموزش انتخاب شدهاند و از دادهای آموخته نشدهاند.
x1, x2 = 1.0, 0.5
h1 = max(0, 0.6*x1 - 0.2*x2 - 0.1)  # 0.4
h2 = max(0, -0.4*x1 + 0.8*x2 + 0.1) # 0.1
y = 2*h1 + 3*h2 - 0.2               # 0.9
تابع max(0,z) همان ReLU در این مثال است: مقدار منفی را صفر میکند و مقدار غیرمنفی را عبور میدهد. خروجی خطی نهایی برابر ۰٫۹ است. چون در خروجی تابع تبدیل به احتمال تعریف نکردهایم، نباید آن را «اطمینان ۹۰ درصد» یا «دقت ۹۰ درصد» بنامیم.
| بخش | ورودیها | وزن و بایاس | خروجی این نمونه |
|---|---|---|---|
| نورون پنهان ۱ | ۱ و ۰٫۵ | ۲ وزن و ۱ بایاس | ۰٫۴ پس از ReLU |
| نورون پنهان ۲ | ۱ و ۰٫۵ | ۲ وزن و ۱ بایاس | ۰٫۱ پس از ReLU |
| خروجی | ۰٫۴ و ۰٫۱ | ۲ وزن و ۱ بایاس | ۰٫۹ در خروجی خطی |
چرا صرفاً زیادکردن لایهها کافی نیست؟
دو تبدیل خطی پشتسرهم را میتوان به یک تبدیل خطی تبدیل کرد. تابع غیرخطی بین لایهها اجازه میدهد رابطههای پیچیدهتری نمایش داده شوند. این موضوع به معنی بهترشدن خودکار هر شبکه عمیقتر نیست؛ داده، مسئله، روش آموزش و آزمون همچنان تعیینکنندهاند.
در شبکه نمونه، لایه پنهان دو نورون دارد و هرکدام سه پارامتر میخواهند؛ خروجی هم سه پارامتر دارد. پس در مجموع ۹ پارامتر داریم. تعداد نورونها، تعداد لایهها و تعداد پارامترها سه عدد متفاوتاند. هنگام خواندن مشخصات یک مدل، نام این واحدها را کنار عدد بنویسید.
آموزش مدل کدام بخش را تغییر میدهد؟
در محاسبه بالا، وزنها و بایاسها ثابت بودند. در فرایند آموزش، آنها با استفاده از داده و هدف آموزشی تنظیم میشوند. تغییر یک ورودی در فرم آزمایش به معنی یادگرفتن مدل نیست. همچنین نگهداشتن چند پیام در رابط یک دستیار، بهخودیخود شاهد تغییر وزن شبکه نیست؛ برنامه میتواند پیامها را دوباره بهعنوان ورودی ارسال کند.
برای آزمون فهم مثال، ورودی دوم را از ۰٫۵ به صفر تغییر دهید و دوباره هر سه سطر را حساب کنید. سپس فقط بایاس نورون اول را تغییر دهید. این دو تمرین نشان میدهند تغییر داده و تغییر پارامتر چه تفاوتی دارند. از این شبکه کوچک نمیتوان نتیجه گرفت یک محصول واقعی از همین معماری یا همین ویژگیها استفاده میکند.
برای تصمیم کسبوکار چه چیزی از این توضیح به کار میآید؟
در بررسی یک راهکار، بپرسید ورودی چیست، خروجی با چه واحدی تحویل میشود و معیار پذیرش چگونه سنجیده شده است. واژه «شبکه عصبی» جای آزمون روی مسئله شما را نمیگیرد. راهنمای بیشبرازش و تعمیم کمک میکند نتیجه تمرین را با عملکرد روی ورودی تازه اشتباه نگیرید.
اگر مسئله شما پاسخگویی به مشتری است، یک مکالمه نمونه و خروجی مطلوب را برای بررسی مسیر مناسب اپرا آماده کنید. این مثال، ادعایی درباره معماری داخلی یا دقت محصولات اپرا ندارد.
منابع و تاریخ بررسی
این منابع در ۳ نوامبر ۲۰۲۶ بررسی شدهاند. عددهای مثالها آموزشی و ساخته تحریریهاند؛ نتیجه آزمون یک محصول یا مشتری نیستند.
ادامه مسیر یادگیری
Softmax چیست؟ فرمول و محاسبه با مثال عددی — برای یک نمونه خروجی چندکلاسه، فرمول و محاسبه Softmax را جدا امتحان کنید؛ هر شبکه الزاماً همین خروجی را ندارد.