
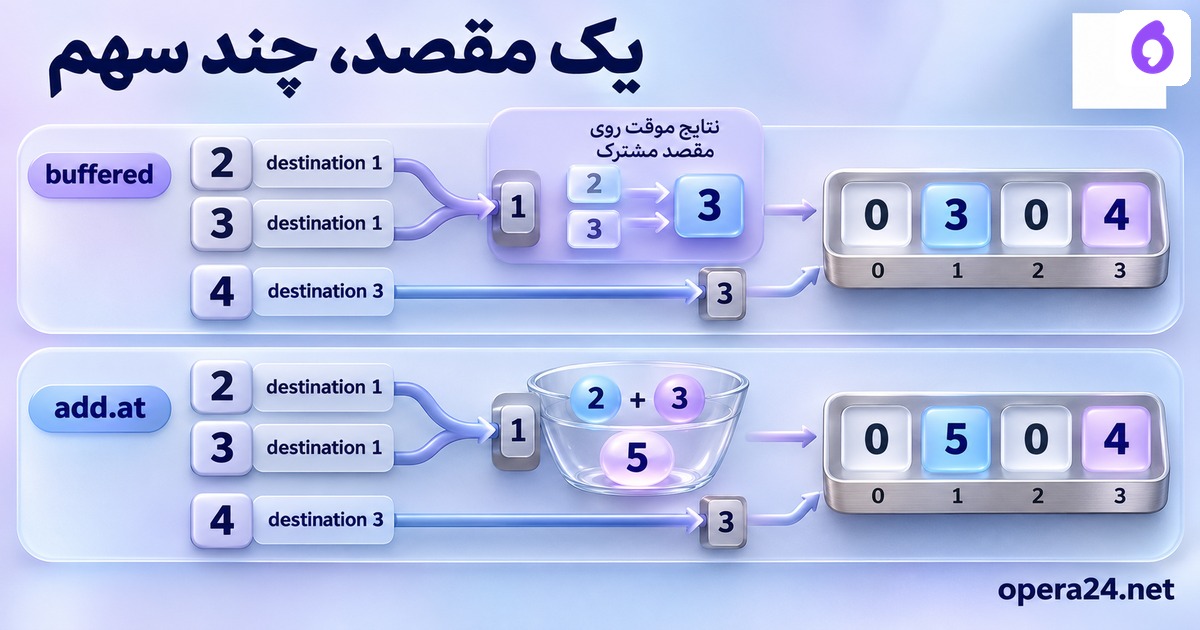
وقتی یک اندیس چند بار در فهرست میآید، عبارتِ a[idx] += weights را با جمعِ جداگانهٔ همهٔ رخدادها یکی نگیریم. در NumPy انتخابِ پیشرفته میتواند ابتدا مقدارها را به بافرِ موقت ببرد و نتیجه را برگرداند؛ مقصدِ تکراری الزاماً هر سهم را جدا دریافت نمیکند. این صفحه با سه سهمِ عددی، np.add.at و حلقهٔ مستقل، تفاوت را واقعاً اجرا میکند.
یک مقصد، دو سهم
آرایهٔ چهارخانهایِ صفر داریم؛ اندیسهایِ صفرمبنا[۱،۱،۳] و سهمهایِ متناظر[۲،۳،۴] هستند. انتظارِ تجمیعِ رخدادها روشن است: خانهٔ۱ باید۲+۳=۵ و خانهٔ۳ باید۴ داشته باشد. مرجعِ مستقلی با listِ پایتون و حلقه میسازیم که هر رخداد را دقیقاً به خانهٔ خودش اضافه میکند.
همهٔ عددها ساختگی و از نوعِ صحیحاند. نه دادهٔ مشتری، مدلِ واقعی یا گزارشِ مصرف در کار است و نه هدفِ تمرین پیداکردنِ سریعترین روش. برایِ هر مسیر آرایهٔ تازه میسازیم تا تغییرِ مسیرِ اول، ورودیِ مسیرِ دوم را آلوده نکند.
خروجیِ عبارتِ کوتاه را بخوانیم
در اجرایِ NumPy۲٫۳٫۵، عبارتِ buffered += رویِ همین اندیسها خروجیِ[۰،۳،۰،۴] میدهد. خانهٔ۱ برابر۵ نیست. انتخاب، سه مقدارِ مبدأ را در وضعیتِ اولیه برداشته و سه نتیجهٔ جدا ساخته است؛ بازگرداندنِ دو نتیجه به همان مقصد، عملِ reductionِ همهٔ سهمها نیست.
عددِ ۳ در این خانه مشاهدهٔ همین اجراست. مستندات برایِ ترتیبِ عمومیِ نوشتنِ چندباره در assignmentِ پیشرفته تضمینِ همیشگی نمیدهد؛ نباید قانونِ «آخرین سهم همیشه برنده است» را از این نمونه برایِ همهٔ ورودیها بسازیم. مسئلهٔ اصلی این است که عبارت، قراردادِ جمعِ تکتکِ رخدادها را تأمین نکرده است.
add.at سهمِ تکراری را انباشته میکند
در مسیرِ دوم، np.add.at را رویِ آرایهٔ int64ِ تازه و همان اندیسها و وزنها اجرا میکنیم. خروجیِ[۰،۵،۰،۴] دقیقاً با حلقهٔ list برابر است. تفاوت تنها در چاپِ دو آرایه نیست؛ کد برابریِ تمامِ خانهها با oracle را assert میکند و شاهدِ شکستِ مسیرِ اول را هم نگه میدارد.
| مسیرِ اجرا | خانهٔ۱ | آرایهٔ کامل |
|---|---|---|
| assignmentِ بافردارِ نمونه | ۳ | [۰،۳،۰،۴] |
| np.add.at | ۵ | [۰،۵،۰،۴] |
| حلقهٔ مستقلِ list | ۵ | [۰،۵،۰،۴] |
ویژگیِ unbufferedِ این متد دربارهٔ اجرایِ همین عمل رویِ اندیسهایِ تکراری است. از آن اتمیکبودن بینِ چند thread، مجوزِ تغییرِ داده یا درستیِ معنایِ سهمها نتیجه نمیگیریم؛ هیچ همزمانی در این آزمایش وجود ندارد.
پیش از تجمیع، قراردادِ ورودی را کنترل کنیم
تابعِ checkedِ تمرین طولِ برابرِ اندیس و وزن، حداکثر۱۶رخداد، اندیسِ صحیحِ غیرbool در محدودهٔ۰تا۳ و وزنِ صحیح با قدرمطلقِ حداکثر۱۰۰۰ میخواهد. این محدودهٔ کوچک، جمع را در دامنهٔ int64ِ این fixture نگه میدارد. اندیسِ منفی، bool، مقصدِ خارج و طولِ ناهماهنگ در چهار آزمون واقعاً رد میشوند.
NumPy بهطورِ عمومی اندیسِ منفی را پشتیبانی میکند؛ ردِ آن انتخابِ wrapperِ ماست تا قراردادِ مقصد مبهم نماند. ورودیِ خالی هم اجرا شده و آرایهٔ چهارخانهایِ صفر میدهد. این تابع، مرجعِ عمومیِ وزنِ اعشاری، چندمحوره، overflow یا دادهٔ نامتناهی نیست.
برایِ پوششِ بیشترِ همین دامنه،تمامِ ۵۸۵دنبالهٔرخدادِ طولِ ۰تا۳باچهارمقصد ووزنِ ۱یا۲با حلقهٔمستقل برابر کنترل میشوند. یک مثالِ بدونِ تکرار باوزنِ منفی هم جدا اجرا میشود؛ این شمارش شاهدِ دادهٔکوتاه است،نه تضمینِ تمامِ ورودیها.
این سؤال با کپی یا CSR فرق دارد
کپی و حافظهٔ مشترک میپرسد تغییرِ شاخهٔ کاری آیا به اصل برمیگردد. اینجا عمداً میخواهیم مقصد تغییر کند؛ سؤال این است که تمامِ سهمهایِ تکراری جمع شدهاند یا نه. شکل و broadcasting نیز سازگاریِ ابعاد را میسنجد و بهتنهایی این تجمیع را تضمین نمیکند.
بازسازیِ CSR قراردادِ جمعِ ستونِ تکراری را در حلقهٔ خودش دارد. تمرینِ حاضر رفتارِ assignment وadd.atِ خودِ NumPy را اجرا کرده است. برای ادامه به مبانی هوش مصنوعی بروید و هنگامِ آمادهسازیِ داده، واحدِ رخداد، مقصد و قاعدهٔ برخورد را مشخص کنید؛ الگوریتمِ داخلیِ اپرا یا بهبودِ کیفیتِ محصول در اینجا اعلام نمیشود.
فایل تمرین و منبع
کد مستقلِ تمرینِ محدود · تمام خروجیِ واقعیِ همین تمرین؛ JSON
- NumPy۲٫۳؛ unbufferedِat و تجمیعِاندیسِتکراری
- NumPy۲٫۳؛ assignmentِاندیسدار،بافرِموقت و نبودِتضمینِترتیبِنوشتنِتکراری
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.