
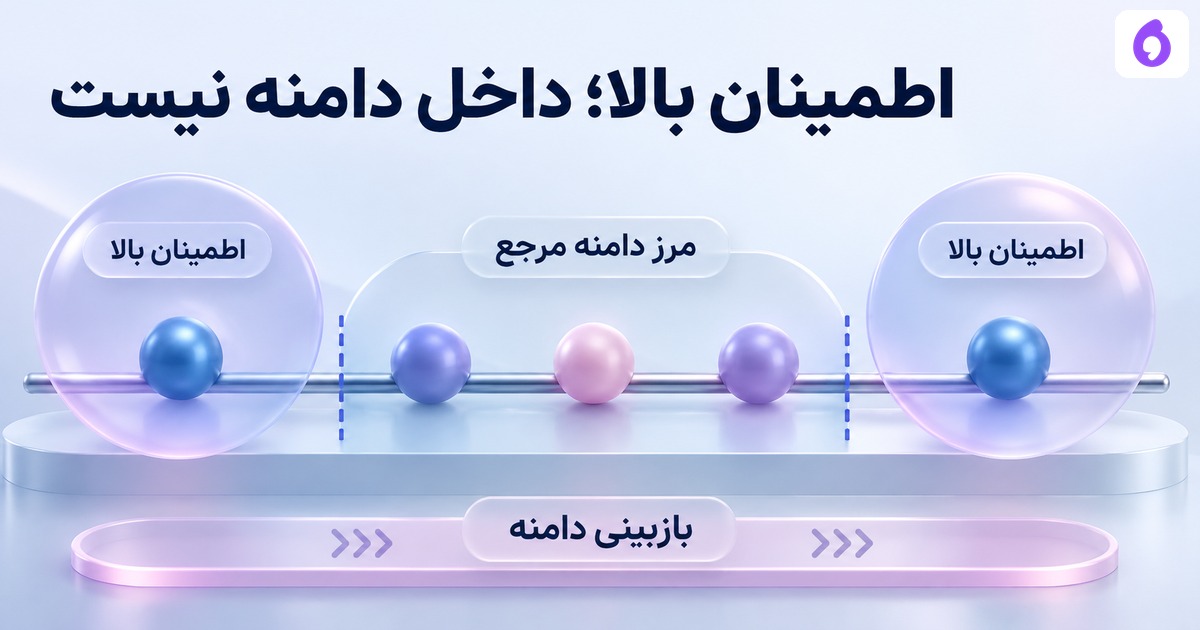
یک ورودیِ تازه ممکن است از محدودهٔ دادهای که روش برایش ساخته شده دور باشد؛ اطمینانِ بالایِ دستهبند بهتنهایی عضویتِ آن در دامنه را ثابت نمیکند. در مثالِ یکبعدیِ این صفحه، فاصله از مرجع را کنارِ احتمالِ یک دستهبندِ ثابت حساب میکنیم. این تمرین، آشکارسازِ کاملِ Out-of-Distribution برایِ متن یا تصویر نیست.
مرجعِ عددی را از همان داده بسازیم
پنج مقدارِ منفیِ دو،منفیِ یک،صفر،یک ودو را مرجعِ ساختگی میگیریم. میانگینِ واقعیِ این پنج عدد صفر و واریانس با مخرجِ پنج برابرِ دو است. این واریانسِ جمعیتیِ همین فهرست است؛ از برآوردِ نمونهایِ دارایِ مخرجِ n-1 استفاده نکردهایم. واحدِ ویژگی هم یک واحدِ آموزشیِ دلخواه است.
برایِ هر x، فاصلهٔ استانداردشدهٔ مربع را (x-mean)²/variance حساب میکنیم. مرزِ چهار را نویسنده برایِ نمایش تعیین کرده است؛ نه سطحِ معناداری، نه نرخِ خطایِ تضمینشده و نه عددِ مناسبِ پروژهٔ واقعی. اگر واریانسِ مرجع صفر باشد، کد آن قرارداد را رد میکند و تقسیمِ نامعتبر را صفر جلوه نمیدهد.
یک اطمینانِ بالا که خارج از مرز هم بالا میماند
کنارِ فاصله، تابعِ ثابتِ sigmoid(3x) را میگذاریم. آن را اینجا آموزش ندادهایم و احتمالِ کالیبرهشدهٔ واقعی نمینامیم. بیشترینِ احتمالِ دو کلاس، max(p,1-p)، نمایشِ اطمینانِ همین تابع است. هرچه x از صفر دورتر شود، این عدد به یک نزدیک میشود؛ حتی اگر فاصلهٔ ورودی از مرجع زیاد باشد.
| x | فاصلهٔ مربع از مرجع | خارج از مرزِ چهار؟ | بیشترین احتمالِ تابعِ ثابت |
|---|---|---|---|
| منفیِ ده | ۵۰ | بله | بیش از ۰٫۹۹۹ |
| منفیِ دو | ۲ | خیر | حدودِ ۰٫۹۹۷۵ |
| صفر | ۰ | خیر | ۰٫۵ |
| دو | ۲ | خیر | حدودِ ۰٫۹۹۷۵ |
| ده | ۵۰ | بله | بیش از ۰٫۹۹۹ |
در دو انتها، عددِ اطمینانِ بالا با بیرونبودن از مرزِ آموزشی همزمان است. کد هر دو را از خودِ x حساب کرده است. این ضدنمونه نشان میدهد همان نمرهٔ اطمینان، جایِ تعریف و سنجشِ دامنهٔ ورودی را نمیگیرد؛ ادعا نمیکند همهٔ روشهایِ تشخیصِ دامنه ناموفقاند.
پرچمِ فاصله، حقیقتِ معنایی نیست
از x=10 نمیدانیم متنِ مشتری موضوعِ نامجاز دارد، ثبتِ عدد اشتباه است یا یک مقدارِ نادرِ معتبر آمده است. برایِ این مسئله باید معنیِ ویژگی، منبعِ داده و دامنهٔ کاربرد معلوم باشد. در فایل، عضویتِ معناییِ دامنه برایِ همهٔ ردیفها تأییدنشده ثبت شده است. مرزِ هندسی را بیبررسی به «درخواستِ بیربط» ترجمه نمیکنیم.
همین محدودیت در چند بُعد هم وجود دارد؛ فاصله به نمایشِ ویژگی و مقیاس وابسته است. یک نمایشِ ضعیف میتواند دو ورودیِ معناییِ متفاوت را نزدیک قرار دهد. این مثال نه متن را embedding میکند، نه ورودیِ واقعی دریافت میکند و نه نرخِ تشخیصِ OOD میدهد.
ورودیِ منفرد با تغییرِ توزیعِ جمعیت فرق دارد
پایشِ drift داده پنجرههایِ زمانی و جمعیتِ ورودی را مقایسه میکند؛ اینجا برایِ یک نقطه، مرجع و امتیازِ فاصله را محاسبه کردیم. تغییرِ رابطهٔ ورودی و نتیجه نیز معمولاً به مرجعِ نتیجهٔ واقعی نیاز دارد؛ با دوربودنِ یک عدد اثبات نمیشود.
برایِ تصمیمِ عملی، خروجیِ «نیازمندِ بررسیِ دامنه» را از خطایِ قطعی، پاسخِ درست و دادهٔ ناموجود جدا نگه دارید. در بررسیِ دادهٔ پرت هم حذف فقط بر پایهٔ فاصله تجویز نشده است. مرجعِ اصلی، فرقِ novelty و outlier را از نظرِ دادهٔ مرجع توضیح میدهد؛ هیچیک از ابزارهایِ آن اینجا اجرا نشدهاند.
برایِ پاسخگوییِ مشتری، نمونهٔ خارج از نیاز، مسیرِ انسانی و معیارِ پذیرش را در بررسیِ چتِ اپرا مطرح کنید. این تمرین سازوکارِ داخلیِ محصول یا تضمینِ تشخیصِ همهٔ ورودیهایِ نامعمول را اعلام نمیکند.
فایل تمرین و منبع
فاصلهٔ یک ورودی از مرجع را کنارِ اطمینانِ ساختگی ببینید · پنج ورودی، مرزِ آموزشی و محدودیتِ تشخیصِ دامنه
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.