
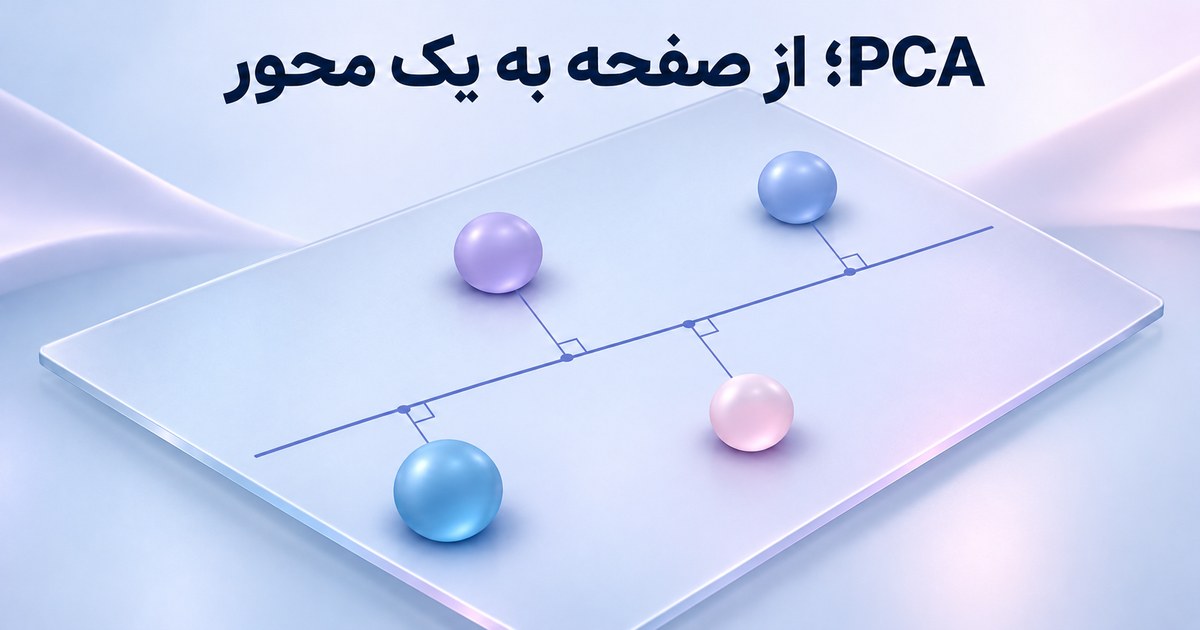
PCA یا تحلیل مؤلفههای اصلی، محورهای تازهای برای نمایش داده مییابد که تغییرات بیشتری از داده را در مؤلفههای نخست نگه دارند. با انتخاب مؤلفههای کمتر میتوان تعداد بُعدها را کاهش داد. آنچه نگه داشته میشود واریانس در نمایش عددی انتخابشده است؛ نه لزوماً معنای مهم، قدرت پیشبینی یا دقت یک مدل بعدی.
چهار نقطه را از دو بُعد به یک بُعد ببریم
داده آموزشی ما چهار نقطه (۰،۰)، (۲،۲)، (۳،۱) و (۱،۳) است. هر دو ویژگی هممقیاس فرض شدهاند. میانگین هر ستون ۱٫۵ است. پس ابتدا از هر مؤلفه ۱٫۵ کم میکنیم. نقطههای مرکزشده بهترتیب (−۱٫۵،−۱٫۵)، (۰٫۵،۰٫۵)، (۱٫۵،−۰٫۵) و (−۰٫۵،۱٫۵) هستند.
کوواریانس نمونهای با تقسیم بر n−۱ یعنی ۳ محاسبه میشود. مجموع مربع هر ستون ۵ و مجموع ضرب دو ستون ۱ است؛ بنابراین ماتریس کوواریانس دو ردیف (۵÷۳،۱÷۳) و (۱÷۳،۵÷۳) دارد. در همین ماتریس متقارن، جهت (۱،۱) پس از تبدیل به بردار واحد، مؤلفه نخست است.
۶۰ درصد واریانس، نه ۶۰ درصد دقت
مقدارهای ویژه این ماتریس ۲ و ۴÷۳ هستند. سهم مؤلفه اول از مجموع آنها برابر ۲÷(۲+۴÷۳)=۰٫۶ است. پس یک محور، ۶۰ درصد واریانس همین داده مرکزشده را نگه میدارد. در این تمرین هیچ برچسب هدف یا طبقهبند نداریم که بخواهیم دقتش را از این عدد نتیجه بگیریم.
| نقطه اصلی | مختصات تقریبی روی محور اول | بازسازی با یک محور |
|---|---|---|
| (۰،۰) | −۲٫۱۲۱۳۲ | (۰،۰) |
| (۲،۲) | ۰٫۷۰۷۱۰۷ | (۲،۲) |
| (۳،۱) | ۰٫۷۰۷۱۰۷ | (۲،۲) |
| (۱،۳) | ۰٫۷۰۷۱۰۷ | (۲،۲) |
سه نقطه آخر روی محور نخست به عدد یکسانی میرسند، با آنکه در فضای اصلی یکسان نیستند. مجموع مربع فاصله بازسازی از اصل برابر ۴ میشود. این مثال دقیقاً نشان میدهد کمکردن بُعد چه اطلاعاتی را میتواند حذف کند؛ خروجی یکبعدی جای همه ویژگیهای اصلی نیست.
کد مستقل برای مثال دوبعدی
import math
X = [(0.0, 0.0), (2.0, 2.0), (3.0, 1.0), (1.0, 3.0)]
n = len(X)
mean = tuple(sum(p[j] for p in X)/n for j in range(2))
C = [(a-mean[0], b-mean[1]) for a, b in X]
a = sum(x*x for x, y in C)/(n-1)
b = sum(x*y for x, y in C)/(n-1)
d = sum(y*y for x, y in C)/(n-1)
radius = math.sqrt(((a-d)/2)**2+b*b)
lambda1, lambda2 = (a+d)/2+radius, (a+d)/2-radius
theta = 0.5*math.atan2(2*b, a-d)
u = (math.cos(theta), math.sin(theta))
scores = [x*u[0]+y*u[1] for x, y in C]
recon = [(mean[0]+s*u[0], mean[1]+s*u[1]) for s in scores]
error = sum((p[0]-r[0])**2+(p[1]-r[1])**2 for p, r in zip(X, recon))
print('mean', mean, 'covariance', ((a, b), (b, d)))
print('eigenvalues', lambda1, lambda2)
print('variance fraction', lambda1/(lambda1+lambda2))
print('scores', [round(s, 6) for s in scores])
print('reconstruction squared error', round(error, 6))
assert abs(lambda1-2) < 1e-12
assert abs(lambda2-4/3) < 1e-12
assert abs(lambda1/(lambda1+lambda2)-0.6) < 1e-12
assert abs(error-4) < 1e-12
این کد از فرمول ماتریس متقارن ۲×۲ استفاده میکند و حلکننده PCA برای تعداد بُعد دلخواه نیست. علامت بردار مؤلفه میتواند برعکس شود: u و −u یک محور هندسی را نشان میدهند؛ در آن حالت علامت مختصات تغییر میکند ولی بازسازی یکسان میماند.
مقیاس و بخش آموزش را ثابت نگه داریم
PCA در پیادهسازی استاندارد مورد ارجاع، داده را مرکز میکند و خودبهخود مقیاس ستونها را یکسان نمیکند. اگر یک ستون فقط بهخاطر واحد، عددهای بزرگتر دارد، جهتهای مهم عددی میتوانند تحت تأثیر آن قرار گیرند. انتخاب تبدیل به معنای ویژگیها وابسته است. مرکز، مقیاس احتمالی و مؤلفهها را باید از بخش آموزش به دست آورد و بدون برازش دوباره روی آزمون اعمال کرد؛ نشت اطلاعات در آمادهسازی داده را جدا بررسی کنید.
راهنمای embedding و تولید متن درباره تولید بردار از متن است؛ PCA اینجا تبدیل آماری همان بردارها یا ویژگیهای موجود است و مدل زبانی تازهای نمیسازد. کاهش بُعد هم خودبهخود به معنی رمزگذاری امن یا ناشناسسازی اطلاعات نیست.
تمرین و قدم بعد
مؤلفه دوم را هم نگه دارید و بررسی کنید هر چهار نقطه با خطای عددی ناچیز بازسازی میشوند. برای یک پروژه، معیار انتخاب تعداد مؤلفه و سنجه کار بعدی را از قبل بنویسید. اگر هدف شما پاسخگویی مشتری است، مسئله و معیار پذیرش را در مسیر راهکارهای اپرا مطرح کنید؛ این مثال ادعای بهبود محصول یا ارائه سرویس PCA ندارد.
فایل تمرین و منابع
دریافت کد کامل این تمرین؛ این فایل فقط از کتابخانه استاندارد پایتون استفاده میکند. ورودیهای آن ساختگی و برای بازتولید محاسبهاند؛ اجرای آموزشی آن نتیجه یک محصول یا مشتری را نشان نمیدهد.
تاریخ بررسی منابع: ۳ نوامبر ۲۰۲۶. منابع، مرجع روشاند؛ دادهها، اعداد و کد مثال برای همین راهنما طراحی شدهاند.
ادامه مسیر یادگیری
محاسبه K-means — برای یک مصرفکننده احتمالی ویژگیهای عددی، الگوریتم تخصیص به مرکز و میانگینگیری K-means را جدا ببینید؛ کاهش بُعد لزوماً کیفیت خوشه را بهتر نمیکند.