
شمارنده متن فارسی
ابزار آموزشی رایگان این صفحه فقط در مرورگر اجرا میشود؛ داده به سرور ارسال نمیشود.
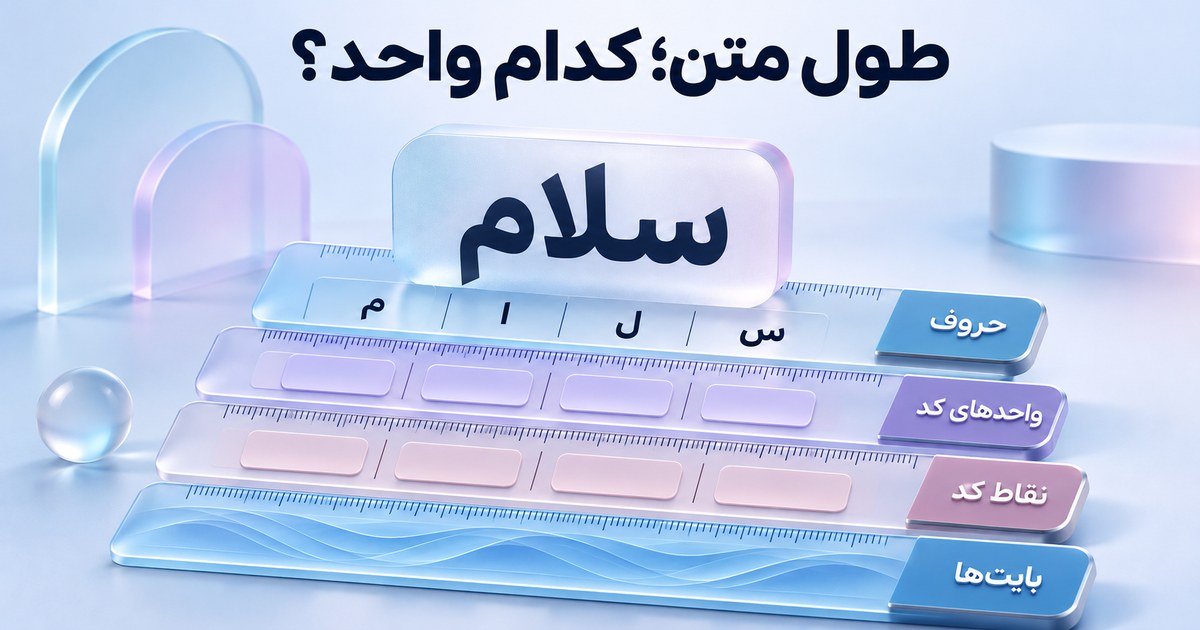
وقتی یک فرم میگوید «حداکثر ۱۰۰ کاراکتر»، ابتدا باید روشن باشد منظورش چه واحدی است. طول رشته در JavaScript، تعداد code point، تعداد خوشههای نویسهای و اندازه UTF-8 میتوانند با هم فرق داشته باشند. ابزار همراه این راهنما هر چهار مقدار را جدا میشمارد؛ شمارش توکن مدل زبانی انجام نمیدهد.
چهار واحد متفاوت برای یک متن
خاصیت length رشته در JavaScript تعداد واحدهای UTF-16 را میدهد. با پیمایش رشته میتوان code pointها را شمرد. Intl.Segmenter با حالت grapheme مرز خوشههای نویسهای را مشخص میکند و TextEncoder متن را به بایتهای UTF-8 تبدیل میکند. انتخاب واحد درست به محدودیت مقصد بستگی دارد؛ برای ذخیره فایل و برای نمایش یک نشانک لزوماً یک عدد کافی نیست.
| متن یا توالی آموزشی | UTF-16 | code point | grapheme | بایت UTF-8 |
|---|---|---|---|---|
| سلام | ۴ | ۴ | ۴ | ۸ |
| 🙂 | ۲ | ۱ | ۱ | ۴ |
| ا + U+0654 | ۲ | ۲ | ۱ | ۴ |
| أ | ۱ | ۱ | ۱ | ۲ |
در دو ردیف آخر، منظور از ردیف سوم رشتهای شامل «ا» و علامت همزه بالای ترکیبی است، نه متن توضیح جدول. آن توالی و حرف «أ» میتوانند یک خوشه دیداری بسازند ولی نمایش کدشده یکسانی ندارند. نتیجه برای مرزهای پیچیدهتر به قواعد Unicode و پیادهسازی محیط هم وابسته است؛ برای قرارداد حساس، همان محیط مقصد را آزمایش کنید.
کد شمارش بدون API
function counts(text) {
  const graphemes = typeof Intl.Segmenter === "function"
    ? [...new Intl.Segmenter("fa", {granularity: "grapheme"}).segment(text)].length
    : null;
  return {
    utf16: text.length,
    codePoints: [...text].length,
    graphemes,
    utf8Bytes: new TextEncoder().encode(text).length
  };
}
اگر مرورگر Segmenter را نداشته باشد، مقدار خوشه در این نمونه ناموجود است؛ آن را بیصدا با تعداد code point جایگزین نکردهایم. برای ورودی خالی، اندازههای قابل محاسبه صفرند. فاصله، خط جدید و نویسههای کنترلی هم بخشی از رشتهاند؛ این شمارنده فقط حروف الفبا را نمیشمارد.
نیمفاصله را برای کمشدن عدد حذف نکنید
در متن فارسی، نیمفاصله هم یک code point است و حذف آن میتواند شکل واژه را عوض کند. همچنین normalize با حالت NFC یا NFKC یک عملیات تعریفشده روی نمایش Unicode است؛ تضمین یکسانسازی همه تفاوتهای املایی فارسی و عربی نیست. پیش از هر تبدیل، متن اصلی را نگه دارید و دقیقاً مشخص کنید چه تغییری مجاز است.
برای مثال، اگر مقصد فایل برحسب بایت محدود است، کمکردن تعداد کلمه راه مطمئنی برای رسیدن به سقف نیست. یک ایموجی و یک حرف فارسی تعداد بایت متفاوتی دارند. اگر مقصد برحسب واحد UTF-16 میسنجد، شمارش خوشههای دیداری هم الزاماً نتیجه اعتبارسنجی همان مقصد را پیشبینی نمیکند.
این شمارنده جای توکنایزر مدل نیست
تعداد بایت یا کاراکتر را در یک ضریب ثابت ضرب نکنید و حاصل را تعداد قطعی توکن ننامید. در راهنمای توکن در متن فارسی توضیح دادهایم که شمارش معتبر باید با توکنایزر همان مدل و ورودی کامل آن انجام شود. هدف این ابزار، آشکارکردن واحدهای طول متن برای فرم، فایل و عیبیابی است.
قبل از استفاده، یک قرارداد کوچک بنویسید
برای فیلد محدودشده، واحد را دقیقاً ثبت کنید: «حداکثر ۱۰۰ بایت UTF-8» یا «حداکثر ۱۰۰ واحد UTF-16». سپس یک متن فارسی ساده، یک ایموجی، یک توالی دارای علامت ترکیبی و یک متن چندخطی را در همان مقصد امتحان کنید. اگر شمارنده و مقصد اختلاف داشتند، نوع شمارش و تبدیلهای قبل از ذخیره را بررسی کنید؛ مقدار کمتر را خودکار درستتر ندانید.
کد ابزار مستقل این راهنما برای پردازش متن درخواست شبکهای نمیسازد و نتیجه را در همان صفحه نشان میدهد. این جمله درباره کد خود ابزار است و جای بررسی افزونهها، تنظیمات مرورگر و اجزای دیگر صفحهای که میزبان آن میشود را نمیگیرد. برای آزمایش اولیه از متن ساختگی استفاده کنید.
اگر مسئله شما آمادهسازی ورودی متنی برای پاسخگویی است، ابتدا قالب و محدودیت مقصد را روشن کنید. سپس انتخاب اطلاعات لازم در پرامپت و مسیر مرتبط اپرا را ببینید. کاهش طول متن بهتنهایی به معنی حفظ معنا یا بهترشدن پاسخ نیست.
منابع و تاریخ بررسی
این منابع در ۳ نوامبر ۲۰۲۶ بررسی شدهاند. عددهای مثالها آموزشی و ساخته تحریریهاند؛ نتیجه آزمون یک محصول یا مشتری نیستند.
ادامه مسیر یادگیری
کلید تکراری در JSON؛ تشخیص خطا پیش از JSON Schema — در ورودی JSON، نام کلید پس از رمزگشایی هم اهمیت دارد؛ نمونه کلید تکراری این مسئله را جدا بررسی میکند.