
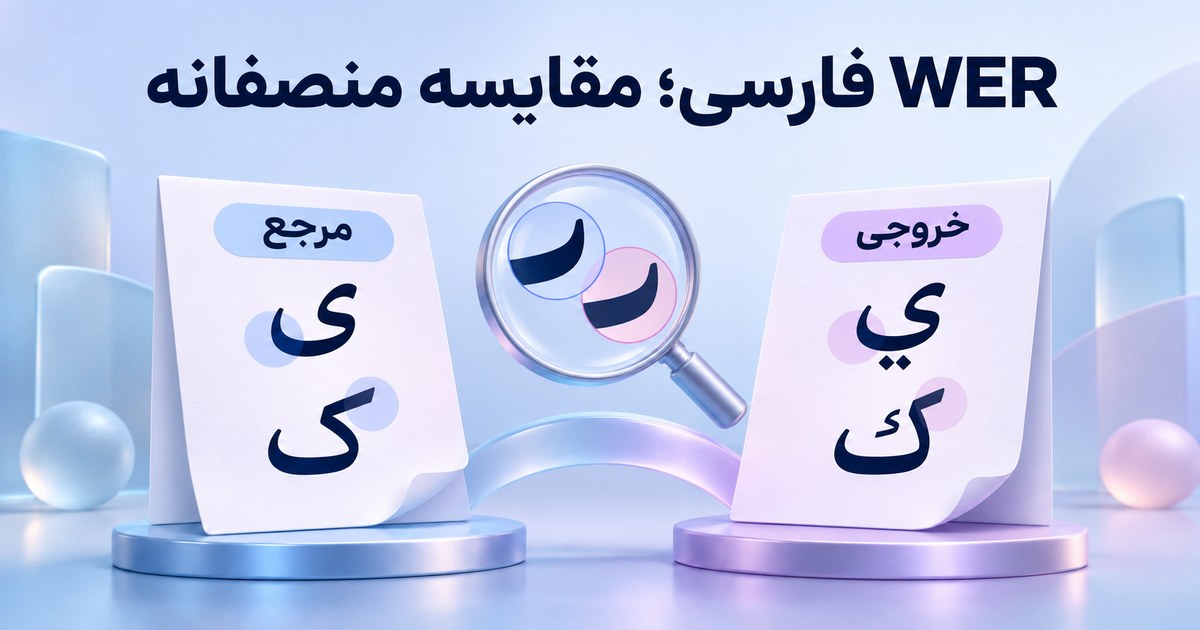
برای محاسبه WER فارسی، اول قرارداد مقایسه متن را ثابت کنید. دو خروجی میتوانند از نظر شنیدن یکسان باشند اما با «ي» و «ی» یا «ك» و «ک» متفاوت نوشته شوند. اگر این تفاوتها را در قرارداد یکسان کردهاید، سنجه را پس از همان تبدیلِ اعلامشده هم محاسبه کنید. امتیاز خام را نیز نگه دارید تا اثر تصمیم شما پنهان نشود.
WER چه چیزی را میشمارد؟
نرخ خطای کلمه از تعداد جایگزینی، حذف و اضافه نسبت به تعداد واژههای متن مرجع به دست میآید: WER = (S + D + I) / N. مرجع باید بازبینیشده باشد. یک متن خودکار دیگر، تنها بهدلیل متفاوتبودن ابزار، مرجع حقیقت نمیشود. قرارداد اینکه چه چیزی «یک واژه» است هم مهم است؛ شکستن ساده با فاصله، همه تفاوتهای نگارش فارسی را حل نمیکند.
مثال قابل تکرار: ۴۰ درصد و صفر برای یک اختلاف نوشتاری
این دو جمله آموزشی را مقایسه کنید:
مرجع: من به بانک می روم
خروجی: من به بانك مي روم
با جداکردن واژهها بر اساس فاصله، مرجع پنج واژه دارد و دو واژه بهخاطر نویسه متفاوت، جایگزینی حساب میشوند؛ WER خام برابر ۲ تقسیم بر ۵، یعنی ۴۰ درصد است. اگر پیشاپیش مقرر کردهاید ی و ک عربی و فارسی یکسان شوند، پس از آن تبدیل اختلاف باقی نمیماند و WER این مثال صفر میشود. این تغییر، آزمایش بهبود یک مدل نیست؛ اثر قرارداد نگارش روی سنجه است.
کد محلی بدون سرویس خارجی
دریافت مثال کامل پایتون برای WER فارسی. کد از کتابخانه استاندارد استفاده میکند؛ فایل صوتی را جایی بارگذاری نمیکند و نیاز به کلید API ندارد. نسخه نمونه، متن را به NFC میبرد، ی و ک را مطابق جدول اعلامشده تبدیل میکند، شکل رقمها را یکسان میسازد و فاصلههای تکراری را جمع میکند. نیمفاصله، علائم نگارشی یا واژههای متن را بیقید حذف نمیکند.
raw_wer: 0.4
normalized_wer: 0.0
numeric_difference_preserved: True
این خروجی متعلق به همان مثال ساختگی است. در یک مجموعه واقعی باید نتیجه همه نمونهها، تعداد واژه مرجع و نسخه قواعد را نگه دارید. فایل نمونه یک پیادهسازی آموزشیِ فاصله ویرایشی دارد و برای ارزیابیهای تخصصی باید قرارداد قطعهبندی و همترازی مناسب همان پروژه هم بررسی شود.
نرمالسازی نباید خطای واقعی را پاک کند
| تبدیل | نمونه | کنترل لازم |
|---|---|---|
| یکسانکردن نویسه | ك به ک | قاعده قبل از دیدن نتیجه ثبت شود |
| یکسانکردن شکل رقم | ۱۲ و 12 | مقدار عدد تغییر نکند |
| حذف همه رقمها | ۱۲ و ۱۳ هر دو حذف شوند | برای این سنجش ممنوع؛ خطای مهم پنهان میشود |
| حذف نفی یا کلمه کوتاه | شد و نشد | معنی تغییر میکند؛ خطای محتوا را حفظ کنید |
دو گزارش کنار هم ارائه کنید
برای هر نسخه، WER خام، WER پس از قواعد ثابت، تعداد نمونه و تعداد واژههای مرجع را بنویسید. اگر قواعد تغییر میکنند، هر دو خروجی قدیم و جدید را با همان مجموعه دوباره حساب کنید. امتیازهای حاصل از دو قرارداد متفاوت را بهعنوان روند بهبود مدل کنار هم نگذارید. افزایش واژههای اضافه حتی میتواند WER را از ۱۰۰ درصد بیشتر کند؛ آن را بدون توضیح، «درصد دقت» ننامید.
برای تصمیم عملی، خطای نام، مبلغ و زمان را جدا نگه دارید؛ راهنمای دقت فیلدهای حیاتی در متن تماس این لایه را پوشش میدهد. اگر زمان یا گوینده هم در خروجی مهم است، همترازی متن با صوت سنجش جداگانهای میخواهد.
در درخواست بررسی گفتار به متن از اپرانگار، نمونه مجاز، متن مرجع و قرارداد ارزیابی را همراه نیازتان توضیح دهید. نتیجه این مثال، عدد دقت محصول یا تضمین نتیجه صوت شما نیست.
منابع مبنا: راهنمای ارزیابی تشخیص گفتار گوگل و مستندات Unicode در پایتون. تبدیلهای فارسی و دادههای مثال در این نوشته صریح و آموزشی تعریف شدهاند.
ادامه مسیر یادگیری
WAV، MP3 یا M4A؛ کدام فایل را برای تبدیل صدا به متن بفرستیم؟ — برای آمادهسازی ورودی یک آزمون پیادهسازی، تفاوت قالبهای صوتی را هم بررسی کنید؛ نام پسوند بهتنهایی کیفیت فایل را ثابت نمیکند.