
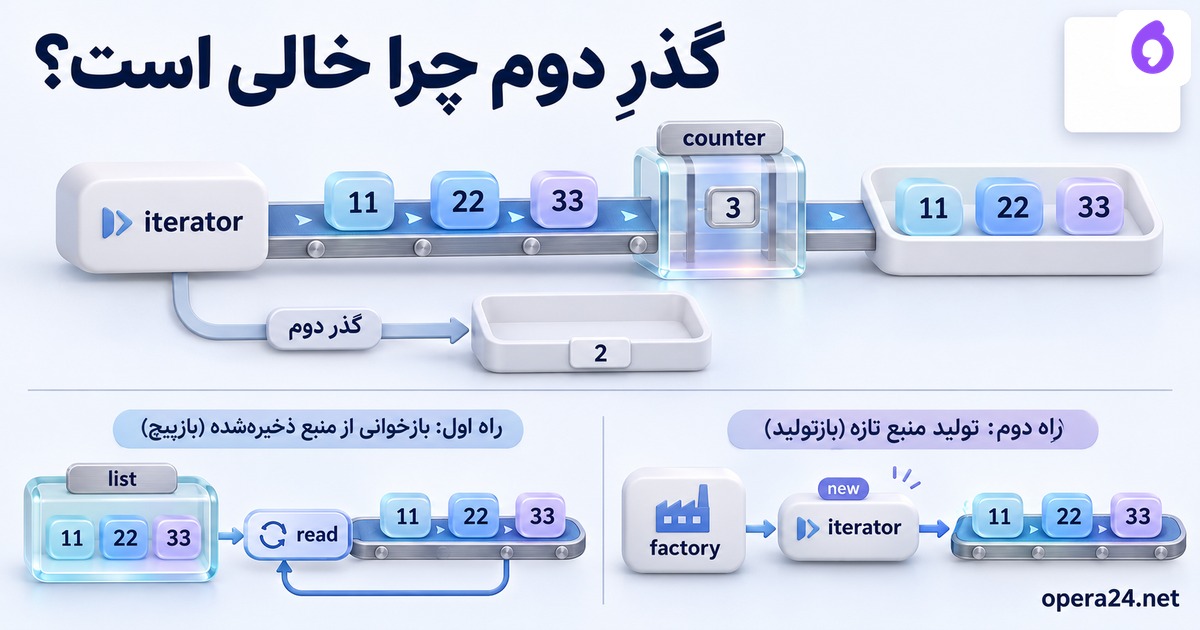
اگر گذرِ دومِ پردازش داده خالی است، شاید داده حذف نشده باشد؛ iterator قبلاً مصرف شده است. generator معمولی پس از پایان، با حلقهٔ بعدی از ابتدا شروع نمیشود. این راهنما سه مقدارِ ساختهشده را از یک generator، یک listِ ذخیرهشده و یک factoryِ تازه عبور میدهد تا مصرفِ ورودی را از دوبارهساختنِ منبع جدا ببینیم.
یک فهرست با یک iterator فرق دارد
list میتواند برای هر حلقه iterator تازه بسازد. generatorِ این تمرین خودش iterator است؛ iter(g) همان g را برمیگرداند. موقعیتِ فعلی بخشی از وضعیتِ آن است. نامِ g یا موجودبودنِ متغیر در حافظه به معنیِ باقیماندنِ تمامِ ورودی برای گذرِ بعدی نیست.
factoryِ آموزشی ما بهترتیب۱۱،۲۲ و۳۳ را yield میکند و هر بارِ تولید را در یک دفترِ کوچک مینویسد. اولین list(g) همین سه مقدار را میگیرد. دومین list(g) خالی است. دو nextِ بعدی نیز هر دو StopIteration میدهند؛ پایانِ این iterator با صداکردنِ دوبارهٔ next از بین نمیرود.
شمارش میتواند ورودی را مصرف کند
اگر برای گزارشِ تعداد، ابتدا تمامِ g را در حلقه طی کنید و بعد همان g را برای تبدیل بدهید، مسیرِ دوم چیزی دریافت نمیکند. این رفتار را با ناپدیدشدنِ فایل یا پاسخِ صفرِ مدل اشتباه نگیرید. در fixture، دفترِ تولید نشان میدهد سه مقدار در گذرِ اول دیده شدهاند و گذرِ دوم تولیدِ تازهای ندارد.
| مسیرِ تمرین | گذرِ اول | گذرِ دوم |
|---|---|---|
| همان generator | [۱۱،۲۲،۳۳] | [] |
| listِ ازپیشذخیرهشده | [۱۱،۲۲،۳۳] | [۱۱،۲۲،۳۳] |
| factoryِ تازه در هر بار | [۱۱،۲۲،۳۳] | [۱۱،۲۲،۳۳] |
برابریِ دو گذرِ آخر فقط برای دادهٔ ثابتِ همین تابع تأیید شده است. factory در منبعِ بیرونی میتواند دوباره فایل بخواند، منبعِ تازه ببیند یا اثرِ دیگری داشته باشد. وجودِ تابعِ سازنده بهتنهایی قراردادِ بازپخشِ یکسان یا اجازهٔ تلاشِ مجدد ایجاد نمیکند.
فقط دیدنِ اولین مقدار هم مصرف است
در آزمایشِ جدا، h تازه میسازیم و next(h) مقدار۱۱ میدهد. اگر سپس list(h) بگیریم، فقط۲۲ و۳۳ باقیاند. این «نگاهِ کوتاه» بدونِ مصرف نبوده است. برنامهای که برای حدسِ قالب، اولین ردیف را میخواند باید بداند آن ردیف را چگونه به مسیرِ اصلی برمیگرداند.
در نسخهٔ سوم، head را نگه میداریم و itertools.chain([head],j) را روی generatorِ باقیمانده میسازیم. خروجی واقعاً هر سه مقدار را به ترتیب میدهد. این بازگرداندنِ صریح، j را rewind نکرده است؛ یک مسیرِ تازه از headِ ذخیرهشده و ادامهٔ همان iterator ساختهایم. برای متنِ خالی نیز list(iter([])) خالی میماند.
ذخیره کنیم یا منبعِ تازه بسازیم؟
در مثالِ سهردیفی، materializeکردن به list کمحجم و روشن است. برای جریانِ بسیار بزرگ یا پایاننامعلوم، listکردنِ بیقید میتواند حافظه را پر کند یا پایان نگیرد. تعداد و اندازهٔ مجاز را پیش از انتخابِ این راه مشخص کنید. این فایل ورودیِ بیرونی نمیپذیرد و هیچ آزمونِ حافظهٔ بزرگ ندارد.
اگر بازخوانی مجاز و پایدار است، factory میتواند برای هر گذر iterator تازه بدهد؛ هویت و نسخهٔ منبع را هم ثبت کنید. اگر فقط یک گذر مجاز است، شمارش و تبدیل را در همان گذر با خروجیِ محدود طراحی کنید. انتخابِ روش به قراردادِ منبع وابسته است؛ راهنمای حاضر مجوزِ دوبارهخواندنِ ابزار یا اجرایِ مدل نمیدهد.
خالیشدن با checkpoint فرق دارد
پردازش ترتیبی و نقطهٔ ادامه وضعیتِ پایدار، شناسهٔ بخش و پاسخِ دیررس را بررسی میکند. اینجا حتی بدون شبکه، فایل و همزمانی، یک iteratorِ حافظهای تمام میشود. نگهداشتنِ خودِ generator در متغیر، نقطهٔ ادامهٔ قابلبازیابی پس از بستنِ برنامه نیست.
پروفایلِ ستونهای CSV تعدادِ رکوردهای خواندهشده را تعریف میکند؛ پیش از افزودنِ گذرِ شمارش به چنین پردازشی، مصرفِ iterator را روشن کنید. برای ادامهٔ یادگیری به مبانی هوش مصنوعی بروید. همهٔ نتیجههای این تمرین از Python۳٫۱۲٫۱۴ و سه مقدارِ اصیلاند؛ دربارهٔ ورودی، retry یا زیرساختِ محصول اپرا نتیجهٔ عملیاتی نمیدهند.
فایل تمرین و منبع
کد مستقلِ تمرینِ محدود · تمام خروجیِ واقعیِ همین تمرین؛ JSON
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.