
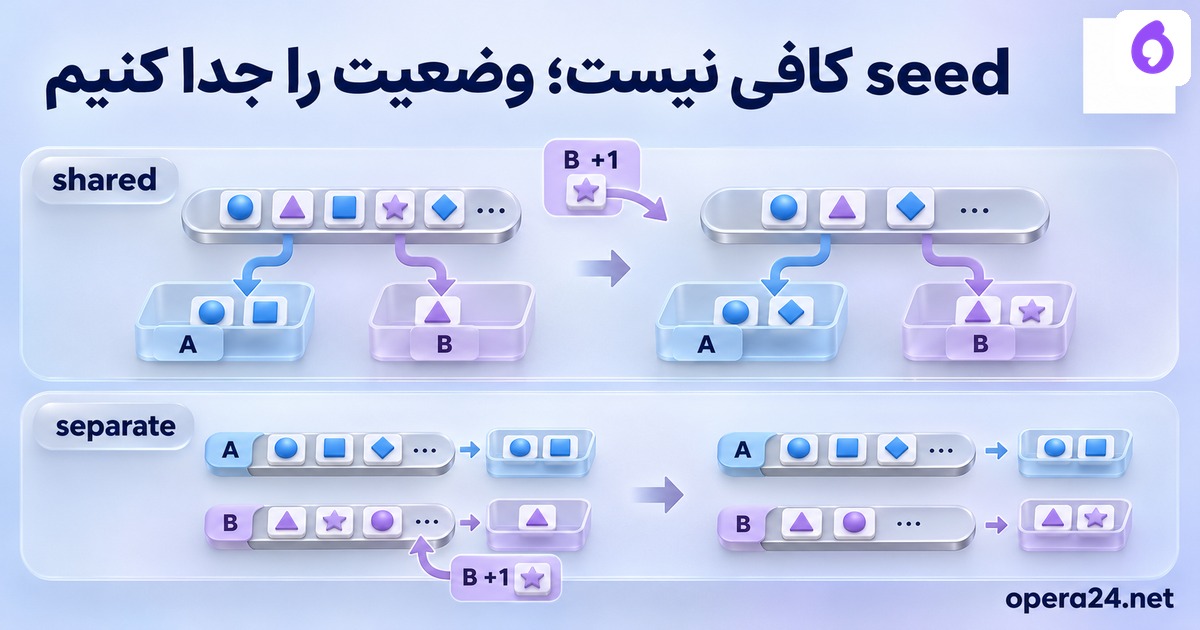
seed یکسان همیشه برای بازتولیدِ یک بخشِ برنامه کافی نیست؛ اگر چند بخش از وضعیتِ تصادفیِ مشترک استفاده کنند، یک برداشتِ اضافی میتواند خروجیِ بخشِ دیگر را جابهجا کند. در این تمرین، ترتیبِ A وB را با یک Randomِ مشترک و سپس دو Randomِ جدا اجرا میکنیم. هدف، مشاهدهٔ مالکیتِ وضعیت است؛ امنیت یا بازتولیدِ کاملِ مدل را نمیسنجیم.
دنباله را چه کسی مصرف میکند؟
یک random.Random باseedِ ۳۷ میسازیم. A یک مقدار میگیرد، بعدB یک مقدار و سپسA دو مقدارِ دیگر. در اجرایِ دوم فقطB یک برداشتِ اضافی دارد. هر دو اجرا ازseedِ یکسان شروع شدهاند، ولی سهمِ عددهایِ بعدیِ A تغییر میکند؛ زیرا A وB از یک وضعیتِ مشترک مصرف کردهاند.
اولین مقدارِ A در هر دو حدود۰٫۶۸۲۰۰۴۵۶ است. بدونِ برداشتِ اضافیِ B، دو مقدارِ بعدیِ A حدود۰٫۶۱۷۸۱۶۳۵ و۰٫۸۴۱۹۱۹۹۰ هستند؛ با برداشتِ اضافی، حدود۰٫۸۴۱۹۱۹۹۰ و۰٫۸۳۴۵۵۰۲۹ میشوند. رقمهایِ کامل در JSONِ اجرایِ واقعی ثبتاند؛ اینها نتیجهٔ دقت، امتیازِ مدل یا دادهٔکسبوکار نیستند.
وضعیتِ جدا، اثرِ این interleaving را حذف میکند
در مسیرِ دوم، A یک Random(37) وB یک Random(91) دارد. همان ترتیبِ رویداد را با و بدونِ برداشتِ اضافی اجرا میکنیم. این بار سه مقدارِ A در هر دو اجرا دقیقاً برابرند: برداشتِ B وضعیتِ مولدِ A را جلو نبرده است. کد، تمامِ فهرست را مقایسه میکند و به شباهتِ رقمهایِ گردشده اکتفا نمیکند.
| سازوکارِ تمرین | برداشتِ اضافیِ B | اثر روی ادامهٔA |
|---|---|---|
| یک Randomِ مشترک | همان وضعیت جلو میرود | دو مقدارِ بعدی متفاوتاند |
| دو Randomِ جدا | فقط وضعیتِ B جلو میرود | سه مقدارِ A برابر میمانند |
این جداییِ وضعیت را با استقلالِ آماریِ همهٔدنبالهها یکی نمیگیریم. در آزمونِ جدا، دو شیءِ مستقل باseedِ یکسانِ ۳۷ میسازیم؛ سه مقدارِ اولِ آنها برابرند. متفاوتبودنِ شیء بهتنهایی شاهدِ نامرتبطبودنِ خروجی نیست.
seed با checkpointِ وضعیت فرق دارد
در آزمایشِ سوم، یک مقدار ازRandom(37) میگیریم و بعد getstate را نگه میداریم. سه مقدارِ بعدی ثبت میشوند؛ با setstate به همان وضعیت برمیگردیم و همان سه مقدار را دوباره میگیریم. برابریِ دقیق واقعاًکنترل شده است. خودِ وضعیتِ بزرگ را در گزارش منتشر نکردهایم؛ فقط نتیجهٔمقایسه و عددهایِ آموزشی آمدهاند.
seed آغازِ دنباله را مشخص میکند؛ state جایِ موجود در دنباله را هم دارد. در برنامهٔواقعی، سازگاریِ نسخه و روشِ نگهداریِ وضعیت باید روشن باشد. این تمرین وضعیتِ یک generator را در همان فرایند بازمیگرداند و ذخیرهٔپایدارِ اجرایِ توزیعشده یا checkpointِ مدل نمیسازد.
محدودهٔبازتولید را کوچک و صادقانه بنویسیم
نسخهٔاجرایِ ثبتشده Python۳٫۱۲٫۱۴ و اجرا تکرشتهای است. مستنداتِ random تغییرِ بعضی الگوریتمها میانِ نسخهها و حدودِ بازتولید را توضیح میدهد. از یک آزمایشِ Random نمیتوان یکسانماندنِ همهٔخروجیهایِ GPU،ترتیبِ همزمانی یا نمونهگیریِ هرکتابخانه را نتیجه گرفت.
random مولدِ رمزنگاری نیست. برایِ کلید،توکن یا دادهٔحساس از این خروجیها استفاده نکنید؛ در این تمرین هم هیچ کاربردِ امنیتی،فایلِ مشتری یا تماسِ واقعی وجود ندارد. مرجعِ ما خودِ دو اجرایِ کنترلشده است، نه ادعایِ ناممکنبودنِ تداخل در هرسامانه.
این نکته کجا به آزمایشِ هوش مصنوعی کمک میکند؟
در Grid وRandom Search باید فهرستِ پیکربندیهایِ واقعاًدیدهشده روشن باشد. اینجا نشان میدهیم چرا افزودنِ یک مصرفکنندهٔدیگر به منبعِ مشترک میتواند همان فهرست را عوض کند. جنگلِ تصادفیِ آموزشی نیز قراردادِ انتخابِ ردیف وویژگیِ خودش را دارد؛ عددِ seed جایِ ثبتِ آن قرارداد نیست.
برای ادامه در مبانی هوش مصنوعی، مالکِ مولد،seed،نسخه و ترتیبِ مصرف را در پروندهٔغیرمحرمانهٔآزمایش بنویسید. هیچ روشِ تصادفیسازی یا تضمینِ بازتولیدِ محصولاتِ اپرا در این صفحه اعلام نشده است.
فایل تمرین و منبع
کد مستقلِ تمرینِ محدود · تمام خروجیِ واقعیِ همین تمرین؛ JSON
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.