
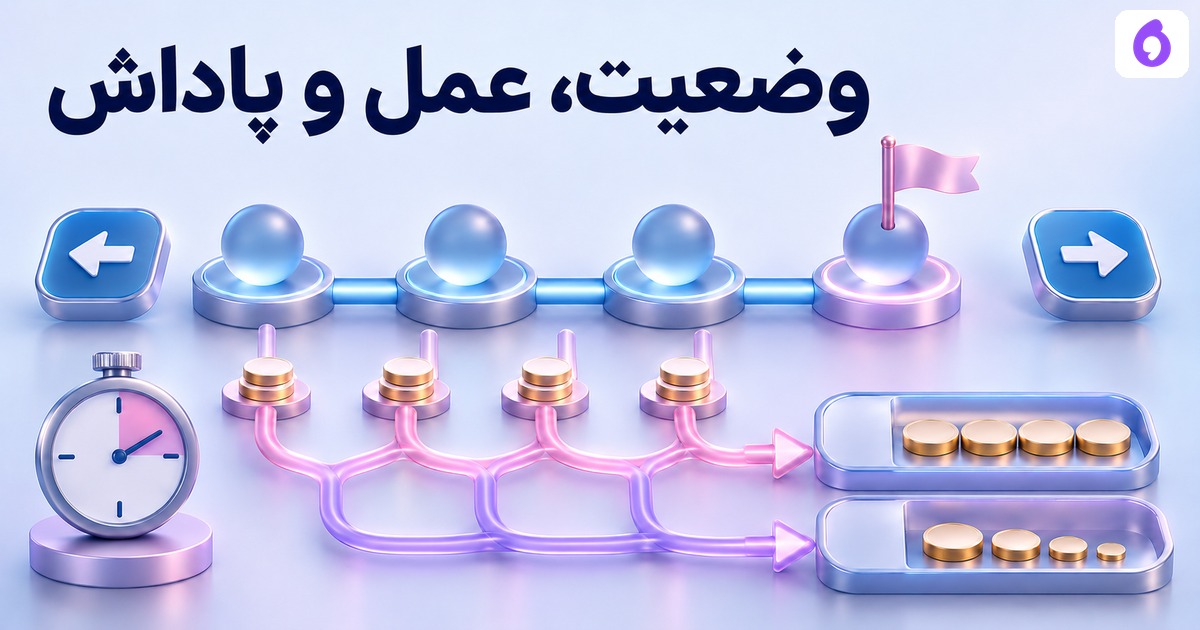
یادگیری تقویتی به تصمیمهایی مربوط است که عامل در محیط میگیرد و از پیامد و پاداش آنها برای یادگیریِ سیاست استفاده میکند. برای فهم اجزا، یک محیطِ خطی با دو حرکت میسازیم و پاداشِ دو مسیرِ دستی را حساب میکنیم. این کد محیط و حسابِ بازده را اجرا میکند؛ هیچ سیاستی یاد نمیگیرد و کارِ واقعی انجام نمیدهد.
وضعیت، عمل و پاداشِ محیطِ فرضی
وضعیتها۰تا۳،شروع۰وهدف۳است. عملLیک خانه چپ وRیک خانه راست میرود؛ در مرز۰حرکتِ چپ همان۰میماند. رسیدن به هدف پاداش۵وهر گامِ دیگر پاداش−۱دارد. سقفِ هر دوره۴گام است. این قرارداد انتخابِ آموزشی است؛ پاداش۵امتیازِ مشتری یا سودِ ریالی نیست.
| جزء | معنی در تمرین |
|---|---|
| state | موقعیت فعلیِ کاملِ محیط |
| action | LیاR |
| transition | موقعیتِ تازه طبق حرکت و مرز |
| reward | ۵در هدف، −۱در بقیهٔ گامها |
| policy | قاعدهٔ انتخابِ عمل؛ اینجا مسیرها دستیاند |
در پروژههای واقعی، مشاهده ممکن است تمامِ وضعیت را نشان ندهد؛ این مثالِ کاملاً مشاهدهپذیر آن مسئله را مدل نکرده است. همچنین تنظیمِ پاداش میتواند رفتاری متفاوت از خواستهٔ واقعی بسازد؛ نامِ «پاداش» درستیِ هدف را تضمین نمیکند.
مسیرِ رسیدن به هدف
با سهR،وضعیتها۰→۱→۲→۳وپاداشها−۱،−۱،۵هستند. جمع ساده۳است. با γ=۰٫۹،بازدهِ شروع برابر −1+0.9×(−1)+0.9²×5=2.15یعنی۴۳÷۲۰است. ضریب تنزیل و جمعِ بیتنزیل دو قراردادِ متفاوتاند؛ هر دو در فایل جدا ثبت شدهاند.
در گام سوم، terminated=Trueاست چون شرط هدف رخ داده؛ در این قرارداد truncated=Falseمیماند. فراخوانیِ stepپس از پایان، بدون resetبا خطا رد میشود تا مسیرهای دو دوره بیخبر به هم نچسبند.
پایان بر اثرِ سقفِ گام
مسیر R,L,R,Rدر چهار گام به وضعیت۲میرسد؛ هدف رخ نداده ولی سقف۴گام تمام شده است. پاداشِ چهار گام−۱و جمع−۴است. اینجا truncated=Trueوterminated=Falseداریم. قطعِ دوره به علتِ محدودیت را به معنی رسیدن به هدف یا شکستِ تعریفشدهٔ همهٔ محیطها ننامید؛ قراردادِ پایان را باید صریح خواند.
مستند Gymnasiumهم این دو پرچم را از هم جدا میکند، اما کد حاضر Gymnasiumرا اجرا نکرده و APIسازگارِ کامل با آن نیست؛ خروجیِ stepما فقط چهار مقدار دارد. خودِ قراردادِ تمرین است که رسیدن به هدف و سقف را همزمان trueنمیکند.
محیطساختن با یادگرفتنِ سیاست فرق دارد
مسیرِ «همیشهR» را انسان تعیین کرده است. اجرای مسیر و محاسبهٔ return، آموزشِ Q-Learningیا پیداکردنِ بهترین سیاست از داده نیست. برای یادگیری، روشِ بهروزرسانی، اکتشاف، دادهٔ تجربه و ارزیابیِ جدا لازماند؛ موفقیتِ یک مسیر، شاهدِ تعمیم به محیطهای دیگر نیست.
RLHFو ترجیح انسان به استفاده از بازخورد در تغییرِ رفتارِ مدل میپردازد؛ محیطِ خطیِ این صفحه فرایندِ گفتگوی مشتری یا الگوریتمِ آموزشِ اپرا نیست. همینطور واژهٔ «ایجنت» در یک نرمافزار، بهتنهایی نشان نمیدهد سیاستِ آن با RLآموزش دیده است.
تمرینِ بعد
پیش از تغییرِ کد، برای مسیری تازه جدولِ state/action/rewardو دو پرچمِ پایان را دستی پر کنید؛ سپس γرا تغییر دهید و فرقِ جمع پاداش با returnرا ببینید. فایل Pythonاین دو مسیر،۴۳÷۲۰و مرزِ resetرا واقعاً کنترل کرده است. مبانی بیشتر در راهنمای هوش مصنوعی است؛ برای نیاز عملی، ابتدا کارِ مجاز و خروجیِ مورد انتظار را در راهکارهای اپرا روشن کنید.
فایل تمرین و منبع
محیطِ خطیِ کوچک، دو مسیرِ دستی و returnبا تنزیل · دو مسیرِ اصیل و تفاوت پایانِ هدف با سقفِ زمان
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.