
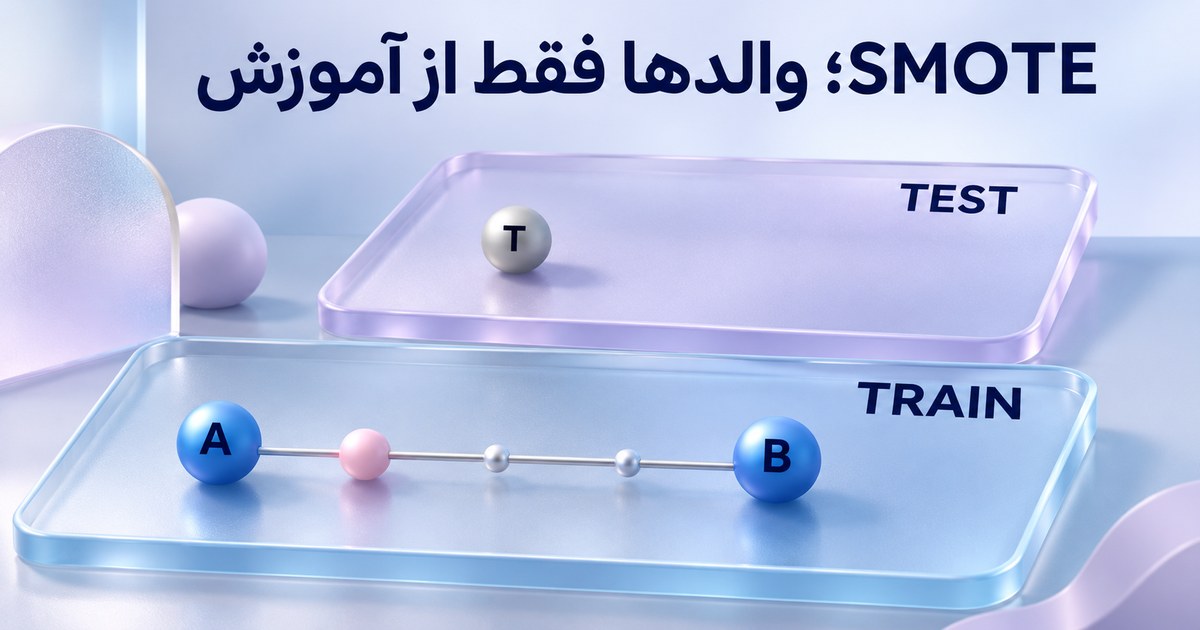
SMOTEمیتواند برای کلاسِ کمتعداد، بین یک نمونه و همسایهٔ همان کلاس نقطهٔ عددی تازه بسازد. این با فقط زیادکردن وزنِ خطا فرق دارد. در این راهنما یک گامِ درونیابیِ شبیه SMOTEرا با همسایه و منشأِ مشخص اجرا میکنیم؛ fit_resampleکتابخانه، آموزش طبقهبند یا بهبودِ دقت انجام نشده است.
کدام داده حق دارد والد باشد؟
در بخشِ آموزشِ ساختگی، سه نقطهٔ اقلیت A=[۱،۱]،B=[۳،۳]وC=[۱،۵]وچهار نقطهٔ اکثریت داریم. نقطهٔ آزمونِ T=[۱٫۲۵،۱٫۲۵]هم جدا نگه داشته شده است. این تعدادها و مختصات فقط صورت تمریناند؛ اندازهٔ پیشنهادیِ مجموعه یا دادهٔ مشتری نیستند.
برای نقطهٔ A، فقط دیگر نمونههایِ همان کلاس در trainنامزد همسایگیاند؛ خودِ Aحذف میشود. با فاصلهٔ اقلیدسیِ مربعی، فاصله تاBبرابر۸وتاCبرابر۱۶است؛ پس با k=۱،Bانتخاب میشود. TازBبهAنزدیکتر است، ولی چون testاست وارد انتخاب نمیشود. کد این نزدیکی و کنارگذاشتهشدنِ درستِ آن را واقعاً کنترل کرده است.
فرمول یک گام را اجرا کنیم
قاعدهٔ عددی x_new=x_A+λ×(x_B−x_A) است. برای بازتولید، λرا عمداً۱÷۴ثابت میگذاریم؛ در این اجرا تصادفی انتخاب نشده است. اختلاف BوAبرابر[۲،۲]، یکچهارم آن[۰٫۵،۰٫۵]و نمونهٔ تازه[۱٫۵،۱٫۵]است. فایلِ lineageشناسهٔ دو والد، λ، مختصات، برچسب و splitتازه را ثبت میکند.
در توضیح روشِ اصلی، λدر بازهٔ[۰،۱]نمونهگیری میشود. این کد فقط یک همسایه و یک λثابت را نشان میدهد؛ حلقهٔ نمونهگیری، تعداد خروجیِ لازم و همهٔ قراردادهای SMOTEکتابخانه را پیاده نکرده است. پارامتر پیشفرضِ k_neighborsیک ابزار را هم بدون تعداد کافیِ نمونهٔ اقلیت به این مجموعهٔ کوچک منتقل نکنید.
پنج ردِ ورودی و آزمونِ ثابت
کد واقعاً تلاش برای استفاده از والدِ آزمون، والدِ کلاسِ دیگر، λمنفی، λبزرگتر از۱ووالدِ یکسان را رد میکند. بخشِ testپیش و پس از ساخت نقطه با هشِ همان نمایشِ JSONمقایسه میشود و ثابت میماند. این کنترل فقط برای دادهٔ کوچکِ ساختهشده است؛ بهخودیخود نبودِ همهٔ انواع نشت در یک پروژهٔ واقعی را ثابت نمیکند.
اگر اصل و نمونهٔ مشتق از آن در دو بخشِ ارزیابی پخش شوند، ارزیابی مستقل نیست. در چندبخشی، انتخاب همسایه و ساخت نمونه باید در آموزشِ همان foldانجام شود؛ پیش از تقسیمِ کل مجموعه نمونهسازی نکنید. testرا برای خوشظاهرشدنِ نسبت کلاسها متوازن نمیکنیم.
هر ستون عددنما، ویژگیِ پیوسته نیست
میانگینِ شناسهٔ مشتری، شمارهٔ توکن یا کدِ دسته لزوماً دادهٔ معتبر نمیسازد. مثال ما دو محورِ عددیِ پیوسته و هممقیاسِ فرضی دارد؛ روی متن، صوت خام یا ستونِ دستهای این فرمول را بدون روشِ مناسب اجرا نکنید. همچنین نقطهٔ پرتِ بدبرچسب، همسایهٔ نامناسب و تداخل کلاسها میتوانند نمونهٔ نامفید بسازند؛ درونِ پارهخطبودن تضمینِ کیفیت نیست.
تفاوت با وزندهی و افزایش داده
وزن کلاس سهمِ خطای نمونه را عوض میکند؛ اینجا یک رکوردِ تازه با دو والد میسازیم. حفظ برچسب در افزایش داده نمونهٔ تبدیل متن را بررسی میکند؛ این نوشته حسابِ همسایه و درونیابیِ عددی را اجرا میکند. هیچکدام بهتنهایی بهترین روشِ همهٔ پروژهها نیستند.
برای تمرین، λرا در همان بازه تغییر دهید و منشأ را حفظ کنید؛ سپس خودِ تعریفِ ویژگی و برچسب را با نمونهٔ مستقل بسنجید. مبانیِ بیشتر در راهنمای هوش مصنوعی است. این داده و حساب، روشِ آموزش داخلی یا نتیجهٔ محصول اپرا را گزارش نمیکند.
فایل تمرین و منبع
همسایهٔ اقلیتِ آموزش و یک درونیابی با منشأِ دقیق · نقاط اصیل، splitوالدها، λو مختصاتِ نمونهٔ ساختهشده
- راهنمای اصلی imbalanced-learn؛ ساخت نمونه با درونیابی و محدودیتها
- همان پروژه؛ نشتِ بازنمونهگیری پیش از جداسازی
- مرجع SMOTE؛ همسایه و پارامترهای روش
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.