
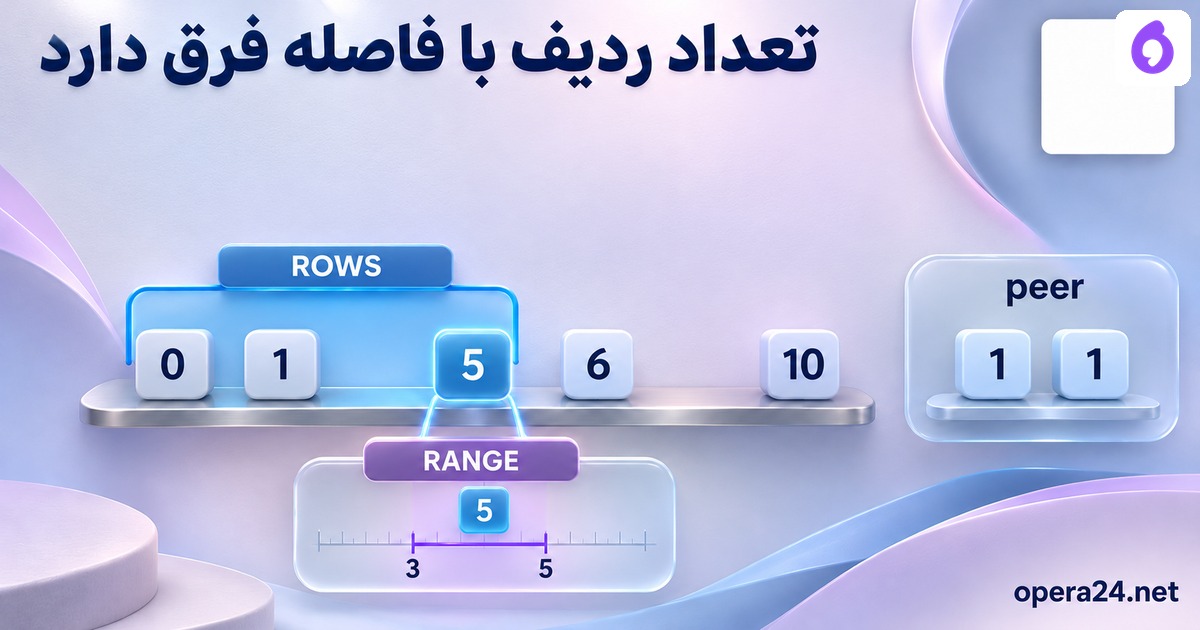
تفاوت ROWS و RANGE در SQL به روش انتخاب اعضای پنجره برمیگردد. دو ردیف قبلی لزوماً دو واحد فاصله در ستون مرتبسازی نیست. در مثال نامنظم این صفحه، برای ردیف t=5 جمعِ ROWS برابر ۶۰ و جمعِ RANGE برابر ۳۰ است. هر دو، پاسخ درستِ قرارداد خودشان هستند. کد قابل دریافت، اعضا و جمع هر پنجره را با انتظار مستقلی مقایسه میکند؛ فقط یک جدول توضیحی نداریم.
ابتدا بگوییم «دو واحد» یعنی چه
پنج ردیف آموزشی با شناسههای a تا e میسازیم. مقدارهای t بهترتیب ۰، ۱، ۵، ۶ و ۱۰ هستند و ستون amount مقدارهای ۱۰، ۲۰، ۳۰، ۴۰ و ۵۰ دارد. این داده را نویسنده ساخته است؛ t تاریخ تماس یا زمان ثبتشدهٔ مشتری نیست. فاصلهٔ نامنظم عمداً انتخاب شده تا دو تعریف نتیجهٔ یکسان ندهند.
در آزمایش اول، همهٔ tها عدد صحیح، یکتا و غیر NULL هستند. بنابراین ترتیب هر ردیف معلوم است و هنوز مسئلهٔ تساوی نداریم. واحد t هم فقط واحد عددیِ همین تمرین است. نباید بدون قرارداد، آن را ثانیه، روز کاری یا فاصلهٔ تقویمی بنامیم. اگر دادهٔ واقعی زمان دارد، تبدیل زمان و قواعد تقویم تصمیم جداگانهای میخواهد.
دو query، با فقط یک تغییر اصلی
هر دو مسیر از SUM روی amount و ORDER BY t صعودی استفاده میکنند. مرز پایان در هر دو CURRENT ROW است؛ خودِ ردیف جاری داخل جمع قرار میگیرد. در مسیر اول عبارت زیر را داریم:
ROWS BETWEEN 2 PRECEDING AND CURRENT ROWاین قرارداد، حداکثر دو ردیف پیش از ردیف جاری را بهاضافهٔ خودش میگیرد. در ابتدای مجموعه، اگر دو ردیف قبلی وجود نداشته باشند، فقط ردیفهای موجود در همان محدوده حضور دارند. این رفتار را با دو ردیفِ بعدی یا حذف ردیف جاری اشتباه نگیریم.
در مسیر دوم تنها نوع frame به عبارت زیر عوض میشود:
RANGE BETWEEN 2 PRECEDING AND CURRENT ROWاینجا برای کلید عددی صعودی، مقدارهای بین t−2 و t در بازهاند. تعداد اعضا ثابت نیست: ممکن است سه عضو، یک عضو یا با وجود تساوی، چندین عضو داشته باشیم. برای مقایسهٔ اول همان پنج کلید یکتا را نگه میداریم تا اثر نوع پنجره روشن بماند.
شناسهٔ اعضا را کنار جمع قرار دهیم
کد، علاوه بر SUM، با group_concat شناسههای داخل همان پنجره را ثبت میکند. انتظار مستقل Python برای ROWS از برش فهرست و برای RANGE از شرط عددی ساخته میشود. سپس هم اعضا و هم جمعِ هر پنج ردیف باید برابر باشند. این کنترل کمک میکند دو عضویت متفاوت که تصادفاً جمع یکسان دارند از چشم پنهان نمانند.
| ردیف جاری | اعضای ROWS و جمع | اعضای RANGE و جمع |
|---|---|---|
| c؛ مقدار t برابر ۵ | a,b,c؛ جمع ۶۰ | c؛ جمع ۳۰ |
| d؛ مقدار t برابر ۶ | b,c,d؛ جمع ۹۰ | c,d؛ جمع ۷۰ |
| e؛ مقدار t برابر ۱۰ | c,d,e؛ جمع ۱۲۰ | e؛ جمع ۵۰ |
برای c، دو ردیف قبلی کلیدهای ۰ و ۱ دارند؛ اما هیچکدام در فاصلهٔ عددی ۳ تا ۵ نیستند. برای e هم فاصلهٔ ۸ تا ۱۰ فقط خودِ e را دارد. اگر نمودار را صرفاً «جمع سه مشاهده» بنامیم ولی query از RANGE استفاده کند، شرح شاخص با محاسبه هماهنگ نیست.
peerها را در دادهٔ جدا آزمایش کنیم
آزمایش دوم چهار ردیف با کلیدهای ۰، ۱، ۱ و ۳ و مقدارهای ۱۰، ۲۰، ۳۰ و ۴۰ دارد. دو ردیف میانی در ORDER BY t همرتبه یا peer هستند. با SUM(amount) OVER(ORDER BY t)، frame پیشفرض SQLite از RANGE و مرزِ آغاز مجموعه تا ردیف جاری و peerهای آن استفاده میکند؛ در نتیجه هر دو ردیف با t=1 جمع ۶۰ میگیرند.
برای مسیر ROWS، ترتیب قطعی t,id و مرزِ UNBOUNDED PRECEDING تا CURRENT ROW میگذاریم. حالا جمع دو ردیف میانی بهترتیب ۳۰ و ۶۰ است. اما این مقایسه دو چیز را تغییر داده: هم frame و هم کلید مرتبسازی. بنابراین نباید تمام اختلاف را فقط به نام ROWS نسبت بدهیم. ترتیب اتفاقی peerها در یک اجرا هم قرارداد مطمئن برای ردیف برنده نیست.
افزودن id خودش معنای peer را عوض میکند
در کنترل سوم، frame پیشفرض را نگه میداریم و ORDER BY t,id مینویسیم. چون id یکتا است، دو ردیفِ t=1 دیگر در همهٔ کلیدهای ترتیب برابر نیستند؛ جمعها دوباره ۳۰ و ۶۰ میشوند. این برابریِ نتیجه برای همین داده است، نه اثبات برابری عمومی ROWS و RANGE.
برای RANGE عددیِ دارای offset، SQLite یک expression در ORDER BY میخواهد. query با t,id و RANGE 2 PRECEDING واقعاً اجرا و با OperationalError رد میشود؛ متن خطا در فایل نتیجه موجود است. افزودن یک کلید دوم برای رفع تساوی، همیشه با قرارداد فاصلهٔ عددی سازگار نیست. اول باید مشخص کنیم شمارش ردیف میخواهیم یا فاصلهٔ مقدار.
حدود این آزمایش را حفظ کنیم
نسخهٔ اجرای واقعی SQLite ۳٫۵۳٫۱ و Python ۳٫۱۲٫۱۴ است. همهٔ جدولها در حافظه ساخته میشوند؛ هیچ query روی CRM، سایت یا پایگاه مشتری اجرا نشده است. queryها ORDER BY بیرونیِ صریح هم دارند، چون ترتیب استفادهشده برای محاسبهٔ پنجره، جای قرارداد نمایش نهایی را نمیگیرد.
NULL، collation متنی، منطقهٔ زمانی، روز کاری، EXCLUDE و SQL جریانی در این تمرین سنجیده نشدهاند. خودِ ردیف جاری داخل این جمعها است؛ بنابراین خروجی را ویژگیِ صرفاً گذشته برای پیشبینی معرفی نمیکنیم. درستبودن این پنج محاسبه نیز کیفیت یک گزارش تجاری یا نبود همهٔ نشتهای اطلاعاتی را ثابت نمیکند.
این صفحه کدام نیاز را ادامه میدهد؟
راهنمای ROW_NUMBER و آخرین ردیف یک ردیف کامل را از هر گروه انتخاب میکند؛ اینجا عضویتِ یک aggregate را میسنجیم. در Lag و Rolling با زمان دسترسی، هدف جاری از ویژگی پیشبینی کنار گذاشته میشود؛ آن مسئله با جمع گذشتهنگرِ شاملِ ردیف جاری فرق دارد.
برای ادامه در مبانی هوش مصنوعی، تعریف پنجره و واحد داده را همراه نمونه ثبت کنید. اگر نیاز گزارش اجرایی دارید، زمان دسترسی اطلاعات و قواعد شاخص را با مسئول همان پروژه روشن کنید. این تمرین وجود پنجرهٔ SQL یا قابلیت گزارش خاصی در محصول اپرا را اعلام نمیکند؛ خروجی مفیدش، روشی قابل تکرار برای تشخیص اختلاف دو تعریف است.
فایل تمرین و منبع
کدِ کاملِ محلیِ تمرین و کنترلهایش · دادهٔ اصیل و نتیجهٔ اجرای واقعی؛ نویسههای کنترلی escape شدهاند
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.