
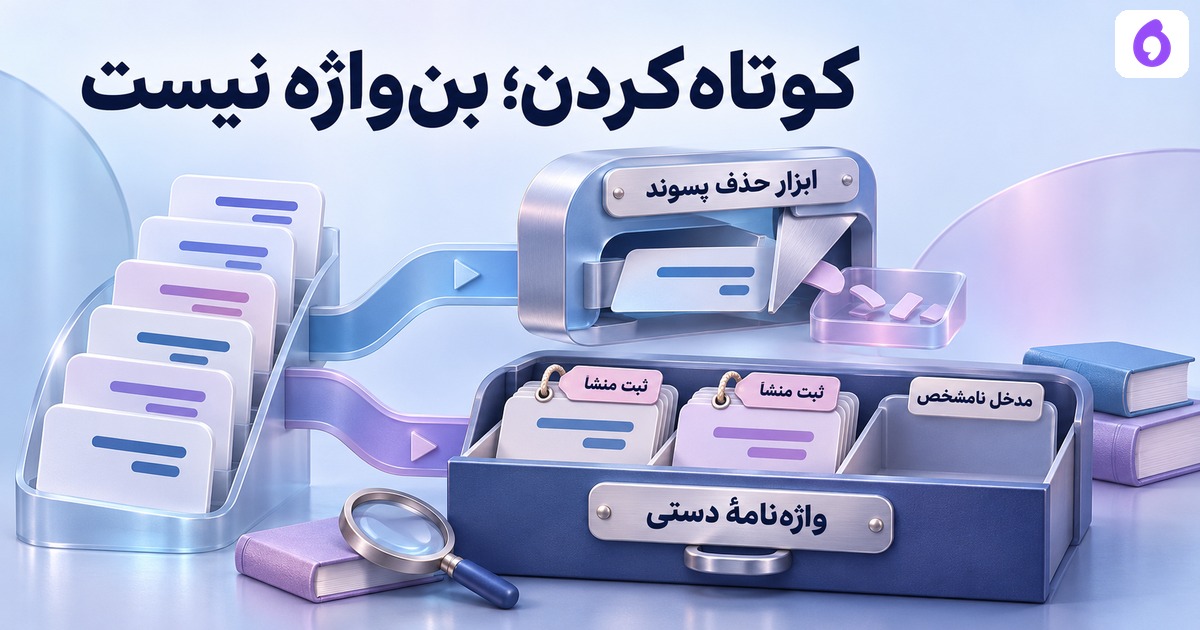
ریشهیابیِ محاسباتی یا stemming معمولاً با قواعد، صورتِ واژه را کوتاه میکند؛ خروجی الزاماً مدخلِ قاموس نیست. بنواژهسازی یا lemmatization به صورتِ پایهٔ واژه میپردازد و ممکن است به واژهنامه، نقشِ دستوری و بافت نیاز داشته باشد. «حذفِ چند حرف از آخر» را نباید خودکار تحلیلِ صرفیِ کامل نامید.
شش نمونه با منشأِ روشن
در این تمرین، دو قاعدهٔ آموزشیِ کوچک نوشتهایم و کنارشان شش بنواژه را خودِ نویسنده در جدول گذاشته است. هیچ موتورِ فارسی نصب یا اجرا نشده و نامِ Hazm یا Snowball به خروجیِ ما نسبت داده نمیشود. جدولِ دستی مرجعِ همین تمرین است، نه فرهنگِ کاملِ زبان.
| واژه در بافتِ نمونه | خروجیِ دو قاعدهٔ محدود | بنواژهٔ جدولِ دستی |
|---|---|---|
| کتابها روی میز هستند | کتاب | کتاب |
| کتابهای تازه رسیدند | کتاب | کتاب |
| آنها به خانه میروند | میروند | رفتن |
| آنها دیروز رفتند | رفتند | رفتن |
| شیراز مقصد این جمله است | شیراز | شیراز |
| امیدوارم آماده باشد | باشد | بودن |
دو صورتِ فعلِ رفتن در جدولِ دستی به یک مدخل وصل شدهاند، اما تابعِ پسوندِ ما اصلاً چنین قاعدهای ندارد. ثابتماندنِ «میروند» خطای پنهانِ موتور نیست؛ محدودیتِ صریحِ همان دو قاعده است. برای فعلها، نامِ lemma و شیوهٔ نمایشِ بنِ حال/گذشته میتواند بین ابزارها فرق کند؛ قراردادِ نسخهٔ منتخب را بخوانید.
دو قاعده دقیقاً چه میکنند؟
فقط پسوندهایِ نیمفاصلهدارِ «های» و «ها» را حذف میکنیم، به شرطِ باقیماندنِ دستکم سه نقطهٔ کد. نامِ قاعده و قطعهٔ حذفشده ثبت میشود. واژهٔ بدونِ این جداکننده، پیشوندِ فعل، نقشِ دستوری و شکلِ حروف را دست نمیزنیم. ترتیبِ دو پسوند هم مشخص است تا صورتِ بلندتر زودتر بررسی شود.
حذفِ بیقیدِ دو حرفِ «ها» از «اژدها»، رشتهٔ «اژد» میسازد؛ کد همین ضدنمونه را کنترل میکند. نسخهٔ محدودِ ما در این واژه هیچ تغییری نمیدهد. از این یک محافظ نتیجه نمیگیریم همهٔ نامها یا واژههایِ همپایان حفظ میشوند؛ فرهنگِ استثنا و قواعدِ واقعی مسئلهای بزرگتر است.
جدولِ دستی را با خروجیِ موتور مخلوط نکنیم
کلیدِ جدولِ آموزشی، واژه همراهِ جمله است. این کار نشان میدهد نتیجه باید به بافتِ موردِ بررسی وصل بماند؛ اما خودِ برنامه بافت را تحلیل نمیکند. وقتی «نوشتهها» در جملهٔ تازه به جدول داده شود، lemma ناموجود میماند؛ تابعِ پسوند میتواند «نوشته» بسازد، ولی این خروجی بهتنهایی مدخلِ تأییدشدهٔ قاموس نیست.
مستندِ اصلیِ Snowball فارسی، مجموعهای از قواعد، نگهبانِ طول و استثناهایِ واژگانی را شرح میدهد. ما آن الگوریتم را بازپیاده یا اجرا نکردهایم؛ فقط با خواندنِ آن، مرزِ قاعدهٔ کوچک و تحلیلِ واقعی را روشن کردهایم. فایلِ همراه نتیجهٔ هیچ کتابخانهٔ دیگری را جعل نمیکند.
برای جستوجو یا دستهبندی چه چیزی بسنجیم؟
قواعدِ تبدیل میتوانند دو صورتِ مفید را همخانواده کنند یا دو واژهٔ متفاوت را بیجهت یکی کنند. هدف، واژههایِ مرزی و نامهایِ مهم را با متنِ اصلی نگه دارید. حذفِ کلماتِ توقف واژهٔ کامل را کنار میگذارد؛ اینجا خودِ صورتِ واژه تبدیل میشود. TF-IDF هم وزندهیِ مرحلهٔ بعد است، نه تحلیلِ صرفی.
برای متنِ درخواستهایِ مشتری، چند صورتِ مجاز و خروجیِ مطلوب را در راهاندازیِ چتِ اپرا مطرح کنید. این تمرین کیفیتِ فارسیِ یک موتور یا روشِ داخلیِ محصول را تأیید نمیکند.
فایل تمرین و منبع
دو قاعدهٔ محدودِ پسوند در برابر جدولِ بنواژهٔ دستی · شش بافت، ردِ قاعده و منشأِ دستیِ بنواژه
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.