
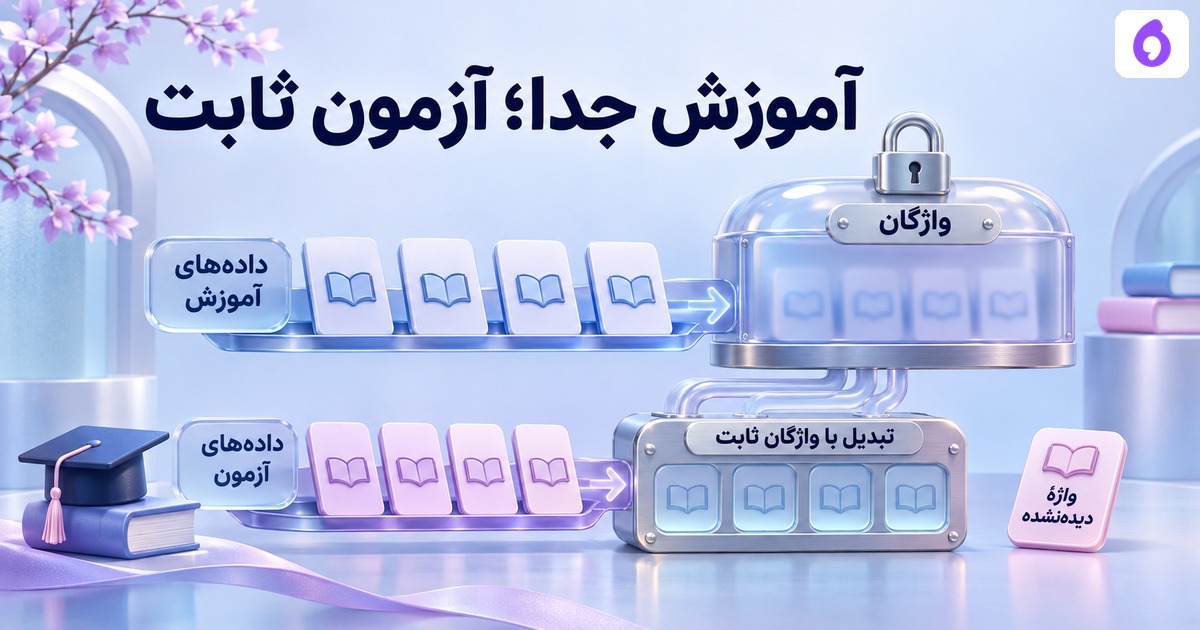
برای دستهبندیِ متن، اتصالِ درستِ مراحل به اندازهٔ خودِ الگوریتم اهمیت دارد. واژهنامه را فقط از آموزش بسازید، متنِ آزمون را با همان حالت تبدیل کنید و پیشبینی را بدونِ آموزشِ دوباره بگیرید. اینجا چنین قراردادی را با کتابخانهٔ استانداردِ پایتون واقعاً اجرا کردهایم؛ این کد Pipelineِ scikit-learn یا سامانهٔ آمادهٔ دستهبندیِ مشتری نیست.
از یک تابعِ طبقهبندی تا قراردادِ چند مرحله
تمرکزِ این صفحه فرمولِ تازهٔ طبقهبند نیست. برای مرحلهٔ آخر از یک Naive Bayes شمارشیِ کوچک با هموارسازیِ یک استفاده میکنیم؛ روشِ آن در مثالِ شمارشیِ بیز توضیح داده شده است. خروجیِ تازهٔ این تمرین، قفلکردنِ واژهنامه و حالت، جداکردنِ شناسههایِ منبع و ردِ چند استفادهٔ نادرستِ fit است.
چهار ردیفِ آموزشی با شناسههایِ R1 تا R4 داریم: دو متنِ ساختگی برای «تحویل» و دو متن برای «پرداخت». هر ردیف، شناسهٔ منبع و برچسبِ دستی دارد. چهار ردیفِ جدا با T1 تا T4 برای آزمون نگه داشتهایم؛ هیچ متن یا برچسبِ مشتریِ واقعی در فایل نیست.
fit فقط از چهار ردیفِ مجاز میخواند
در این قراردادِ عمداً محدود، تابعِ fit فقط فهرستِ دقیقِ شناسههایِ آموزشی را میپذیرد. علامتِ split باید train باشد؛ شناسهٔ منبعِ مشترک با بخشِ آزمون نیز رد میشود. افزودنِ ردیفِ آزمون یا تغییرِ صرفِ برچسبِ split آن به train، مجوزِ ورودش به آموزش نمیسازد.
شناسهٔ منبع باید درست تعریف شده باشد. این کنترل، دو متنِ مشابه با شناسهٔ متفاوت را خودکار کشف نمیکند؛ اگر یک گفتوگو را با دو شناسه به هر دو بخش ببرید، ثبتِ اشتباه میتواند محافظ را بیاثر کند. آزمونِ ما فقط قراردادِ صریحِ همین دادهها را کنترل میکند، نه نبودِ تمامِ انواعِ نشت.
transform ستونِ تازه نمیسازد
مدل با tupleها در یک dataclassِ frozen نگه داشته میشود. واژهنامه و شمارشِ کلاسها از چهار ردیفِ آموزش ساختهاند. transform برای متنِ تازه همان ستونها را میسازد و واژهٔ بیرونی را جدا گزارش میدهد. «آزمایشی» فقط در T1 آمده است؛ پس از همهٔ پیشبینیها هم به واژهنامه وارد نمیشود.
هشِ حالت پیش و پس از هر ردیف برابر مانده و تلاشِ انتسابِ واژهنامهٔ تازه رد شده است. این تغییرناپذیری یک قراردادِ برنامهنویسی است، نه مرزِ امنیتی در برابرِ کدِ خصمانه یا دستکاریِ عمدیِ درونِ محیطِ اجرا.
نتیجهٔ چهار ردیف، همراهِ خطا و بیتصمیمی
| ردیف | مرجعِ دستی | پیشبینی | نکته |
|---|---|---|---|
| T1؛ «بسته دیر آزمایشی» | تحویل | تحویل | واژهٔ تازه جدا گزارش شد |
| T2؛ «مبلغ رسید» | پرداخت | پرداخت | همان حالتِ ثابت استفاده شد |
| T3؛ «مبلغ» | تحویل | پرداخت | خطا نسبت به مرجعِ ساختگی؛ متنِ کوتاه مبهم است |
| T4؛ فقط واژهٔ ناشناخته | پرداخت | بیتصمیم | هیچ ستونِ شناختهشدهای فعال نیست |
برچسبِ T3 را نویسنده برای یک درخواستِ فرضیِ مربوط به تحویل تعیین کرده است، ولی خودِ تکواژهٔ «مبلغ» آن بافت را منتقل نمیکند. این مورد برای آشکارکردنِ نیاز به بافت و بازبینی نگه داشته شده؛ شاهدِ خطایِ عمومیِ زبانِ فارسی نیست. بیتصمیمیِ T4 هم در ستونِ جدا میماند و پیشبینیِ درست شمرده نمیشود.
چهار جهشِ نامعتبر واقعاً رد شدند؟
دادنِ آموزش و آزمون با هم به fit، جازدنِ یک ردیفِ آزمون بهعنوانِ train، همپوشانیِ شناسهٔ منبع و انتسابِ حالتِ تازه، هر چهار در کد رد شدهاند. ماتریسِ همراه، سطرِ مرجع و ستونِ پیشبینی دارد؛ در مجموع دو تطابق، یک خطا و یک بیتصمیمیِ آموزشی داریم. از این چهار متن، دقتِ واقعیِ محصول یا برتریِ روش نتیجه نمیگیریم.
مرجعِ اصلی دربارهٔ نشتِ داده توضیح میدهد چرا تبدیلِ آموختنی باید فقط از بخشِ آموزش یاد بگیرد. در نمونهٔ TF-IDF نیز همین مرز برای آمارِ واژه مهم است؛ اینجا کنترلِ اجراییِ اتصالِ مراحل را افزودهایم.
برای ارجاعِ درخواستهایِ مشتری، دستهها، مواردِ مبهم و مسیرِ انسانی را در بررسیِ راهکارهایِ اپرا مطرح کنید. پیادهسازیِ این تمرین روشِ داخلیِ اپرا یا قابلیتِ نصبشدهٔ حسابِ شما را توصیف نمیکند.
فایل تمرین و منبع
قراردادِ محلیِ آموزش، تبدیل و پیشبینی با حالتِ تغییرناپذیر · شناسهٔ منبع، هشِ حالت، ماتریس و ردِ نشتِ آزمایشی
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.