
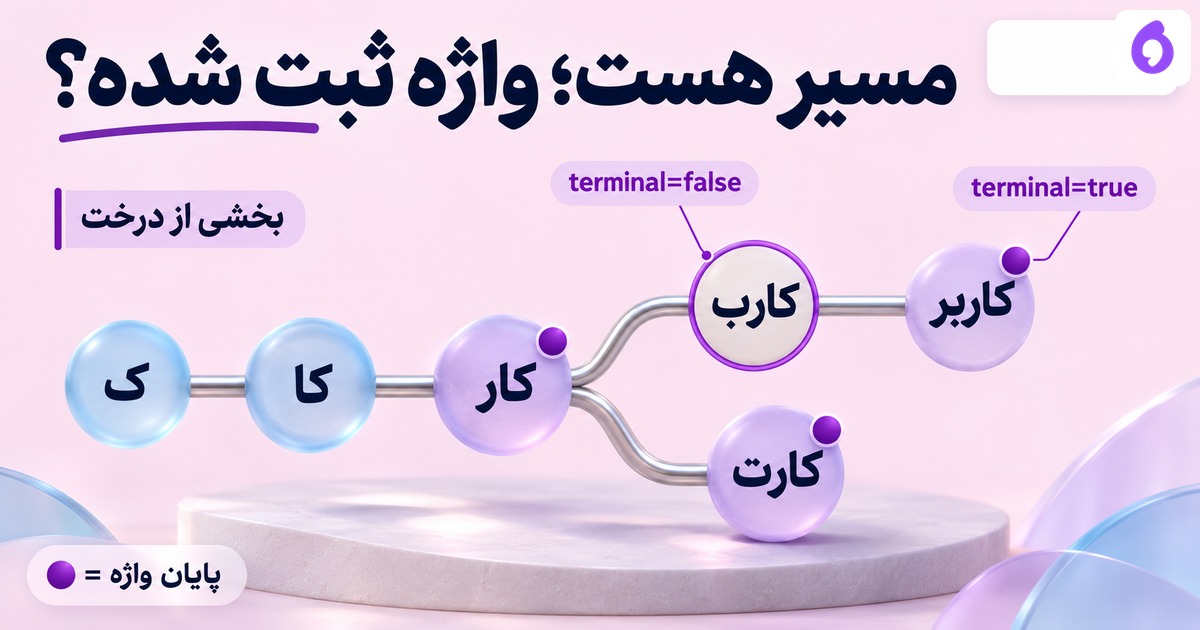
درختِ پیشوندی Trie مسیرهای مشترکِ واژهها را نگه میدارد، اما وجودِ یک مسیر به معنیِ ثبتشدنِ خودِ واژه نیست. علامتِ terminal این دو را جدا میکند. این تمرین یک فرهنگِ اصیلِ فارسی را میسازد و هم عضویتِ دقیق و هم خروجیِ پیشوند را با مرجعِ مستقل میسنجد.
فرهنگِ کوچک با پیشوندهایِ مشترک
واژههایِ «کار»،«کاربر»،«کارگاه» و«کارت» بخشِ آغازینِ مشترک دارند. «ی»،«ي»،«میروم»،«میروم» و رشتهٔ خالی هم عمداً در فرهنگ گذاشته شدهاند. این فهرست، دادهٔ مشتری یا فرهنگِ کاملِ فارسی نیست؛ برای آشکارشدنِ مرزهایِ قرارداد انتخاب شده است.
هر node یک دیکشنریِ children و یک پرچمِ terminal دارد. از ریشه، برای هر code point جلو میرویم؛ اگر فرزندِ مربوط موجود باشد همان node را استفاده میکنیم، وگرنه node تازه ساخته میشود. پایانِ واژه، terminalِ nodeِ همان مسیر را روشن میکند.
شاهدِ مسیرِ موجود و عضویتِ ناموجود
پرسوجویِ «کارب» تا nodeِ موجود میرسد، چون ابتدایِ «کاربر» است. ولی terminalِ آن روشن نیست؛ contains باید false باشد. همان پرسوجو در خروجیِ prefix، فهرستِ «کاربر» را میدهد. این سه مشاهده در فایل با path_indices،path_exists وexact_member جدا ثبت شدهاند.
در مقابل، خودِ «کار» هم terminal دارد و هم فرزند. terminalبودن قرار نیست مسیر را متوقف یا فرزندان را پاک کند. اگر فقط برگها را واژه بشماریم، «کار» را از دست میدهیم؛ اگر همهٔ مسیرها را واژه بشماریم، «کارب» را اشتباه اضافه میکنیم.
پیشوند را پیدا کنیم، بعد زیرشاخه را بخوانیم
تابعِ prefix ابتدا مسیرِ خودِ پیشوند را طی میکند. اگر مسیر نبود، فهرستِ خالی برمیگرداند. اگر بود، از همان node پیمایش میکند؛ هر terminal یک نتیجه میسازد و traversal از فرزندانِ مرتب ادامه مییابد. خروجی فقط یک واژهٔ دلخواه یا نزدیکترین واژه نیست.
ترتیبِ خروجی، ترتیبِ code pointِ یونیکد در Python است؛ ترتیبِ فرهنگنامهایِ فارسی یا رتبهبندیِ بر اساسِ محبوبیت نیست. تعداد و متنِ همهٔ نتیجهها در این fixture محدود است، اما کلاس سقفِ عمومیِ تعدادِ واژهها ندارد؛ هزینهٔ فهرستِ خروجی را نیز نمیتوان مستقل از اندازهٔ آن نامید.
ورودیِ تکراری و رشتهٔ خالی
«کار» را یک بارِ دیگر درج میکنیم. تعدادِ nodeها تغییر نمیکند و همان عضویت باقی میماند؛ این رفتارِ درجِ تکراری واقعاً کنترل شده است. برای رشتهٔ خالی، خودِ ریشه terminal میشود، چون خالی را صریحاً جزوِ فرهنگ تعریف کردهایم.
پیشوندِ خالی در این قرارداد تمامِ واژههایِ ثبتشده، از جمله خالی را برمیگرداند. نباید این رفتار را بدونِ تصمیم به همهٔ فرمهایِ جستوجویِ محصول تعمیم داد؛ آنجا میتوان قراردادِ دیگری برای ورودیِ خالی تعریف کرد.
فارسی را بدونِ نرمالسازی پنهان بررسی کنیم
«ی» و«ي» دو code pointِ متفاوتاند و در این کد جدا باقی میمانند. «میروم» با نیمفاصله و«میروم» بدونِ آن هم دو کلیدند. هیچ پاکسازی،تبدیلِ نویسه،فاصلهگذاری یا فهمِ معنایی اجرا نمیشود؛ این تفاوتها خطایِ تصادفیِ trie نیستند.
منبعِ Javaِ Princeton از آرایهٔ۲۵۶راهی برای نویسههایِ ASCII توسعهیافته استفاده میکند. کدِ فارسیِ این صفحه پیادهسازیِ دیکشنریِ مستقلِ Python است؛ پشتیبانیِ یونیکد را به همان Java نسبت نمیدهیم و آن فایل را اجرا نکردهایم.
تمامِ پرسوجوها را با فرهنگِ ساده بسنجیم
تمامِ پیشوندهایِ واقعیِ فهرست و چند ورودیِ غایب،۲۳پرسوجو میسازند. خروجیِ prefix با sortedِ واژههایی که startswith دارند وcontains با عضویتِ set برابر میشود. بولین،None و رشتهٔ۱۷نویسهای رد شدهاند؛ سقفِ هر ورودی۱۶code point است.
آهو–کوراسیک رخدادِ الگوها در متن را مییابد وfailurelink دارد؛ اینجا از متنِ بلند پیمایش نمیکنیم. KMP هم پرسشِ الگویِ معلوم دارد. ادامه در مبانی هوش مصنوعی؛ این فرهنگِ کوچک، جستوجویِ معنایی یا قابلیتِ واقعیِ چتِ اپرا نیست.
فایل تمرین و منبع
کد مستقلِ تمرین و کنترلها؛ Python · ورودیها و تمام خروجی واقعیِ همین تمرین؛ JSON
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.