
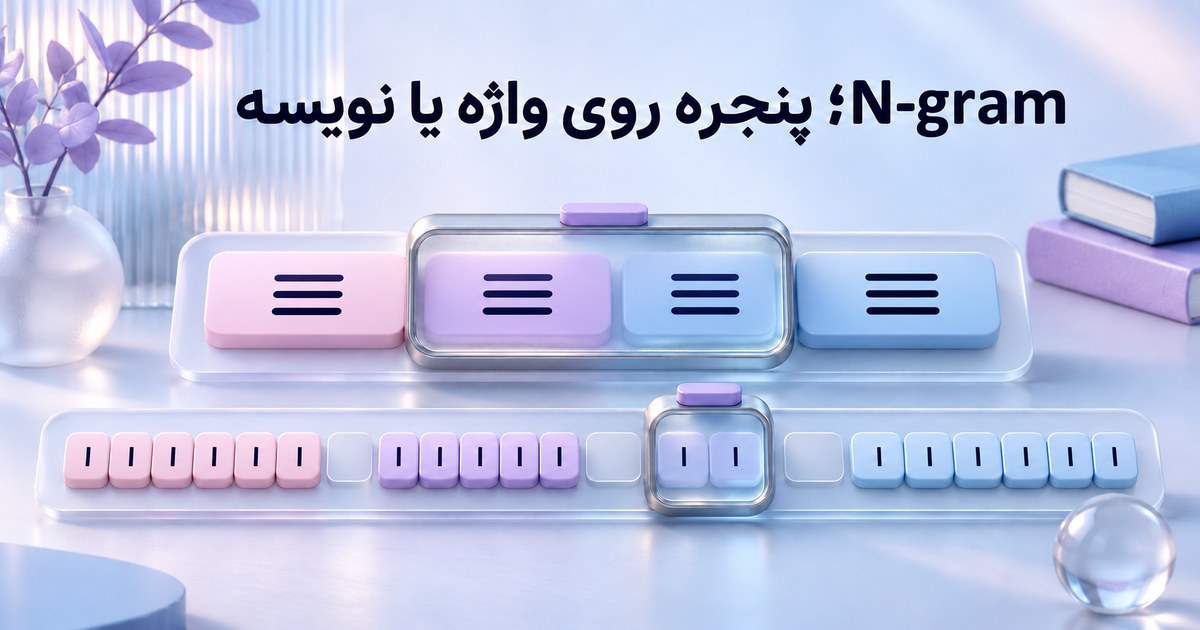
N-gram یک پنجرهٔ nتایی از واحدهای پشتسرهم است؛ واحد میتواند واژه یا نویسه باشد. پیش از شمردن، باید واحد و رفتارِ فاصله را مشخص کنید. در این تمرین فارسی، واژه را با split روی فاصله و نویسه را بهصورت نقطهٔ کد Unicode تعریف کردهایم؛ این دو خروجی یکی نیستند.
مثال واژهای: چهار واژه، سه bigram
از «این کتاب خوب است» چهار واحد میگیریم: این، کتاب، خوب، است. پنجرهٔ دوواژهای سه خروجی دارد: (این،کتاب)، (کتاب،خوب) و (خوب،است). پنجرهها همپوشانی دارند و هر بار فقط یک جایگاه جلو میروند. برای طول L و nمجاز، تعداد برابر max(۰,L−n+۱) است؛ این تعداد با تعداد ترکیبهای دلخواهِ nعضو فرق دارد.
Unigram فقط یک واحد، bigram دو واحد و trigram سه واحدِ پیاپی است. اگر ورودی یک واژه داشته باشد و n=۲باشد، خروجی این قرارداد خالی است؛ برای پُرکردن پنجره، واحدِ ساختگی یا مرز آغاز و پایان اضافه نکردهایم.
مثال نویسهای: فاصله هم یک واحد است
رشتهٔ «این کتاب» هشت نقطهٔ کد، شامل فاصله، دارد. با n=۲هفت پنجره میگیریم؛ از جمله (ن،فاصله) و (فاصله،ک). بنابراین پنجره میتواند از مرز واژه عبور کند. این کد char_wb کتابخانهٔ scikit-learn نیست؛ روشِ محدود به مرز واژه و padding، قرارداد متفاوتی دارد.
در «میکنم»، نیمفاصلهٔ U+200Cهم یک نقطهٔ کد است و طول این رشته در Python۶است؛ شش واحد الزاماً شش نشانهٔ دیداریِ مستقل نیست. ترکیبنویسهها و شکل ظاهری را با شمارش code point یکی نگیرید. این تمرین Unicode را نرمال یا نیمفاصله را حذف نمیکند.
نمایش با n-gram چه اطلاعاتی دارد؟
در «کتاب خوب نیست»، bigram(خوب،نیست) با(خوب،است) فرق دارد. بنابراین این نمایش بعضی همسایگیهای محلی را نگه میدارد که شمارش جداگانهٔ واژهها نمیبیند. با این حال، فهرست n-gram یا شمارش آن، فهمِ کامل جمله یا نگاشت صحیحِ نفی به همهٔ موضوعها را تضمین نمیکند.
ساختن پنجره و وزندادن به ویژگی دو مرحلهاند. TF-IDF روی مجموعهٔ کوچک فارسی دربارهٔ وزنِ رخداد در سند و مجموعه است؛ این مقاله خودِ واحدهای پنجرهای را تولید میکند. سنجههای BLEU و ROUGE از شمارش همپوشانی n-gram استفاده میکنند، اما هدفِ سنجه با تعریفِ ویژگی یکی نیست.
فایل را چطور تغییر دهیم؟
Python واقعاً سه bigram واژهای، هفت bigram نویسهای و دو جملهٔ دارای تفاوت نفی را کنترل کرده است. مقدارهای صفر، منفی، bool و غیرصحیح برای nرد میشوند. برای تمرین، n=۳را روی همان جمله اجرا کنید و ابتدا تعدادِ مورد انتظار را دستی بنویسید؛ بعد سیاست مرز و فاصله را عوض کنید و تفاوت خروجی را جدا گزارش دهید.
این کد توکنایزر مدل زبانی یا مدل دستهبندی نیست و خطای املایی را اصلاح نمیکند. برای متن واقعی، قرارداد علائم، نویسههای فارسی و واحد شمارش باید با دادهٔ آموزش و اجرای بعدی سازگار بماند. بیشترکردن nممکن است تعداد ویژگیها و تنکی را تغییر دهد؛ نتیجهٔ کیفیت را باید با دادهٔ جدا سنجید.
قدم بعد
برای فهم تفاوت این واحدها با مصرف مدل، توکن در متن فارسی را بخوانید. اگر مسئلهٔ شما پاسخگویی به سؤالهای سایت است، نمونهٔ پرسش، منبع مجاز و معیار پاسخ را در مسیر چت سایت اپرا روشن کنید؛ این مثال معماری یا قابلیتِ داخلی محصول را اعلام نمیکند.
فایل تمرین و منبع
ساخت n-gram با واحد صریحِ واژه یا نقطهٔ کد · مثالها و قرارداد فاصله/نیمفاصله؛ مدل آموزش ندیده است
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.