
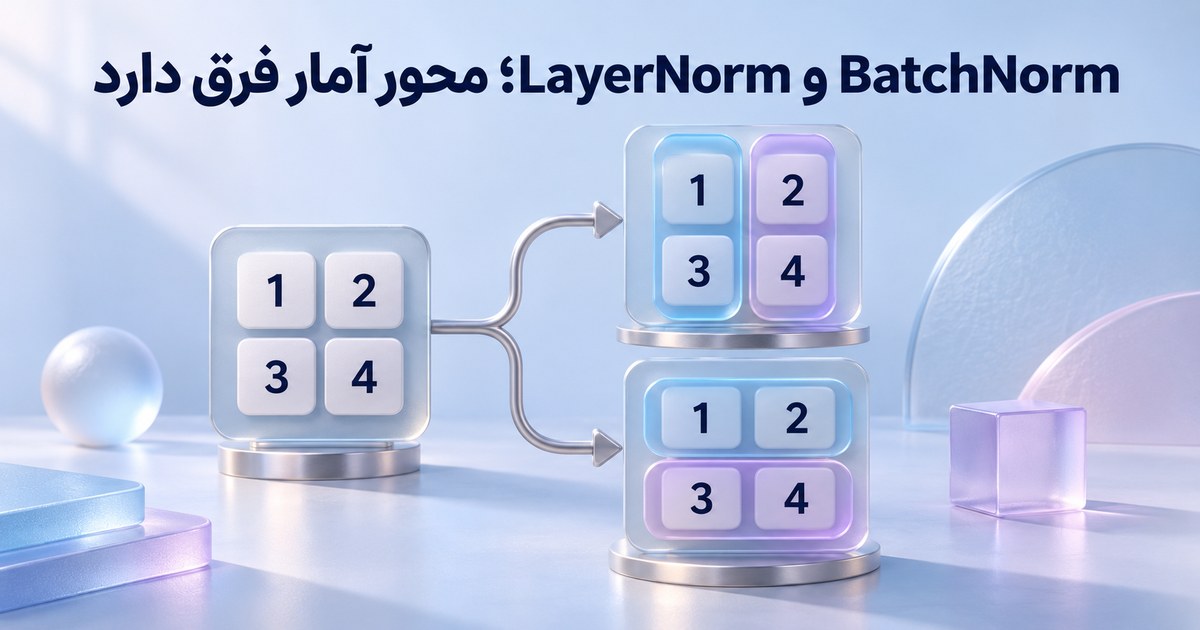
BatchNorm و LayerNorm فقط دو نام برای استانداردسازی یک ستون نیستند. محور محاسبهٔ آمار فرق دارد و رفتار آموزش و ارزیابی هم باید مشخص باشد. روی ماتریس کوچک دو نمونه و دو ویژگی، خروجی هر دو را حساب میکنیم؛ سپس فقط نمونهٔ دوم را عوض میکنیم تا وابستگی به همدسته دیده شود.
شکل ورودی و قرارداد محاسبه
ماتریس ساختگی [[1,3],[5,7]] شکل N×C دارد: هر ردیف یک نمونه و هر ستون یک ویژگی است. در هر دو محاسبه، واریانس از جمع مربع فاصلهها تقسیم بر تعداد مقدارها ساخته میشود. برای سادهبودن اعداد، epsilon را عمداً ۱ میگذاریم؛ این مقدار، پیشفرض کتابخانه یا پیشنهاد تنظیم برای مدل نیست. ابتدا gamma=۱ و beta=۰ هستند.
فرمول هر مقدار (x-mean)/sqrt(variance+epsilon) است. افزودن epsilon زیر ریشه را حذف نکنید؛ با این قرارداد، واریانس خروجی الزاماً دقیقاً یک نمیشود. دادهها نیز صرفاً با این تبدیل، دارای توزیع نرمال نمیشوند.
BatchNorm در آموزش: آمار هر ستون در دسته
ستون اول ۱ و ۵ است؛ میانگین۳ و واریانس۴ دارد. ستون دوم ۳ و۷ است؛ میانگین۵ و واریانس۴ دارد. پس خروجیِ پیش از affine برابر [[-2/√5,-2/√5],[2/√5,2/√5]] است؛ مقدار قدرمطلق تقریباً۰٫۸۹۴۴۲۷ میشود. این حساب برای ورودی دوبعدیِ همین مثال است؛ در شکلهای دیگر باید محورهای کاهش را جدا مشخص کرد.
LayerNorm: آمار ویژگیهای هر نمونه
اینجا normalized_shape=(۲,) انتخاب شده، بنابراین دو مقدارِ انتهاییِ هر ردیف با هم نرمال میشوند. ردیف اول میانگین۲ و واریانس۱، و ردیف دوم میانگین۶ و واریانس۱ دارد. خروجی هر دو ردیف [-1/√2,1/√2]، تقریباً منفی و مثبت۰٫۷۰۷۱۰۷ است. «همهٔ محورهای ورودی» را جای normalized_shape نگذاشتهایم.
| محاسبه | آمار از کجا؟ | خروجی ردیف اول، گرد شده |
|---|---|---|
| BN، آموزش، ورودی N×C | هر ستون در دو نمونه | [-0.894427,-0.894427] |
| LN، شکل نرمالشونده (۲,) | دو ویژگی همان نمونه | [-0.707107,0.707107] |
آزمایشِ تغییر فقط همدسته
ردیف اول را نگه دارید و ردیف دوم را از [۵،۷] به [۹،۱۱] تغییر دهید. کد واقعاً کنترل میکند که خروجی LN ردیف اول ثابت بماند ولی خروجی BN آن عوض شود؛ چون آمار ستون تغییر کرده است. این نتیجه برای محورهای تعریفشدهٔ این مثال است، نه حکم یکسان برای هر آرایش tensor.
حالت ارزیابی و آمار ذخیرهشده را روشن بنویسیم
طبق مستندات PyTorch، BatchNorm با track_running_stats=True در ارزیابی از آمار جاریِ ذخیرهشده استفاده میکند؛ با False آمار دسته در ارزیابی هم به کار میرود. واریانس عبور آموزش با مخرج تعداد محاسبه میشود، اما مقدار واریانس برای بهروزرسانی running_var از برآورد با تصحیح نمونه استفاده میکند. این دو را یکی نگیرید. LayerNorm در هر دو حالت آمار ورودی را به کار میگیرد.
برای نمایش مسیر ارزیابی، میانگین ذخیرهشده را دستی [۰،۰] و واریانس را [۱،۱] فرض کردهایم؛ این اعداد از آموزش ماتریس بالا به دست نیامدهاند و کد هم بهروزرسانی running statistics را شبیهسازی نمیکند. با epsilon=۱، هر مقدار بر √۲ تقسیم میشود. این مثال فقط تفاوت «محاسبهٔ آمار از دسته» و «مصرف آمارِ ازقبلدادهشده» را نشان میدهد.
gamma و beta چه میکنند؟
پس از نرمالسازی میتوان مقدار را در gamma ضرب و beta را اضافه کرد. در تمرینِ جدا، برای دو ویژگی gamma=[۲،۱] و beta=[۰٫۵،−۰٫۵] گذاشتهایم؛ مقدار اول ردیف نخستِ BN تقریباً−۱٫۲۸۸۸۵۴ میشود. این پارامترها دستیاند، نه آموختهشده. شکل پارامترهای affine باید با لایه و محورِ تعریفشده سازگار باشد.
استانداردسازی ویژگی با آمار آموزش دربارهٔ تبدیل ورودی پیش از مدل است؛ این نوشته محور آمارِ لایه و قرارداد train/eval را بررسی میکند. رفتار Dropout در آموزش و ارزیابی هم سازوکار دیگری دارد و جای این لایهها نیست.
فایل بازتولید و قدم بعد
کد استاندارد Python هر دو خروجی، تغییرِ همدسته، مسیر ارزیابیِ دستی و affine را واقعاً آزموده است؛ PyTorch یا مدل آموزشدیده اجرا نشده و سرعت یا دقتی مقایسه نشده است. پیش از انتخاب واقعی، شکل tensor، محور آمار، اندازهٔ دسته و حالت اجرا را ثبت کنید و با اعتبارسنجی بسنجید. ادامهٔ مبانی در راهنمای هوش مصنوعی است؛ این مثال توصیف معماری محصولات اپرا نیست.
فایل تمرین و منبع
کد محاسبهٔ دو محور، تغییر همدسته و تبدیل affine · ماتریس، محور آمار و قرارداد صریحِ نمونهٔ ارزیابی
- مستندات رسمی BatchNorm1d؛ محور، واریانس و آمار ذخیرهشده
- مستندات رسمی LayerNorm؛ normalized_shape و رفتار ارزیابی
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.