
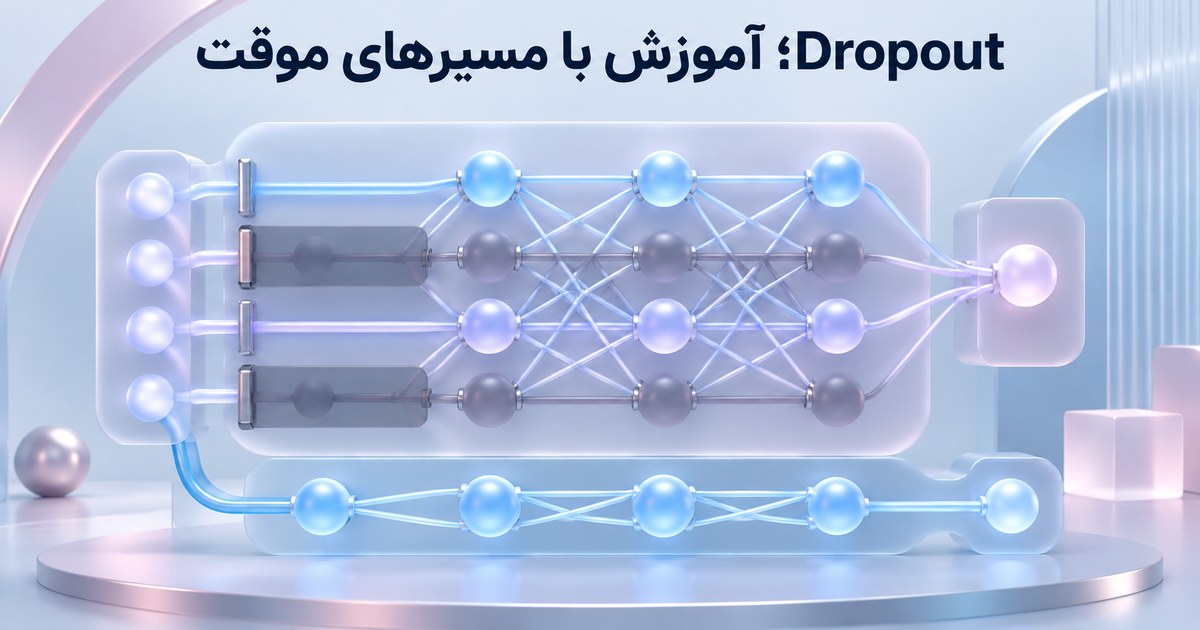
Dropout هنگام آموزش، بعضی خروجیهای یک لایه را بهطور تصادفی صفر میکند. در شکل رایجِ مقیاسشده، مقدارهای باقیمانده بزرگتر میشوند تا امید ریاضی خروجی حفظ شود. در حالت ارزیابیِ معمول، این لایه ورودی را بدون همین صفرکردن تصادفی عبور میدهد؛ مدل باید در حالت درست اجرا شود.
مثال چهار مقدار و احتمال نصف
بردار آموزشی ما [۱،۲،۳،۴] و احتمال حذف ۰٫۵ است. اگر ماسک [۱،۰،۱،۰] انتخاب شود، تقسیم مقدارهای باقیمانده بر ۰٫۵، خروجی [۲،۰،۶،۰] میسازد. مجموع این خروجی ۸ است، درحالیکه مجموع ورودی ۱۰ بود. حفظ امید ریاضی به معنی حفظ دقیقِ جمع در هر بار اجرا نیست.
برای چهار جایگاه مستقل با احتمال نصف، ۱۶ ماسک هماحتمال وجود دارد. هر جایگاه در هشت ماسک حفظ میشود؛ مثلاً مقدار ۳، هشت بار صفر و هشت بار ۶ خواهد بود. میانگین این ۱۶ خروجی دوباره ۳ میشود. این شمارش کامل، شبیهسازی دقت مدل یا شاهد بهبود فروش نیست؛ فقط قرارداد ریاضی همین لایه را نشان میدهد.
| حالت | خروجی برای نمونه | برداشت درست |
|---|---|---|
| آموزش با ماسک مشخص | [۲،۰،۶،۰] | یک تحقق تصادفی |
| میانگین همهٔ ماسکها | [۱،۲،۳،۴] | امید خروجی این تمرین |
| ارزیابی معمول | [۱،۲،۳،۴] | عبور بدون حذف تصادفی |
کد آموزشی با ماسک صریح
import itertools,math
def apply(values,p,mask,training=True):
    if not math.isfinite(p) or not 0<=p<=1:
        raise ValueError('probability must be in [0,1]')
    if len(values)!=len(mask) or any(m not in (0,1) for m in mask):
        raise ValueError('binary mask of matching length required')
    if not all(math.isfinite(x) for x in values):
        raise ValueError('finite inputs required')
    if not training or p==0:return list(values)
    if p==1:return [0.0]*len(values)
    return [x*m/(1-p) for x,m in zip(values,mask)]
x=[1.,2.,3.,4.]
y=apply(x,.5,[1,0,1,0])
all_y=[apply(x,.5,m) for m in itertools.product((0,1),repeat=4)]
mean=[sum(v[i] for v in all_y)/len(all_y) for i in range(4)]
print('one mask',y,'mean over 16 masks',mean)
assert y==[2.,0.,6.,0.] and mean==x
assert apply(x,.5,[0]*4,training=False)==x
assert apply(x,1,[1]*4)==[0.]*4
تابع عمداً ماسک را از ورودی میگیرد تا نتیجه قابل بازبینی باشد؛ خودش مولد تصادفی کتابخانه نیست. در آموزش واقعی، ماسک در فراخوانیهای بعدی نمونهگیری میشود. کد برای احتمال صفر و یک رفتار جدا دارد تا تقسیم بر صفر رخ ندهد. این مثال، برابری بیتی با پیادهسازی PyTorch یا تمام انواع Dropout را ادعا نمیکند.
نورون از مدل پاک نمیشود
صفرشدن موقت یک خروجی با حذف دائمی وزنها تفاوت دارد. فایل مدل همان ساختار را نگه میدارد و در فراخوانی بعدی ممکن است جایگاه دیگری صفر شود. اگر خروجی ارزیابی ناپایدار است، حالت train/eval را در کنار منابع دیگر تصادف بررسی کنید. در PyTorch، eval حالت لایههایی مانند Dropout را عوض میکند؛ غیرفعالکردن محاسبهٔ گرادیان کار جداگانهای است.
میتوانید محاسبهٔ یک شبکهٔ کوچک را در مثال شبکه عصبی ببینید. اینجا تمرکز بر رفتار یک لایه است، نه مسیر محاسبهٔ وزن یا پسانتشار خطا. برای مقایسهٔ نرخهای حذف، نسخهٔ داده، معماری و بودجهٔ آموزش را ثبت کنید و تصمیم را با اعتبارسنجی بگیرید؛ نرخ بزرگتر الزاماً بهتر نیست.
سؤال عملی پیش از استفاده
مشخص کنید مشکل، یادگیری ناکافی است یا فاصلهٔ عملکرد آموزش و اعتبارسنجی. صرف اضافهکردن Dropout تشخیص علت نیست. اگر هدف شما ساخت یک خدمت پاسخگوی مشتری است، ابتدا ورودی، پاسخ مجاز و مسیر ارجاع را در راهنمای شروع با تیم اپرا روشن کنید؛ این آموزش پیشنهاد تنظیم داخلی مدلهای محصول اپرا نیست.
فایل تمرین و منابع
دریافت کد مستقل این راهنما. دادهها ساختگی و آموزشیاند؛ کد اتصال شبکه، فایل شخصی یا فراخوانی سرویس ندارد.
تاریخ مطالعهٔ منبع: ۳ نوامبر ۲۰۲۶. محاسبهها و مثال این مطلب برای آموزش طراحی شدهاند.