
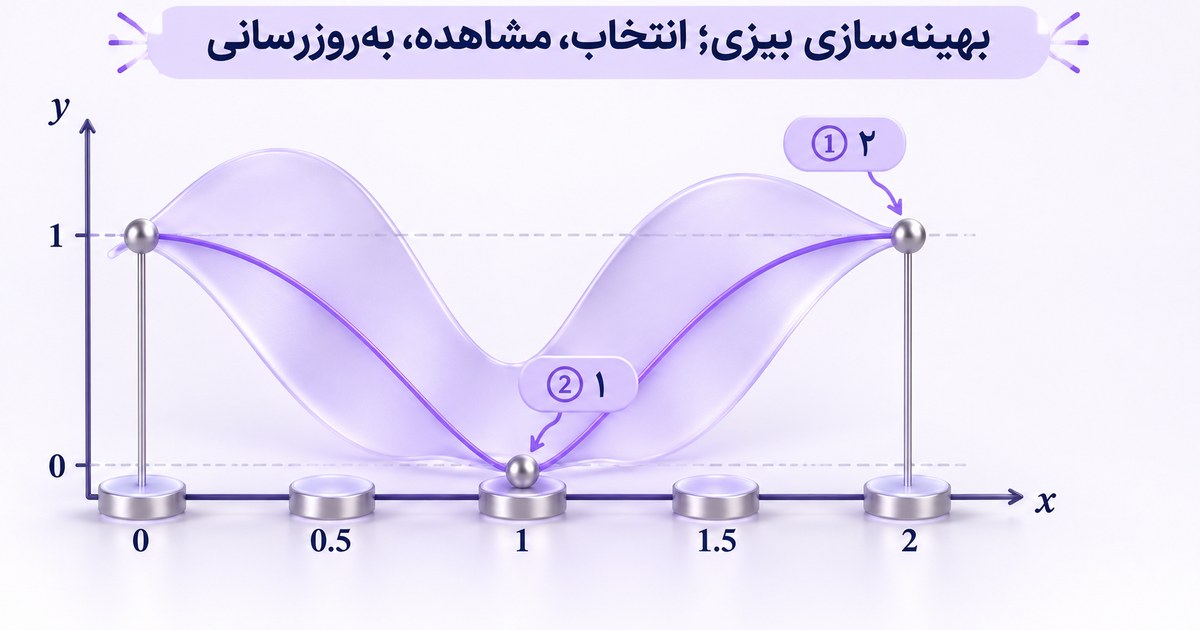
بهینهسازیِ بیزی برای انتخابِ آزمایشِ بعدی، از یک مدلِ جانشین و قاعدهٔ انتخاب استفاده میکند. پس از مشاهدهٔ نتیجه، جانشین بهروز میشود و انتخابِ بعدی میتواند تغییر کند. اینجا میانگین و واریانسِ یک جانشینِ کوچک را واقعاً از مشاهدهها محاسبه میکنیم؛ جدولِ حدسهایِ دستی را «مدل» ننامیدهایم.
مسئله و بودجهٔ کاملاً ساختگی
میخواهیم f(x)=(x-1)² را رویِ پنج نقطهٔ صفر، نیم، یک، یکونیم و دو کمینه کنیم. یک مشاهدهٔ آغازین در x=0 داریم و فقط دو نقطهٔ دیگر انتخاب میکنیم. تابع برای همین تمرین نوشته شده و فراخوانیِ آن هزینهٔ API، آموزشِ مدلِ بیرونی یا دادهٔ مشتری ندارد.
جانشین، فرایندِ گاوسی با میانگینِ پیشینِ صفر و کرنلِ exp(-0.5×(a-b)²) است. دامنه و طولمقیاسِ کرنل از قبل ثابتاند. به قطرِ ماتریس ۰٫۰۱ اضافه میکنیم؛ این فرضِ نویزِ جانشین است، نه نویزِ اندازهگیریشدهٔ تابع. خودِ تابعِ تمرین قطعی است و هیچ ابرپارامتری برازش نشده است.
پسین را از دستگاهِ واقعی حساب کنیم
برای نقطهٔ نامزد، بردارِ شباهتِ کرنل به مشاهدههایِ قبلی ساخته میشود. با حلِ دستگاهِ ماتریسِ کرنلِ دارایِ قطرِ افزوده، میانگینِ شرطی و واریانسِ تابعِ پنهان را حساب میکنیم. کد از معکوسِ دستیِ چاپشده استفاده نمیکند؛ حلِ عددی را اجرا و باقیماندهٔ دستگاه را کنترل میکند.
واریانسِ گزارششده مربوط به تابعِ پنهان در همین جانشین است؛ واریانسِ یک مشاهدهٔ نویزیِ آینده نیست. مقدارِ منفیِ قابلِ توجه رد میشود و فقط خطایِ بسیار کوچکِ گردکردن در محدودهٔ کنترل به صفر محدود میشود. این حلِ کوچک، توصیهٔ عددیِ عمومی برای دستگاههایِ بزرگ نیست.
قاعدهٔ انتخاب؛ میانگین منهای یک انحرافِ معیار
برای کمینهسازی، امتیازِ انتخاب را میانگینِ پسین منهای یک برابرِ انحرافِ معیار میگذاریم و کوچکترین را انتخاب میکنیم. بخشِ میانگین به نتیجهٔ پیشبینیشده توجه دارد؛ بخشِ عدمقطعیت میتواند یک نقطهٔ کمترشناختهشده را جذاب کند. ضریبِ یک، انتخابِ آموزشیِ ماست و تضمینِ اعتماد یا کیفیت نمیسازد. اگر امتیاز دقیقاً مساوی شود، x کوچکتر برنده است.
| مرحله | مشاهدههایِ پیش از انتخاب | x انتخابشده | مقدارِ واقعاً محاسبهشدهٔ تابع |
|---|---|---|---|
| آغاز | هنوز مشاهدهای نیست | ۰، انتخابِ اولیهٔ ثابت | ۱ |
| انتخابِ اول | ۰→۱ | ۲ | ۱ |
| انتخابِ دوم | ۰→۱ و ۲→۱ | ۱ | ۰ |
پس از انتخابِ اول، مقدارِ تابع در دو واقعاً حساب و به مشاهدهها اضافه میشود؛ پسینِ مرحلهٔ دوم از هر دو نقطه استفاده میکند. بعد از مشاهدهٔ نقطهٔ یک نیز پسینِ تازه ثبت شده است. در مجموع، با آغازِ ثابت سه بار تابع فراخوانی شده؛ نتیجهٔ نقاطِ مشاهدهنشده پنهانی واردِ جانشین نشده است.
فایلِ ردِ محاسبه چه چیزی دارد؟
JSON برایِ همهٔ نامزدهایِ هر دور، میانگین، واریانس، انحرافِ معیار و امتیازِ انتخاب را نگه میدارد. پسینِ پس از مشاهده هم ثبت شده است. میتوانید یک دادهٔ قبلی یا فرضِ کرنل را عوض کنید و انتخاب را دوباره بسنجید؛ اما تغییرِ نتیجه را به «هوشمندترشدنِ قطعی» تعبیر نکنید.
این انتخاب در همین مثال به نقطهٔ کمینهٔ دامنه رسیده است. هیچ قضیهٔ تضمینِ بهترین نقطه با دو گام، مقایسهٔ سرعت، صرفهجوییِ هزینه یا برتری بر جستوجویِ دیگر آزمایش نشده است. BoTorch، PyTorch و کتابخانهٔ GP نیز اجرا نشدهاند؛ مرجعها برایِ تعریفِ حلقه و فرمولِ پسین خوانده شدهاند.
انتخابِ نامزد با سنجشِ نهایی فرق دارد
شبکه و جستوجویِ تصادفی طرحِ انتخابهایِ ازپیشتعریفشده را میسازد؛ اینجا مشاهدهٔ قبلی رویِ انتخابِ بعد اثر میگذارد. پیشین و پسین نیز زمینهٔ مفهوم را روشن میکند. برایِ نیازِ واقعیِ پاسخگویی، معیارِ پذیرش و دادهٔ مجاز را در راهکارهایِ اپرا مطرح کنید؛ مثال روشِ تنظیمِ داخلیِ محصول را اعلام نمیکند.
فایل تمرین و منبع
پسینِ واقعیِ GP کوچک، انتخابِ نقطه و دو بهروزرسانی · همهٔ میانگینها، واریانسها، انتخابها و مشاهدههایِ تابع
- مرجع اصلی GPML، ۲۰۰۶؛ بخشِ ۲٫۲ و روابطِ ۲٫۲۰ تا ۲٫۲۴ برایِ پسینِ گاوسی
- راهنمایِ اصلیِ حلقهٔ انتخاب، مشاهده و بهروزرسانی؛ تابعِ acquisition این تمرین متفاوت و BoTorch اجرا نشده است
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.