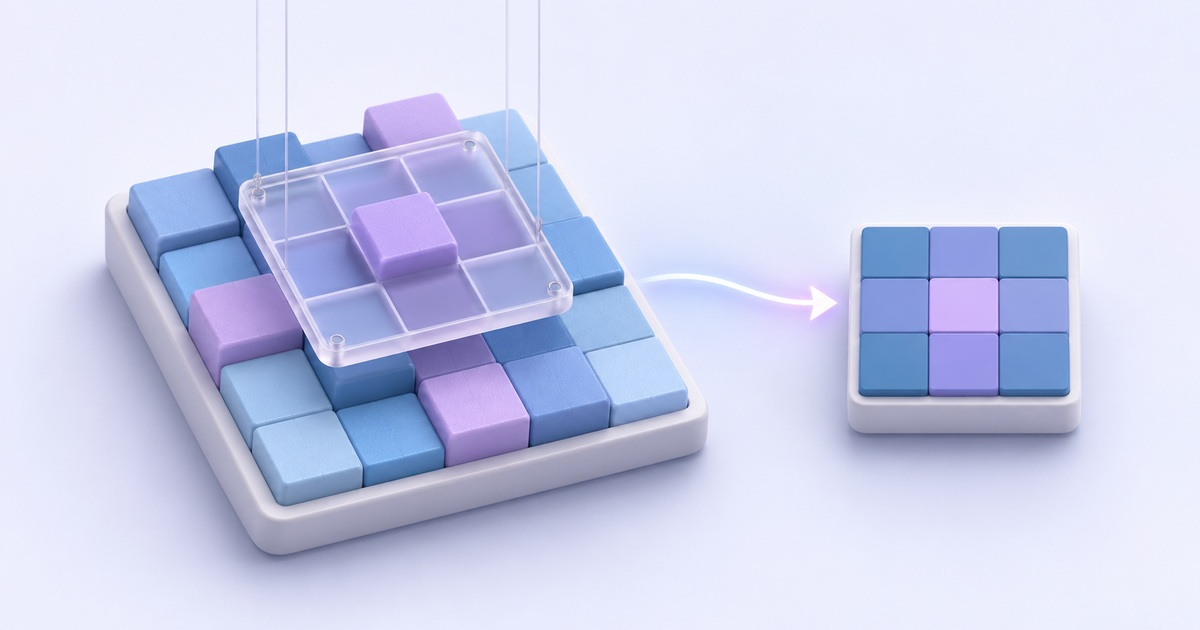
CNN یا شبکه عصبی کانولوشنی، از فیلترهای محلی برای ساخت نمایشهای تازه از ورودی استفاده میکند. برای فهم یک لایه، میتوان فیلتر کوچکی را روی یک ماتریس حرکت داد و هر خانه خروجی را حساب کرد. این تمرین یک لایه و چند عمل ساده را نشان میدهد؛ شناسایی شیء یا آموزش یک مدل بینایی انجام نمیدهد.
یک ورودی سهدرسه و فیلتر دودردو
ورودی ما سه ردیف [۱، ۲، ۰]، [۰، ۱، ۳] و [۲، ۰، ۱] دارد. برای تمرین، آن را یک تصویر تککاناله عددی فرض میکنیم. فیلتر دو ردیف [۱، −۱] و [۰، ۱] دارد و بایاس صفر است. وزنها را خودمان انتخاب کردهایم؛ از تصویری آموخته نشدهاند.
گام حرکت یا stride برابر ۱ است و دور تصویر چیزی اضافه نمیکنیم؛ یعنی padding نداریم. هر پنجره دودردو در یک جای معتبر ورودی قرار میگیرد، در وزنهای فیلتر ضرب میشود و جمع آن یک خانه خروجی میسازد. همان وزنهای فیلتر برای همه جایگاهها استفاده میشوند.
چهار جایگاه را دستی حساب کنیم
| جایگاه پنجره | جمع ضربها | نتیجه |
|---|---|---|
| بالا چپ | ۱×۱ +۲×(−۱)+۰×۰+۱×۱ | 0 |
| بالا راست | ۲×۱+۰×(−۱)+۱×۰+۳×۱ | 5 |
| پایین چپ | ۰×۱+۱×(−۱)+۲×۰+۰×۱ | −۱ |
| پایین راست | ۱×۱+۳×(−۱)+۰×۰+۱×۱ | −۱ |
پس نقشه ویژگی دو ردیف [۰، ۵] و [−۱، −۱] دارد. ابعاد خروجی برای همین حالت برابر (۳−۲)+۱ یعنی ۲ در هر جهت است. این فرمول ساده را به حالت dilation، padding یا stride متفاوت تعمیم بیحساب ندهید.
در عمل متداول لایه Conv2d مورد ارجاع، فیلتر هنگام حرکت برعکس نمیشود؛ نام دقیق این محاسبه cross-correlation است. کانولوشن ریاضی با وارونهکردن فیلتر قرارداد دیگری دارد. کد این مقاله همان حالت بدون وارونهکردن را صریح اجرا میکند.
ReLU و pooling چه چیزی را عوض میکنند؟
اگر ReLU را اعمال کنیم، دو مقدار منفی صفر میشوند و خروجی [۰، ۵] و [۰، ۰] است. سپس max pooling با یک پنجره دودردو، مقدار بزرگتر یعنی ۵ را انتخاب میکند. در این مرحله چهار خانه به یک عدد میرسند؛ اطلاعات موقعیت دقیق بیشینه در خروجی عددی ما باقی نمانده است. از این ۵ نمیتوان نام شیء یا درصد اطمینان استخراج کرد.
کد کامل بدون کتابخانه جانبی
image = [[1, 2, 0], [0, 1, 3], [2, 0, 1]]
kernel = [[1, -1], [0, 1]]
# Cross-correlation, stride=1, no padding, one input channel.
feature = [[sum(image[i+a][j+b]*kernel[a][b]
                for a in range(2) for b in range(2))
            for j in range(2)] for i in range(2)]
relu = [[max(0, value) for value in row] for row in feature]
pooled = max(value for row in relu for value in row)
print('feature', feature)
print('ReLU', relu, 'max pool', pooled)
assert feature == [[0, 5], [-1, -1]]
assert relu == [[0, 5], [0, 0]] and pooled == 5
کد برای ابعاد ثابت همین مثال نوشته شده است؛ ورودی دلخواه، فایل عکس یا کانال رنگی را بارگذاری نمیکند. برای تصویر چندکاناله، وزنها و جمع روی کانالها هم لازماند. مقایسه با تصویر خام نیز باید با همان واحد، ترتیب کانال و قاعده آمادهسازی انجام شود.
از این لایه تا یک مدل واقعی
یک CNN کامل میتواند چندین لایه و خروجی هدف داشته باشد. دانستن نام CNN نمیگوید یک سامانه همه نوشتههای تصویر را درست میخواند. حدود مدل چندوجهی درباره سنجش وظیفه واقعی است؛ این مطلب سازوکار یک عملیات محلی را محاسبه کرد. شبکه عصبی کوچک هم نقش وزن و فعالسازی را در یک ساختار دیگر نشان میدهد.
برای تمرین، وزن بالا راست را صفر کنید و چهار خانه خروجی را دوباره حساب کنید. تغییر عددها نشاندهنده تغییر فیلتر است؛ نتیجه آموزش موفق نیست. اگر نیاز سازمان شما دریافت و پاسخگویی به درخواست مشتری است، نوع ورودی و خروجی مطلوب را در مسیر خدمات اپرا مشخص کنید؛ این راهنما قابلیت پردازش تصویر مشخصی در اپرا اعلام نمیکند.
فایل تمرین و منابع
دریافت کد کامل این تمرین؛ این فایل فقط از کتابخانه استاندارد پایتون استفاده میکند. ورودیهای آن ساختگی و برای بازتولید محاسبهاند؛ اجرای آموزشی آن نتیجه یک محصول یا مشتری را نشان نمیدهد.
تاریخ بررسی منابع: ۳ نوامبر ۲۰۲۶. منابع، مرجع روشاند؛ دادهها، اعداد و کد مثال برای همین راهنما طراحی شدهاند.