
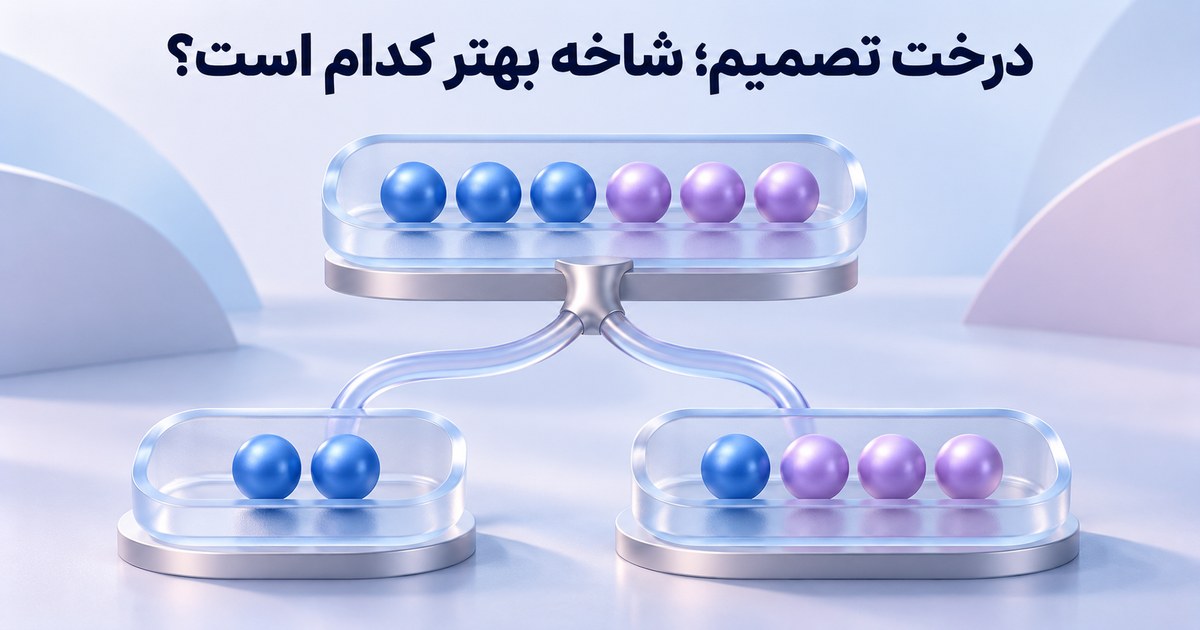
درخت تصمیم با سؤالهای پیاپی روی ویژگیها، نمونهها را به شاخهها میفرستد. در طبقهبندی، یک راه انتخاب سؤال این است که مخلوطبودن دستهها پس از تقسیم کمتر شود. اینجا فقط یک گره را با معیار Gini میسازیم تا معلوم شود آستانه از کجا میآید؛ ساختن چند قانون دلخواه با یادگیری درخت از داده یکسان نیست.
ناخالصی Gini یعنی چه؟
اگر سهم هر کلاس در یک گره p باشد، Gini برابر ۱ منهای مجموع مربع این سهمهاست. گرهای که همه نمونههایش یک کلاس دارند Gini صفر دارد. دو کلاس هماندازه در همین تعریف مقدار ۰٫۵ میدهند. این سنجه، درصد دقت یا شاخص کیفیت کسبوکار نیست؛ برای مقایسه مخلوطبودن کلاسها در تقسیم گره به کار میرود.
داده آموزشی و سؤالهای ممکن
شش مقدار مرتبشده x از ۱ تا ۶ داریم؛ برچسبهایشان بهترتیب ۰، ۰، ۱، ۱، ۱ و ۰ است. اینها نمونه آموزشی بدون اطلاعات شخصیاند. در ریشه سه نمونه از هر کلاس داریم و Gini ریشه ۰٫۵ میشود. سؤال نمونه «آیا x کمتر یا مساوی ۲٫۵ است؟» دو ردیف را چپ و چهار ردیف را راست میفرستد.
چپ خالص است، پس ناخالصی صفر دارد. در راست سه برچسب ۱ و یک برچسب ۰ داریم؛ Gini آن ۱−(۳÷۴)²−(۱÷۴)²=۰٫۳۷۵ است. چون اندازه شاخهها برابر نیست، میانگین ساده دو Gini نادرست است. مقدار وزنی برابر (۲÷۶)×۰+(۴÷۶)×۰٫۳۷۵=۰٫۲۵ خواهد بود.
| آستانه x | Gini وزنی دو شاخه |
|---|---|
| ۱٫۵ | ۰٫۴ |
| ۲٫۵ | ۰٫۲۵ |
| ۳٫۵ | ۰٫۴۴۴۴۴۴ |
| ۴٫۵ | ۰٫۵ |
| ۵٫۵ | ۰٫۴ |
در میان این گزینهها ۲٫۵ بهترین است و بهبود ناخالصی ۰٫۵−۰٫۲۵=۰٫۲۵ میشود. انتخاب محلی بهترین سؤال، تضمین بهترین درخت ممکن در همه عمقها نیست. در این مثال محدود، همه آستانههای میان مقادیر متمایز همین ویژگی بررسی شدهاند.
کد بررسی تمام آستانهها
from collections import Counter
x = [1, 2, 3, 4, 5, 6]
y = [0, 0, 1, 1, 1, 0]
def gini(labels):
    if not labels:
        raise ValueError('empty node')
    n = len(labels)
    return 1-sum((c/n)**2 for c in Counter(labels).values())
root = gini(y)
results = []
for lo, hi in zip(x, x[1:]):
    t = (lo+hi)/2
    left = [v for u, v in zip(x, y) if u <= t]
    right = [v for u, v in zip(x, y) if u > t]
    weighted = (len(left)*gini(left)+len(right)*gini(right))/len(y)
    results.append((t, weighted))
print('root', root)
print([(t, round(g, 6)) for t, g in results])
best = min(results, key=lambda item: item[1])
print('best', best, 'gain', root-best[1])
assert best == (2.5, 0.25) and root == 0.5
این قطعه، یک تقسیم را پیدا میکند؛ جای پیادهسازی کامل درخت، پشتیبانی وزن نمونه یا مدیریت داده ناموجود نیست. خروجی مورد انتظار آستانه ۲٫۵ و ناخالصی وزنی ۰٫۲۵ است. کد عمداً گره خالی را نمیپذیرد؛ گزینههای این مثال هر دو شاخه غیرخالی دارند.
درخت کوچک را چگونه بخوانیم؟
اگر همینجا متوقف شویم و در هر برگ کلاس اکثریت را انتخاب کنیم، برای x تا ۲٫۵ کلاس ۰ و برای مقادیر بزرگتر کلاس ۱ داریم. فقط ردیف x=۶ در داده تمرین اشتباه میشود. بنابراین ۵ از ۶ نتیجه درست صرفاً وضعیت همین تمرین است؛ برآورد دقت آینده نیست. درخت عمیقتر ممکن است این ردیف را هم جدا کند، ولی به داده تازه نیاز داریم تا ببینیم آن پیچیدگی سود دارد یا نه.
راهنمای بیشبرازش به همین فاصله میان حفظ تمرین و تعمیم میپردازد. این مطلب، بر خلاف آن، نحوه عددی انتخاب شاخه را نشان میدهد. برای تمرین، برچسب ردیف آخر را ۱ کنید و بررسی کنید کدام آستانه حالا دو برگ خالص میسازد.
قبل از استفاده از قانون چه چیزی لازم است؟
زمان دسترسی به ویژگی و پیامد خطای هر شاخه را ثبت کنید. قانونی که با داده پایان پرونده ساخته شده برای تصمیم ابتدای آن معتبر نیست؛ بررسی نشت آینده به گذشته را کنار آزمون نگه دارید. برای فرایند پاسخگویی، نمونهها و قواعد انسانی را در مسیر راهاندازی اپرا بررسی کنید؛ این درخت نمونه، سازوکار تأییدشده یک محصول اپرا نیست.
فایل تمرین و منابع
دریافت کد کامل این تمرین؛ این فایل فقط از کتابخانه استاندارد پایتون استفاده میکند. ورودیهای آن ساختگی و برای بازتولید محاسبهاند؛ اجرای آموزشی آن نتیجه یک محصول یا مشتری را نشان نمیدهد.
تاریخ بررسی منابع: ۳ نوامبر ۲۰۲۶. منابع، مرجع روشاند؛ دادهها، اعداد و کد مثال برای همین راهنما طراحی شدهاند.
ادامه مسیر یادگیری
KNN و اثر مقیاس روی فاصله — برای دیدن روشی که بهجای شاخه آستانهای از همسایه نزدیک استفاده میکند، مثال KNN را بخوانید.