
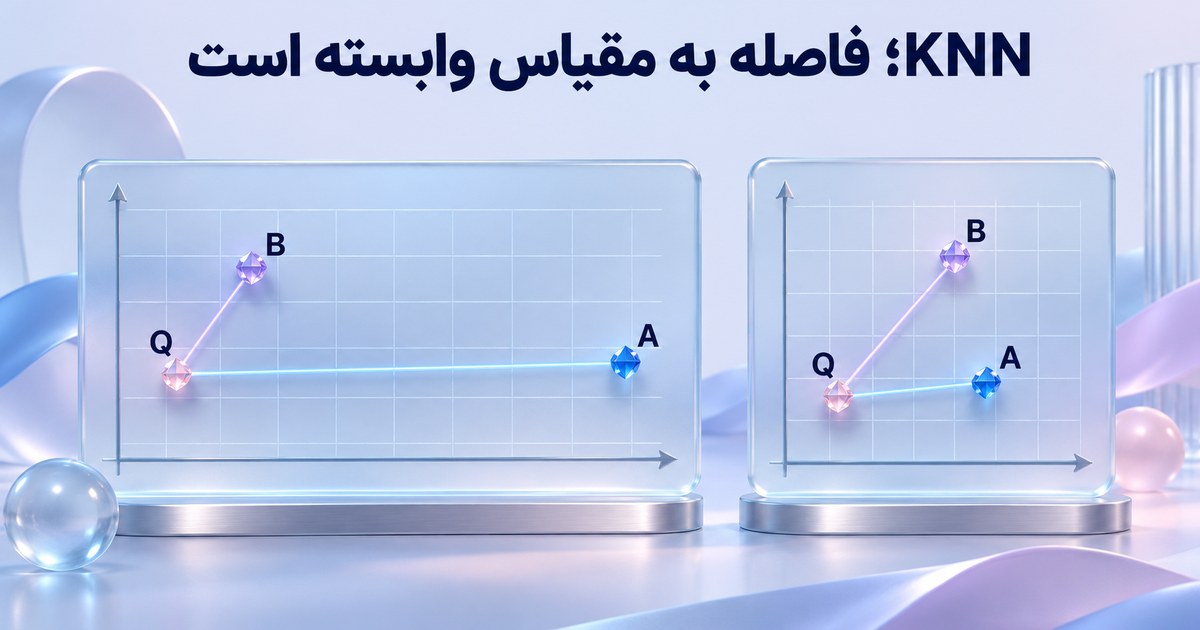
KNN یا K نزدیکترین همسایه، برای یک ورودی تازه نمونههای نزدیک در داده آموزش را پیدا میکند. در طبقهبندی، برچسب همسایهها مبنای تصمیم قرار میگیرد؛ در رگرسیون میتوان مقدارهای آنها را ترکیب کرد. نکته اصلی فقط انتخاب k نیست: تعریف فاصله و مقیاس هر ویژگی میتوانند عوض کنند چه نمونهای اصلاً «نزدیک» محسوب میشود.
یک مثال که برچسبش با مقیاس عوض میشود
دو نمونه آموزشی و یک ورودی تازه داریم. این تعداد برای نشاندادن محاسبه کافی است، نه برای ساخت یک طبقهبند معتبر. نام A و B فقط دو کلاس آموزشیاند و هیچ رتبه یا ارزش تجاری ندارند.
| نوع | ویژگی اول | ویژگی دوم |
|---|---|---|
| کلاس A | 0 | 1000 |
| کلاس B | 10 | 0 |
| ورودی تازه | 9 | 800 |
برای k=۱ و فاصله اقلیدسی خام، فاصله ورودی تا A برابر √(۹²+۲۰۰²)، حدود ۲۰۰٫۲۰۲۳۹۸ است. تا B برابر √(۱²+۸۰۰²)، حدود ۸۰۰٫۰۰۰۶۲۵ میشود. بنابراین نزدیکترین نمونه A است. ویژگی دوم بهدلیل عددهای بزرگتر، سهم بسیار بیشتری در این فاصله دارد؛ این برتری عددی لزوماً اهمیت واقعی بیشتر نیست.
فقط با دامنه آموزش مقیاس را تنظیم کنیم
برای تمرین، اختلاف هر ویژگی را بر دامنه همان ویژگی در داده آموزش تقسیم میکنیم: دامنه ویژگی اول ۱۰ و دوم ۱۰۰۰ است. این روش، استانداردسازی Z-score نیست. در فاصله جدید تا A، اختلافها ۰٫۹ و منفی ۰٫۲ و فاصله حدود ۰٫۹۲۱۹۵۴ است. تا B اختلافها منفی ۰٫۱ و ۰٫۸ و فاصله حدود ۰٫۸۰۶۲۲۶ میشود؛ حالا B نزدیکتر است.
در ساخت مدل واقعی، روش تبدیل باید روی آموزش برازش شود و همان تبدیل روی داده تازه اجرا شود. اضافهکردن ورودی تازه به محاسبه دامنه، قاعده فاصله را در زمان پیشبینی تغییر میدهد. درباره اهمیت ثبات این تبدیل، قرارداد ویژگی در آموزش و اجرای زنده را ببینید.
کد بازتولید دو تصمیم متفاوت
import math
train = [('A', (0.0, 1000.0)), ('B', (10.0, 0.0))]
query = (9.0, 800.0)
ranges = tuple(max(v[j] for _, v in train)-min(v[j] for _, v in train)
               for j in range(2))
assert all(r > 0 for r in ranges)
def rank(scales):
    distances = [(label, math.sqrt(sum(((a-b)/s)**2
                    for a, b, s in zip(query, point, scales))))
                 for label, point in train]
    return sorted(distances, key=lambda row: (row[1], row[0]))
raw = rank((1.0, 1.0))
scaled = rank(ranges)
print('raw', [(a, round(d, 6)) for a, d in raw])
print('scaled', [(a, round(d, 6)) for a, d in scaled])
assert raw[0][0] == 'A' and scaled[0][0] == 'B'
assert abs(scaled[0][1]-math.sqrt(0.65)) < 1e-12
در این قطعه، فاصلههای برابر با نام کلاس مرتب میشوند؛ این فقط یک قاعده آشکار برای همین تمرین است. در کاربرد واقعی باید سیاست تساوی و ترتیب همسایهها را مشخص کنید. کد برای دو ویژگی ثابت همین جدول نوشته شده و اعتبارسنج عمومی تعداد ستون یا مقدار نامعتبر ندارد.
k و رأی همسایهها را چگونه انتخاب کنیم؟
در این مثال فقط دو ردیف داریم و k=۱ را ثابت کردهایم. با داده بزرگتر، k کوچکتر ممکن است به نمونه منفرد حساستر شود و k بزرگتر مرزها را هموارتر کند؛ بهترین مقدار از این دو نقطه به دست نمیآید. اگر از رأی وزندار با فاصله استفاده میکنید، رفتار فاصله صفر و داده تکراری را هم تعیین کنید. انتخاب k و مقیاس را با داده اعتبارسنجی انجام دهید و آزمون نهایی را برای گزارش نگه دارید.
فاصله کوچک، تضمین شباهت معنایی دو متن یا صحت یک برچسب نیست. برای متن ابتدا باید نمایش ویژگی مناسب داشته باشید؛ تفاوت embedding و تولید متن کمک میکند بازیابی همسایه را با ساخت پاسخ یکسان نگیرید. KNN طبقهبندی روی داده برچسبدار، با کشف گروههای بدون برچسب هم یکی نیست؛ راهنمای روشهای نظارتشده و بدون نظارت این مرز را روشن میکند.
قدم بعد بهجای ادعای دقت
پیش از نسبتدادن نام مدل به کیفیت، چند نمونه مرزی، تعریف ویژگی و خطای تصمیم را ثبت کنید. برای نیاز پاسخگویی مشتری میتوانید این نمونهها را در مسیر خدمات اپرا مطرح کنید؛ این آموزش نمیگوید محصول اپرا از KNN استفاده میکند یا این دو نمونه کیفیت آن را نشان میدهند.
فایل تمرین و منابع
دریافت کد کامل این تمرین؛ این فایل فقط از کتابخانه استاندارد پایتون استفاده میکند. ورودیهای آن ساختگی و برای بازتولید محاسبهاند؛ اجرای آموزشی آن نتیجه یک محصول یا مشتری را نشان نمیدهد.
تاریخ بررسی منابع: ۳ نوامبر ۲۰۲۶. منابع، مرجع روشاند؛ دادهها، اعداد و کد مثال برای همین راهنما طراحی شدهاند.
ادامه مسیر یادگیری
K-means و جابهجایی مرکزها — همسایه برچسبدار با مرکز خوشه یکی نیست؛ مثال K-means نشان میدهد گروهها بدون برچسب مرجع چگونه ساخته میشوند.