
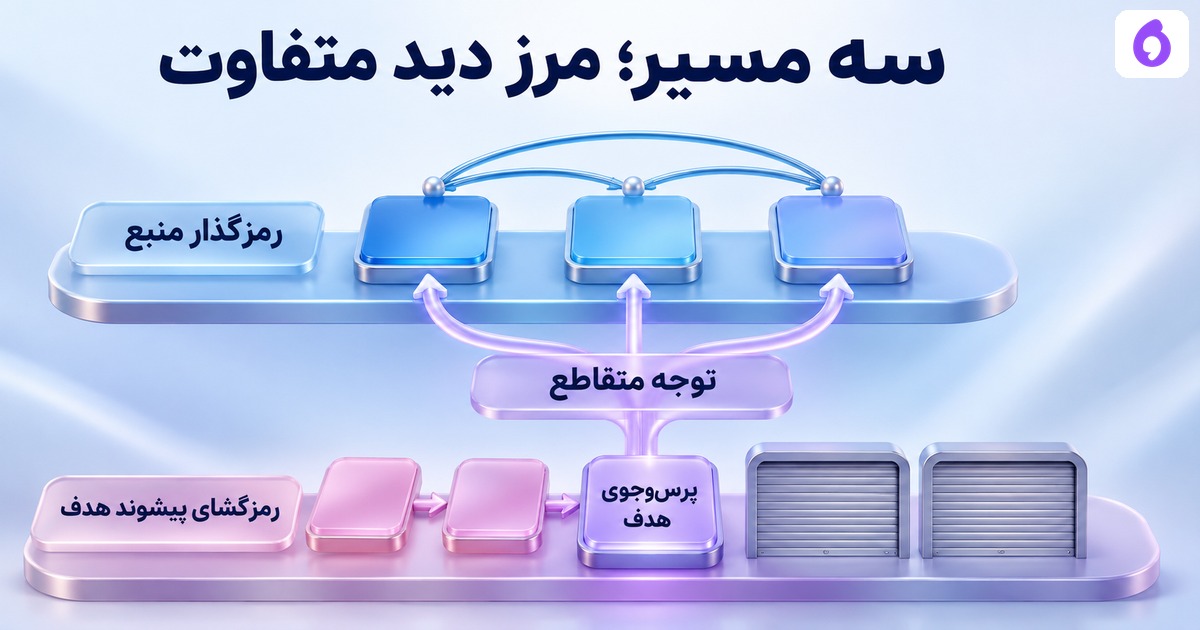
Encoder بازنماییِ ورودی را میسازد و Decoder خروجی را با اتکا به زمینهٔ مجاز تولید میکند. در ترنسفورمرِ encoder-decoder،رمزگشا هم به پیشوندِ خروجی و هم به بازنماییِ منبع دسترسی دارد؛ این دو مسیرِ توجه یکسان نیستند. برای فهمِ تفاوت،سه ماتریسِ «چه چیزی دیده میشود» میسازیم و اثرِ تغییرِ آینده را واقعاً حساب میکنیم.
سه مسیر را روی کاغذ جدا کنیم
در encoderِ دوطرفهٔ این مثال،هرکدام از سه جایگاه میتواند هر سه جایگاهِ منبع را ببیند. در self-attentionِ علّیِ decoder،جایگاهِ اول فقط اول،جایگاهِ دوم اول ودوم و جایگاهِ سوم هر سه را میبیند. در cross-attention،پرسوجو از ورودیِ هدف میآید و کلید/مقدار از منبع؛ هر سه جایگاهِ منبع برای هر پرسوجو مجازند.
| مسیر | منشأ Query | منشأ Key/Value | دیدِ این تمرین |
|---|---|---|---|
| Encoder self-attention | منبع | منبع | کلِ منبع |
| Decoder causal self-attention | هدفِ ورودی | هدفِ ورودی | پیشوند تا جایگاهِ جاری |
| Cross-attention | هدفِ ورودی | منبع | کلِ منبعِ مجاز |
این جدول برای همین معماریِ توصیفشده است؛ همهٔ مدلها چنین دو بخشِ جدا ندارند. مدلِ decoder-only میتواند زمینه وپیشوند را در دنبالهٔ خودش بگیرد؛ صرفِ دیدنِ نامِ یک کار،وجودِ cross-attentionِ جدا را ثابت نمیکند.
آیندهٔ خروجی نباید از کجا وارد شود؟
در تمرین،سه بردارِ دوبعدیِ ساختگی برای منبع وسه بردار برای هدف داریم. تبدیلهای Q/K/Vهویتیاند و وزنها با Softmaxِ امتیازِ ضربِ داخلیِ مقیاسشده محاسبه میشوند. برای مسیرِ علّی،وزنِ جایگاههایِ نامجاز دقیقاً صفر میشود. مثال Query،KeyوValue خودِ محاسبهٔ توجه را معرفی میکند؛ اینجا پرسش،مرزِ دیدِ سه مسیر است.
سپس بردارِ سومِ هدف را از[۰,۲]به[۱۰۰,۱۰۰]عوض میکنیم. دو خروجیِ نخست در self-attentionِ علّی دقیقاً ثابت میمانند؛ چون آن بردارِ آینده دیده نمیشود. در نسخهٔ بدونِ ماسک،همان دو خروجی تغییر میکنند. این شاهدِ عددیِ همین محاسبه است،نه نتیجهٔ آموزش یا فهمِ زبان.
جداگانه،بردارِ سومِ منبع را تغییر میدهیم؛ خروجیِ cross-attentionتغییر میکند. این بار دیدنِ کلِ منبع مجاز بوده است. منبعِ کامل را با آیندهٔ نامجازِ خروجی یکی نگیرید؛ نقشِ دنبالهها و زمانِ در دسترس بودنِ آنها تعیینکننده است.
دیدنِ جایگاهِ جاری با لو رفتنِ برچسب یکی نیست
در نمونهٔ teacher forcing،ورودیِ هدف[BOS،متن،خوب]و برچسبِ بعدی[متن،خوب،EOS]است. در جایگاهِ اول،ورودی BOSدیده میشود و «متن»هدفِ پیشبینی است؛ کلمهٔ درستِ بعدی نباید از آیندهٔ همان ورودی خوانده شود. جابهجاییِ ورودی/برچسب و ماسکِ درست دو کنترلِ جدا هستند.
در فایل،این توکنها فقط مثالِ قراردادند؛ واژهنامه،ترجمه،تابعِ زیان یا آموزشِ teacher forcingاجرا نشده است. همچنین padding،چندسر،لایهٔ feed-forward،اتصالِ باقیمانده وموقعیت در این محاسبهٔ کوچک پیاده نشدهاند. آن را مدلِ کاملِ Transformerننامید.
از معماری به آزمونِ کاربرد
کدگذاریِ موقعیت مسئلهٔ تشخیصِ ترتیب را جدا آزمایش میکند؛ ماسک هم میتواند ساختاری از ترتیب بدهد،اما جای همهٔ سازوکارهایِ موقعیت نیست. در خریدِ راهکار،نامِ معماری جای دادهٔ آزمون،منبعِ پاسخ و محدودیتِ عمل را نمیگیرد.
برای پاسخگوییِ مشتری،چند ورودیِ مجاز،پاسخِ موردِ انتظار ومواردِ نامعلوم را در راهکارهای اپرا مطرح کنید. این محاسبه معماریِ داخلیِ محصولات،اجرایِ TensorFlowیاکیفیتِ ترجمهٔ فارسی را اعلام نمیکند.
فایل تمرین و منبع
سه ماتریسِ دید و آزمایشِ واقعیِ تغییرِ آینده و منبع · ماسکها،خروجیهای عددی و قراردادِ ورودی/برچسبِ جابهجاشده
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.