
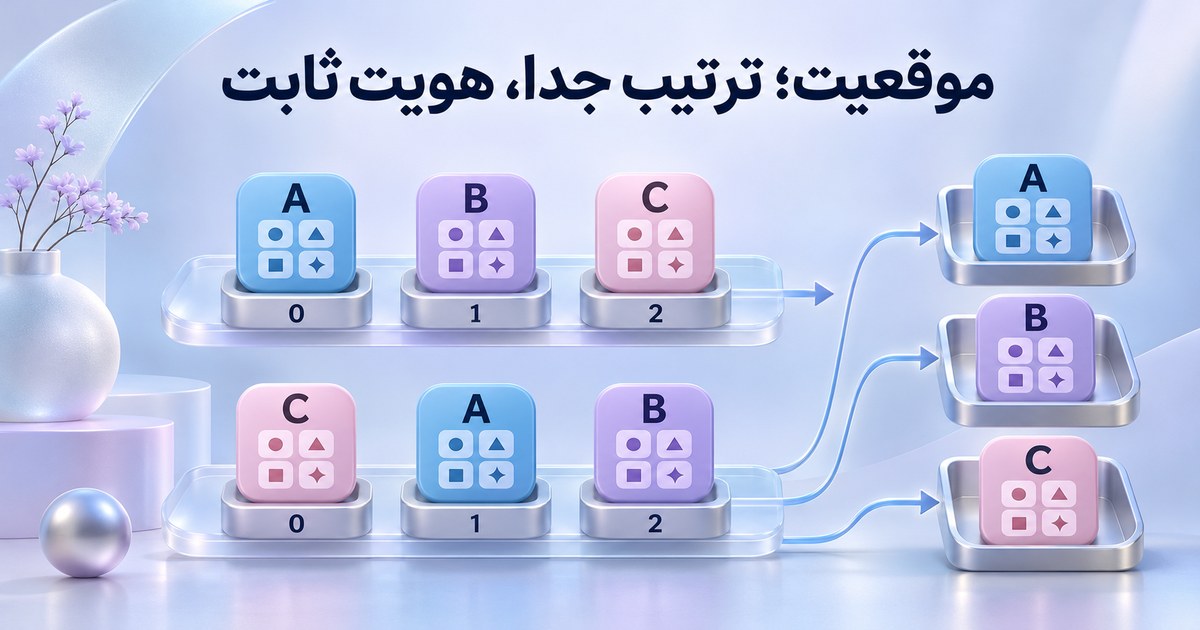
اطلاعات موقعیت به ترنسفورمر راهی میدهد که جایگاههای دنباله را از هم تشخیص دهد. برای دیدن اثرِ مشخص، سه توکنِ نمادین را جابهجا و یک self-attentionبدون ماسک و با تبدیلهای هویتی اجرا میکنیم؛ خروجیها را بر اساس هویت توکن همتراز میکنیم، نه فقط شمارهٔ ردیف. این تمرین مدلِ آموزشدیده یا tokenizerواقعی ندارد.
قراردادِ آزمایش را ثابت کنیم
بردارهای ساختگی A=[۱،۰،۰،۰]،B=[۰،۱،۰،۰]وC=[۰،۰،۱،۰]هستند. ترتیب اصلی A,B,Cو ترتیب تازه C,A,Bاست. در هر اجرا Q،KوVهمان ردیفهای ورودیاند؛ ماتریس تبدیلِ آموختهشده نداریم. امتیاز هر جفت، ضرب داخلی تقسیم بر√۴یعنی۲است و Softmaxپایدار وزنها را میسازد. هیچ causal maskیا ساختارِ دیگری برای محدودکردنِ ترتیب اضافه نشده است.
بدون موقعیت، equivariant یعنی چه؟
پس از جابهجایی ورودیِ بدونPE، ردیفهای خروجی هم با همان جایگشت جابهجا میشوند. وقتی خروجیِ C,A,Bرا به ترتیبِ هویت A,B,Cبرگردانیم، اختلافِ محاسبه کمتر از۱۰بهتوان−۱۲است. این را «هموردایی نسبت به جایگشت» میگویند؛ ادعا نمیکنیم ردیف شمارهٔ صفرِ هر دو ماتریس بدون همترازی باید همان توکن باشد.
به زبان عملی، در این آزمایشِ بدونِ اطلاعات ترتیب، تغییرِ جایگاهِ Aبهتنهایی سهمِ نهاییِ همترازشدهٔ Aرا عوض نمیکند. وجودِ ماسکِ علّی یا سازوکارِ موقعیتِ دیگر، قراردادِ دیگری میسازد؛ نتیجهٔ این حالت را به آنها تعمیم ندهید.
بردارهای sin/cosرا اضافه کنیم
از یک نمونهٔ چهاربعدیِ فرمولِ مقالهٔ اصلی استفاده میکنیم: PE(p)=[sin(p),cos(p),sin(p/100),cos(p/100)]. موقعیتها۰،۱و۲هستند و در هر ترتیب به همان جایگاههای دنباله داده میشوند. PE(۰)=[۰،۱،۰،۱]است؛ بردارِ موقعیت با بردارِ همان توکن جمع میشود. در اینجا بُعد۴را برای حسابِ کوچک انتخاب کردهایم، نه بهعنوان اندازهٔ مدل واقعی.
در ترتیب تازه، Cبردارِ موقعیت۰وAبردارِ موقعیت۱میگیرند. سپس همان self-attentionدوباره اجرا و خروجیها به هویت A,B,Cهمتراز میشوند. این بار یکسان نیستند؛ جدول فقط مؤلفهٔ اول را با شش رقم اعشار نشان میدهد و JSONهمهٔ چهار مؤلفه را دارد.
| هویت توکن | مؤلفهٔ اول، ترتیبA,B,CباPE | مؤلفهٔ اول، ترتیبC,A,BباPE، همتراز |
|---|---|---|
| A | 0.912510 | 1.362558 |
| B | 0.907295 | 1.130061 |
| C | 0.917795 | 0.678322 |
بیشترین اختلافِ مؤلفهها در دو خروجیِ همتراز حدود0.451620است. کد واقعاً بزرگتربودنِ آن از۰٫۰۱و برابرماندنِ حالتِ بدونPEدر حد خطای محاسبه را کنترل کرده است. این اختلاف، امتیازِ کیفیت یا درکِ معنای جمله نیست؛ اثرِ اطلاعات موقعیت در همین محاسبه است.
دامِ جمع ساده را ببینیم
اگر پیش از attentionفقط بردارهای embedding+PEرا برای همان سه موقعیت جمع کنیم، مجموعِ دو ترتیب هنوز برابر میشود: مجموعهٔ embeddingها و مجموعهٔPEها تغییری نکردهاند. بنابراین «جمعِ همهٔ ورودیها» در این مثال شاهدِ درستِ تشخیص ترتیب نیست. کد همین ضدنمونه را هم واقعاً بررسی میکند؛ تفاوتِ جدول از اجرایِ بعدیِ attentionآمده است.
همهٔ ترنسفورمرها همین فرمول نیستند
مقالهٔ اصلی یک انتخابِ sin/cosرا شرح میدهد؛ مدلهای مختلف میتوانند روشهای موقعیتِ آموختهشده، نسبی یا چرخشی داشته باشند. این فایل آن روشها را پیاده نکرده، مدلی آموزش نداده و تعمیم به طولِ تازه یا زبان فارسی را نسنجیده است. نامPEرا با تاریخ، ترتیب رخدادِ واقعی یا حافظهٔ پایدارِ دستیار یکی نگیریم.
مثال Q/K/V محاسبهٔ وزن توجه را معرفی میکند؛ این نوشته آزمایشِ جایگشت و اطلاعات ترتیب را اجرا میکند. Poolingبا ماسک هم مرحلهٔ تبدیلِ چند ردیف به یک بردارِ متن است و نباید آن را خودکار حفظکنندهٔ ترتیب دانست. ادامهٔ مبانی در راهنمای هوش مصنوعی است؛ این مثال معماریِ داخلی محصول اپرا نیست.
فایل تمرین و منبع
آزمایش واقعیِ جایگشت و همترازی هویت توکن، با/بدون موقعیت · ورودیها، بردار موقعیت و چهار ماتریس خروجیِ محاسبهشده
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.