
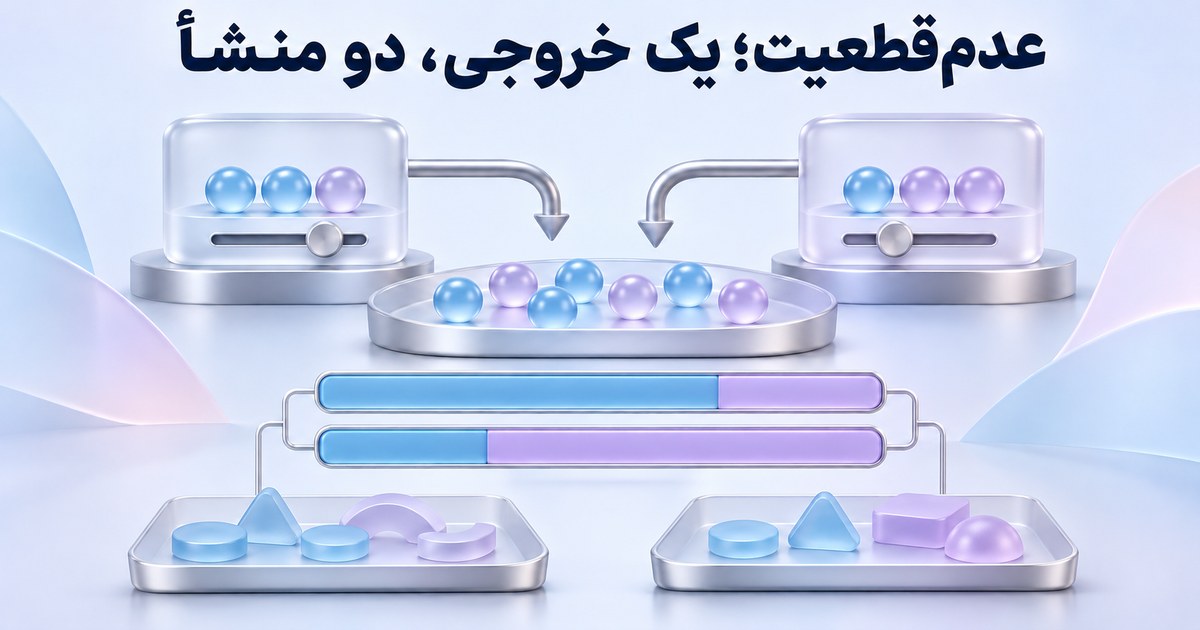
عدمقطعیتِ Aleatoric به پراکندگیِ مشاهده در مدلِ مفروض و Epistemic به ندانستنِ مدل یا پارامتر مربوط است. جداکردنِ آنها به فرضهایِ مدل وابسته است؛ فقط دیدنِ یک احتمالِ پیشبینی کافی نیست. در این تمرینِ کوچک، دو فرضیهٔ احتمالی میسازیم، وزنشان را با مشاهده واقعاً بهروز میکنیم و قانونِ واریانسِ کل را با کسرِ دقیق بررسی میکنیم.
دو فرضیه و یک متغیرِ صفر/یک
خروجیِ Y صفر یا یک است. فرضیهٔ H0 احتمالِ یک را یکچهارم و H1 آن را سهچهارم میداند. وزنِ آغازینِ هر فرضیه یکدوم است؛ نویسنده این خانواده و وزنها را داده است، نه اینکه شبکهای آنها را از دادهٔ مشتری یاد گرفته باشد. برایِ مشاهدههایِ پیاپی فرض میکنیم همان فرضیهٔ پنهان ثابت و نتیجهها شرطی بر آن مستقلاند.
در آغاز، احتمالِ پیشبینیِ یک برابرِ نیم است و واریانسِ برنولی یکچهارم. اما درونِ هر فرضیه، واریانس p(1−p) برابرِ سهشانزدهم است. میانگینِ وزندارِ این واریانسها هم سهشانزدهم میشود؛ واریانسِ میانگینهایِ شرطی، یعنی دو p، یکشانزدهم است. جمعِ دو جزء همان یکچهارم است.
قانونِ واریانسِ کل را از توزیع هم کنترل کنیم
کد چهار حالتِ مشترکِ فرضیه و Y را با احتمالِ دقیق میسازد و واریانسِ Y را مستقیم جمع میزند. سپس جدا E[Var(Y|H)] و Var(E[Y|H]) را حساب میکند و برابریِ جمع را کنترل میکند. تعبیرِ دو جزء به نویز و ندانستنِ فرضیه، در چارچوبِ همین خانواده است؛ اندازهگیریِ مستقلِ دو منشأ در دادهٔ واقعی نیست.
این حساب با تجزیهٔ bias و varianceِ خطایِ یک برآوردگر یکی نیست. آنجا ممکن است میانگینِ پیشبینی رویِ چند مجموعهٔ آموزش و فاصله از تابعِ واقعی را بررسی کنیم؛ اینجا توزیعِ پیشبینی از مخلوطِ فرضیهها و وزنِ پسینِ آنها ساخته میشود. هیچ دستهای از مدلها دوباره آموزش داده نشده است.
چهار مشاهده، پنج مرحلهٔ واقعی
رشتهٔ ساختگیِ ۱،۱،۰،۰ را وارد میکنیم. در هر گام، وزنِ قبلی در درستنماییِ همان مشاهده ضرب و بر مجموعِ وزنهایِ حاصل تقسیم میشود. این بهروزرسانیِ بیز واقعاً اجرا شده است؛ جدول از وزنهایِ ازپیشنوشتهشده برایِ نمایش ساخته نشده است.
| مشاهدههایِ آمده | وزنِ H0,H1 | احتمالِ یک | میانگینِ واریانسِ شرطی | واریانسِ میانگینها |
|---|---|---|---|---|
| آغاز | 1/2, 1/2 | 1/2 | 3/16 | 1/16 |
| 1 | 1/4, 3/4 | 5/8 | 3/16 | 3/64 |
| 1,1 | 1/10, 9/10 | 7/10 | 3/16 | 9/400 |
| 1,1,0 | 1/4, 3/4 | 5/8 | 3/16 | 3/64 |
| 1,1,0,0 | 1/2, 1/2 | 1/2 | 3/16 | 1/16 |
پس از دو یک، وزنها یکدهم و نهدهماند؛ با آمدنِ دو صفر دوباره برابر میشوند. بنابراین واریانسِ بینِ فرضیهها در این رشته در همهٔ گامها کم نمیشود. دادهٔ بیشتر میتواند شناخت را تغییر دهد، اما از یک مسیرِ مشاهده، افتِ یکنوایِ عدمقطعیت برایِ همهٔ مدلها نتیجه نمیگیریم.
یک پیشبینی، دو تقسیمِ کاملاً متفاوت
دو قراردادِ جایگزین را هم حساب میکنیم. اگر فقط یک فرضیهٔ معلوم با p=0.5 داشته باشیم، پیشبینی برنولیِ نیم و واریانسِ کل یکچهارم است؛ تمامِ آن جزءِ شرطی است و واریانسِ بینِ فرضیهها صفر. اگر دو فرضیهٔ قطعیِ p=0 و p=1 با وزنِ برابر داشته باشیم، همان پیشبینی و واریانسِ کل را میگیریم، ولی جزءِ شرطی صفر و واریانسِ بینِ فرضیهها یکچهارم است.
پس توزیعِ پیشبینیِ یکسان میتواند با تقسیمِ متفاوتی همراه باشد. بدونِ فرضِ مدل، معنایِ مشاهده و شاهدِ مناسب، این دو جزء فقط از یک احتمالِ خروجی قابلِ شناسایی نیستند. اختلافِ چند مدلِ دلخواه هم خودکار واریانسِ پسینِ معتبر یا سنجهٔ کاملِ Epistemic نیست.
مرزِ تمرین و کاربردِ عملی
مقالهٔ اصلیِ سالِ ۲۰۱۷ تعریفِ دو نوعِ عدمقطعیت را در یادگیریِ بیزی بررسی میکند؛ آزمایشهایِ بیناییِ آن اینجا تکرار نشدهاند. شبکهٔ بیزی، dropout، روشِ MCMC و دادهٔ واقعی نداریم. این فایل یک خانوادهٔ محدودِ برنولی را با محاسبهٔ دقیق بازتولید میکند، نه کیفیتِ عدمقطعیتِ محصول را.
تجزیهٔ اریبی و واریانسِ خطا را برایِ سؤالِ متفاوتِ خطایِ برآوردگر ببینید. برایِ ارزیابیِ تحلیلِ تماس، مرجع و معنایِ نمره را در درخواستِ بررسیِ اپرابین مشخص کنید. وجودِ دو جزء در این تمرین، اعلامِ قابلیتِ خاص یا تضمینِ درستیِ پاسخ نیست.
فایل تمرین و منبع
توزیعِ مشترک و بهروزرسانیِ واقعیِ وزنِ فرضیهها با بیز · پنج مرحلهٔ پسین و دو تقسیمِ متفاوت برایِ پیشبینیِ یکسان
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.