
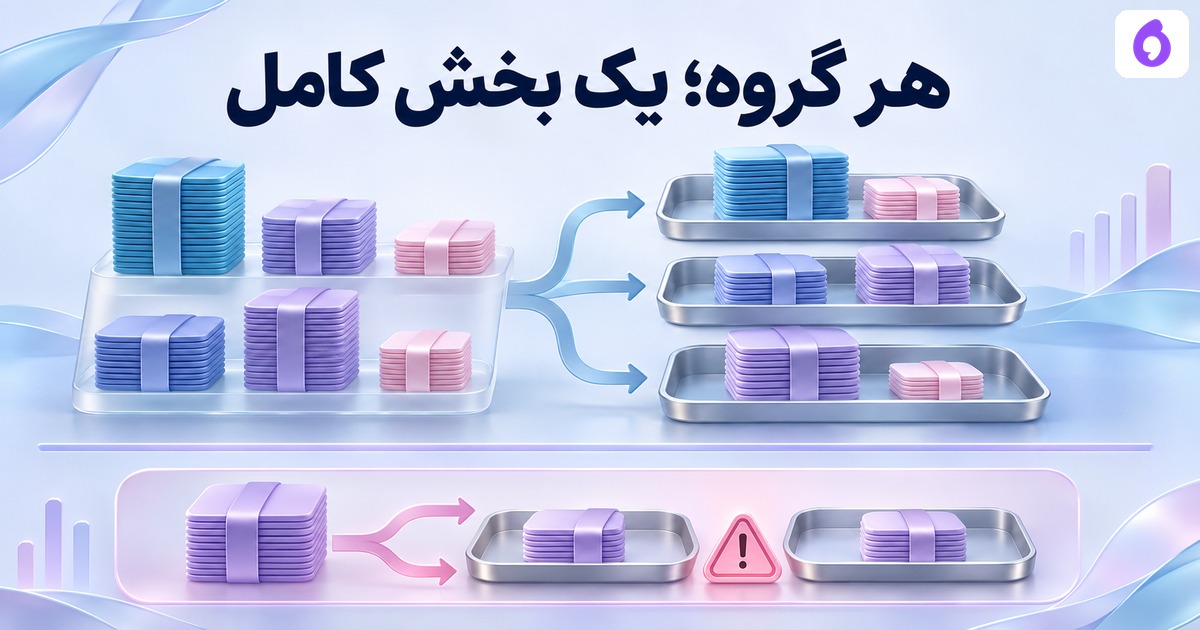
Group K-fold بخشهایِ اعتبارسنجی را طوری میسازد که یک گروه در همان دور همزمان در آموزش و ارزیابی نباشد؛ هر گروه در مجموعهٔ دورها یکبار کنار گذاشته میشود. فقط متفاوتبودنِ شمارهٔ ردیف کافی نیست. در این تمرین همهٔ سه بخش را برایِ ده ردیفِ متعلق به شش گروه میسازیم و مسیرِ غلطِ تقسیمِ ردیفی را هم کنترل میکنیم.
گروه، واحدِ وابستگیِ اعلامشده است
ردیفهایِ صفر تا دو از G1،سه وچهار از G2،پنج وشش از G3 و سه ردیفِ آخر از G4،G5 وG6 هستند. شناسهها ساختگیاند؛ گروه میتواند در مسئلهٔ واقعی منبع، فرد یا واحدِ دیگری باشد، اما معنیِ آن باید از سؤالِ ارزیابی بیاید. کد از شباهتِ متن یا نام، هویتِ گروه را کشف نمیکند.
اگر هدف بررسیِ منبعِ ندیده است، وجودِ همان منبع در آموزشِ همان دور میتواند سؤال را عوض کند. از سویِ دیگر، نشتهایِ دیگری مثلِ رابطهٔ چند منبع با یک شخص، زمانِ آینده یا تکرارِ سند با شناسهٔ تازه، فقط با مقایسهٔ همین رشتهٔ گروه پیدا نمیشوند.
یک الگوریتمِ گروهبندیِ قابلِ مشاهده
گروهها را با تعدادِ ردیف از بزرگ به کوچک و در تساوی با نام مرتب میکنیم. هر گروه به بخشی میرود که تا آن لحظه ردیفِ کمتری دارد؛ تساویِ بخشها با شمارهٔ کوچکتر شکسته میشود. این الگوریتمِ آموزشیِ greedy است و برابریِ بیتی با پیادهسازیِ sklearn.GroupKFold را ادعا نمیکند.
در هر دور، گروههایِ یک بخش کنار میروند و همهٔ گروههایِ دیگر آموزشاند. فایل تقاطعِ گروهِ دو طرف را واقعاً محاسبه میکند. همچنین در پایان کنترل میکند هر ده ردیف و هر شش گروه دقیقاً یکبار در فهرستِ کنارگذاشتهشدهها آمده باشند؛ این پوشش از رویِ نامِ K-fold فرض نشده است.
دفترِ هر سه دور
| دور | گروههایِ کنارگذاشته | ردیفهایِ صفرمبنا | تعداد |
|---|---|---|---|
| 1 | G1, G6 | 0, 1, 2, 9 | 4 |
| 2 | G2, G4 | 3, 4, 7 | 3 |
| 3 | G3, G5 | 5, 6, 8 | 3 |
اندازهها چهار،سه وسهاند؛ برابرکردنِ دقیقِ اندازهٔ ردیفها هدفِ اجباریِ قیدِ گروه نیست. الگوریتم، بهینگیِ توازن یا برابریِ توزیعِ کلاسها را ثابت نمیکند. اگر یک گروه بخشِ بزرگی از داده را داشته باشد، نمیتوان برایِ زیباترشدنِ عددِ اندازه، آن را بیدلیل شکست.
تقسیمِ ردیفی چه مشکلی ساخت؟
مسیرِ غلطِ نمونه، ردیفها را بر پایهٔ باقیماندهٔ شماره بر سه بینِ بخشها پخش میکند. هر ردیف همچنان یکبار ارزیابی میشود، ولی در هر سه دور بعضی گروهها در هر دو طرف حاضرند. برایِ نمونه G1 سه ردیفِ متوالی دارد و در تقسیمِ گردشی بینِ بخشها شکسته میشود. JSON نامِ تمامِ گروههایِ مشترکِ هر دور را نگه میدارد.
پس پوششِ یکبارهٔ ردیف، جایِ جداییِ گروه را نمیگیرد. کد همچنین گروهِ ناموجود، تعدادِ گروهِ کمتر از تعدادِ بخش و kِ بولی را رد میکند. تبدیلِ مقدارِ نامعلوم به شناسهٔ دلخواه میتواند استقلالِ ظاهری بسازد؛ برایِ این حالت عدد یا گروه اختراع نکردهایم.
بعد از تقسیم چه چیزی باقی است؟
هیچ مدلی آموزش ندیده و امتیازِ کیفیتی تولید نشده است. در استفادهٔ واقعی، تبدیلهایِ آموختنی باید فقط از آموزشِ همان دور برازش بگیرند. خودِ این تقسیم، انتخابِ ابرپارامتر، آزمونِ نهاییِ مستقل یا توالیِ زمانیِ مجاز را تعیین نمیکند. شش نامِ گروه هم شاهدِ استقلالِ آماریِ شش واحد در جهانِ واقعی نیست.
مثالِ K-fold و OOF پیشبینی و تجمیعِ امتیاز را حساب میکند؛ این صفحه سازندهٔ همهٔ بخشها با قیدِ گروه است. برایِ قیدِ همزمانِ فرد و ضبط، تقسیمِ گوینده و منبعِ صوت نشان میدهد گاهی ابتدا باید مؤلفههایِ وابسته را یکی کرد.
برایِ سنجشِ تحلیلِ تماس، واحدِ مستقل و منبعِ نمونهها را در بررسیِ اپرابین مشخص کنید. خروجیِ این فایل یک دفترِ تقسیمِ ساختگی است؛ دقت یا روشِ ارزیابیِ داخلیِ محصول را اعلام نمیکند.
فایل تمرین و منبع
هر سه بخشِ گروهی و ضدنمونهٔ تقسیمِ ردیفی را بسازید · شش گروه، پوششِ یکبارهٔ همهٔ ردیفها و گروههایِ مشترکِ مسیرِ غلط
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.