
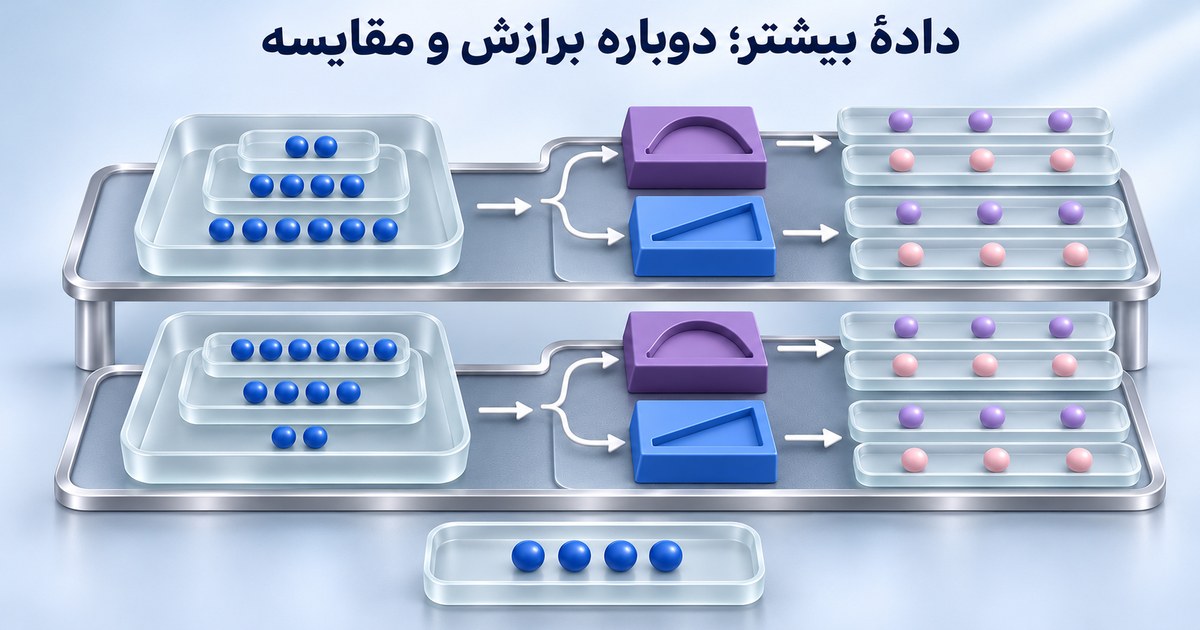
منحنیِ یادگیری، امتیازِ آموزش و اعتبارسنجی را در اندازههایِ متفاوتِ دادهٔ آموزش نشان میدهد. سؤال این است که افزودنِ نمونه در همین طرح چه تغییری ایجاد میکند؛ نه اینکه هر افزایشِ تعداد الزاماً عملکرد را بهتر کند. در این تمرین سه اندازه، دو ترتیبِ ورودِ نمونه و دو خانوادهٔ ساده را با دوازده برازشِ واقعی مقایسه میکنیم.
داده و مرجع را آشکار نگه داریم
شش x شاملِ منفی و مثبتِ یک،دو و سه است. نویسنده y را از x² بهاضافهٔ شش اغتشاشِ ثابتِ کوچک ساخته است؛ این اغتشاشها نمونهگیریِ تصادفی یا نویزِ اندازهگیریِ مشتری نیستند. چهار ردیفِ اعتبارسنجیِ ثابت با xهایِ منفیِ ۲٫۵، منفیِ ۰٫۵،۰٫۵ و۲٫۵ و مرجعِ x² داریم. شناسههایِ V با شناسههایِ R آموزش متفاوتاند.
در یک ترتیب، نمونههایِ مثبت و منفی از مرکز به بیرون وارد میشوند. در ترتیبِ دوم، دو مقدارِ منفیِ بیرونی زودتر میآیند. هر بار دو،چهار یا شش ردیفِ نخستِ همان ترتیب را میگیریم. مجموعهها در هر ترتیب تودرتو هستند، ولی در اندازهٔ برابر الزاماً همان ردیفها را ندارند؛ فایل دقیقاً شناسهها را ثبت میکند.
در هر اندازه، مدل را از نو برازش دهیم
خانوادهٔ اول فقط یک عددِ ثابت دارد؛ بهترینِ کمترین مربعاتِ آن میانگینِ yهایِ همان زیرمجموعه است. خانوادهٔ دوم ضریبی را در x² ضرب میکند و عرض از مبدأ ندارد؛ ضریب از مجموعِ x²y بر مجموعِ x⁴ به دست میآید. ویژگیِ درجهدو را انسان داده است؛ کد ساختارِ تابع را از میانِ همهٔ مدلها کشف نکرده است.
برایِ هر یک از دوازده حالت، پارامتر فقط از دادهٔ آموزش حساب میشود. سپس میانگینِ مربعِ خطا رویِ همان زیرمجموعه و رویِ چهار ردیفِ ثابت جدا محاسبه میشود. جدولِ منحنی از امتیازهایِ دستی ساخته نشده و یک مدلِ نهایی هم به همهٔ اندازهها نسبت داده نشده است.
خروجیِ واقعی و اثرِ ترتیب
| ترتیب | n | خانواده | MSEِ آموزش | MSEِ اعتبارسنجی |
|---|---|---|---|---|
| balanced_prefix | 2 | ثابت | 0.0225 | 13.8400 |
| balanced_prefix | 2 | ضریبِ x² | 0.0225 | 0.0489 |
| balanced_prefix | 4 | ثابت | 2.1250 | 9.5625 |
| balanced_prefix | 4 | ضریبِ x² | 0.0243 | 0.0015 |
| balanced_prefix | 6 | ثابت | 10.8356 | 11.0069 |
| balanced_prefix | 6 | ضریبِ x² | 0.0466 | 0.0000 |
| outer_negative_first | 2 | ثابت | 6.7600 | 20.9025 |
| outer_negative_first | 2 | ضریبِ x² | 0.0005 | 0.0200 |
| outer_negative_first | 4 | ثابت | 11.3719 | 9.3906 |
| outer_negative_first | 4 | ضریبِ x² | 0.0116 | 0.0204 |
| outer_negative_first | 6 | ثابت | 10.8356 | 11.0069 |
| outer_negative_first | 6 | ضریبِ x² | 0.0466 | 0.0000 |
برایِ شش نمونه، هر دو ترتیب به همان مجموعه و همان پارامترِ هر خانواده میرسند؛ کد این برابری را کنترل میکند. برایِ اندازههایِ کوچک، محل و ترکیبِ نمونهها مهماند. بنابراین یک پیشوندِ کوچک، نمایندهٔ تصادفیِ همهٔ دادههایِ ممکن نیست و از شیبِ یک مسیر حکمِ قطعیِ «فقط داده اضافه کن» نمیگیریم.
دو منحنی، تشخیصِ قطعیِ علت نیستند
اگر خطایِ آموزش و اعتبارسنجی هر دو زیاد باشد، محدودیتِ خانواده یکی از توضیحهایِ قابلِ بررسی است؛ کیفیتِ مرجع، ویژگی و دامنه هم باید بررسی شود. اگر فاصلهٔ دو خطا زیاد باشد، نشت، بیشبرازش یا تفاوتِ جمعیت را بدونِ شاهد به یک علت تقلیل ندهید. مثالِ ما فقط همین داده و دو فرمولِ برازش را دارد.
راهنمایِ بیشبرازش جدابودنِ ارزیابی و محدودیتِ نمرهٔ آموزش را توضیح میدهد؛ خروجیِ تازهٔ این صفحه دوازده برازش با اندازه و ترتیبِ معلوم است. تعریفِ آماریِ bias و variance هم از یک جدولِ تنها اثبات نمیشود و در تمرینِ تجزیهٔ خطا با قراردادِ دیگری بررسی شده است.
چه چیزهایی هنوز اجرا نشدهاند؟
این دو ترتیب، K-fold یا فاصلهٔ عدمقطعیت نیستند. دادهٔ آزمونِ نهاییِ دستنخورده، هزینهٔ جمعآوریِ نمونه و زمانِ آموزش هم سنجیده نشدهاند. اگر همین اعتبارسنجی را برایِ انتخابِ خانواده مصرف کنیم، نباید آن را نتیجهٔ نهاییِ مستقل بنامیم. هیچ تابعِ learning_curve از scikit-learn اجرا نشده است؛ مرجعِ اصلی برایِ تعریفِ محورهایِ منحنی خوانده شده است.
برایِ سنجشِ یک راهکارِ پاسخگویی یا تحلیلِ تماس، نمونهٔ مجاز و معیارِ پذیرش را در بررسیِ نیاز با اپرا مشخص کنید. نتیجهٔ آموزشیِ این دوازده برازش، تعهدِ محصول به بهترشدن با تعدادِ خاصی از مکالمات نیست.
فایل تمرین و منبع
دوازده برازشِ واقعی در سه اندازه، دو ترتیب و دو خانواده · شناسهٔ آموزش، پارامتر و MSEِ آموزش/اعتبارسنجی در هر ردیف
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.