
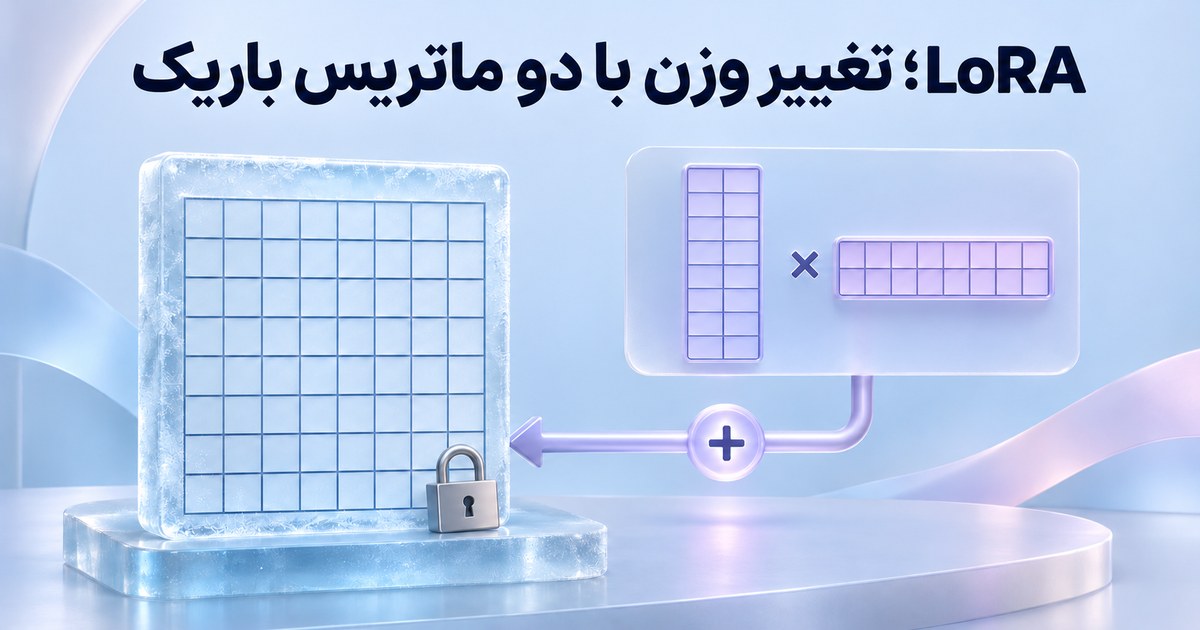
LoRA روشی برای تنظیم مدل آماده است که وزن اصلیِ بخشهای هدف را ثابت نگه میدارد و تغییر را با ماتریسهای کوچکترِ قابل آموزش نمایش میدهد. «ثابت» به معنی حذف وزن پایه از حافظه نیست. برای فهم تفاوت، یک ماتریس کوچک را حساب میکنیم و بعد تعداد پارامترهای یک لایهٔ فرضی بزرگتر را میشماریم.
از تغییر کامل وزن تا تغییر کمرتبه
فرض کنید وزن یک تبدیل خطی W ابعاد m×n دارد. در تغییر کامل همین ماتریس، m×n مقدار میتواند آموزش ببیند. در شکل پایهٔ LoRA، تغییر ΔW با حاصلضرب B×A نمایش داده میشود؛ A ابعاد r×n و B ابعاد m×r دارد. پس شمار مقدارهای دو ماتریس r×n+m×r است. رتبهٔ حاصلضرب حداکثر r است؛ کوچکبودن r یک محدودیت ساختاری روی تغییر ایجاد میکند.
در این توضیح، ضریب مقیاس را۱ و بایاس را خارج از مثال گرفتهایم. تنظیم واقعی میتواند ضریب و لایههای هدف متفاوتی داشته باشد. نام LoRA بهتنهایی نمیگوید کدام بخش مدل، چه رتبهای و با چه دادهای تنظیم شده است.
یک ضرب ماتریسی قابل بررسی
A = [[1,0,2], [0,1,-1]]       # 2×3
B = [[1,2], [0,1], [2,0], [1,-1]]  # 4×2
ΔW = [[1,2,0], [0,1,-1], [2,0,4], [1,-1,3]]  # 4×3
برای مثال، خانهٔ سطر اول و ستون سوم برابر 1×2+2×(−1)=0 است. این اعداد انتخاب آموزشیاند و از هیچ مدلی آموخته نشدهاند. در همین مثال خیلی کوچک، A و B جمعاً۱۴ مقدار دارند، در حالی که W دوازده مقدار دارد؛ پس کمرتبهبودن در هر اندازه و هر r الزاماً تعداد را کمتر نمیکند.
مثال شمارش برای یک ماتریس بزرگتر
برای یک ماتریس فرضی ۴۰۹۶×۴۰۹۶ با r=8، تغییر کامل۱۶٬۷۷۷٬۲۱۶ مقدار و دو ماتریس آداپتر۶۵٬۵۳۶ مقدار دارند. نسبت شمارش۲۵۶ است. این نسبت فقط برای پارامترهای قابل آموزش همین ماتریس و با قرارداد مثال است؛ نه برای کل مدل، زمان آموزش، قیمت یا حافظهٔ GPU.
| پرسش | تغییر کامل | LoRA در مثال |
|---|---|---|
| پارامتر قابل آموزشِ ماتریس هدف | m×n | r×n+m×r |
| وزن پایه لازم است؟ | بله | بله، با وجود ثابتبودن |
| کیفیت از روی تعداد معلوم است؟ | خیر | خیر |
| حافظه و زمان را چگونه بفهمیم؟ | با اندازهگیری پیکربندی واقعی | با اندازهگیری همان پیکربندی |
چه چیزی را نباید از این عدد نتیجه بگیریم؟
وزن پایه، فعالسازیها، گرادیانها، وضعیت بهینهساز و طول ورودی هرکدام میتوانند در مصرف حافظه نقش داشته باشند. کاهش۲۵۶برابری شمار قابل آموزش یک ماتریس، کاهش۲۵۶برابری VRAM نیست. همچنین شمار کمتر، کیفیت برابر یا بهتر را تضمین نمیکند؛ کار و داده و لایهٔ هدف مهماند.
مقالهٔ اصلی LoRA در۲۰۲۱ معرفی شد؛ نتایج تجربی آن مربوط به تنظیمات همان پژوهشاند. اعداد آموزشی این صفحه بازتولید آن بنچمارک نیستند. فایل Python همراه فقط ضرب ماتریس و شمارش را واقعاً اجرا کرده است؛ آموزش مدل، خرید GPU، اجرای API یا اندازهگیری حافظه انجام نشده است.
برای انتخاب روش چه اطلاعاتی لازم است؟
نسخه و مجوز مدل پایه، هدف تغییر رفتار، دادهٔ مجاز، لایههای هدف، رتبه، ضریب و نسخهٔ آداپتر را ثبت کنید. مدل پایه و نسخهٔ تنظیمشده را روی مجموعهٔ مستقل و موارد خارج از دامنه مقایسه کنید. آداپترِ یک پایه را بدون بررسی سازگاری روی پایهٔ دیگر قابل استفاده فرض نکنید.
تفاوت تنظیم دقیق با آموزش از صفر تصمیم کلی را توضیح میدهد؛ اینجا سازوکار محدودکردن تغییر ماتریس را دیدیم. برای فهم وزن و لایه، مثال شبکهٔ عصبی کوچک مکمل است. اگر مسئله فقط پاسخ از چند سند متغیر است، پیش از آموزش، مسیر دستور و بازیابی را بررسی کنید. این مقاله اعلام استفاده از LoRA در محصولات اپرا نیست؛ مبانی هوش مصنوعی مسیر ادامهٔ یادگیری است.
فایل تمرین و منبع
کد محاسبهٔ ماتریس و شمار پارامتر؛ Python · جدول دامنهٔ مقایسه؛ تعداد پارامتر با حافظه یکی نیست
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.