
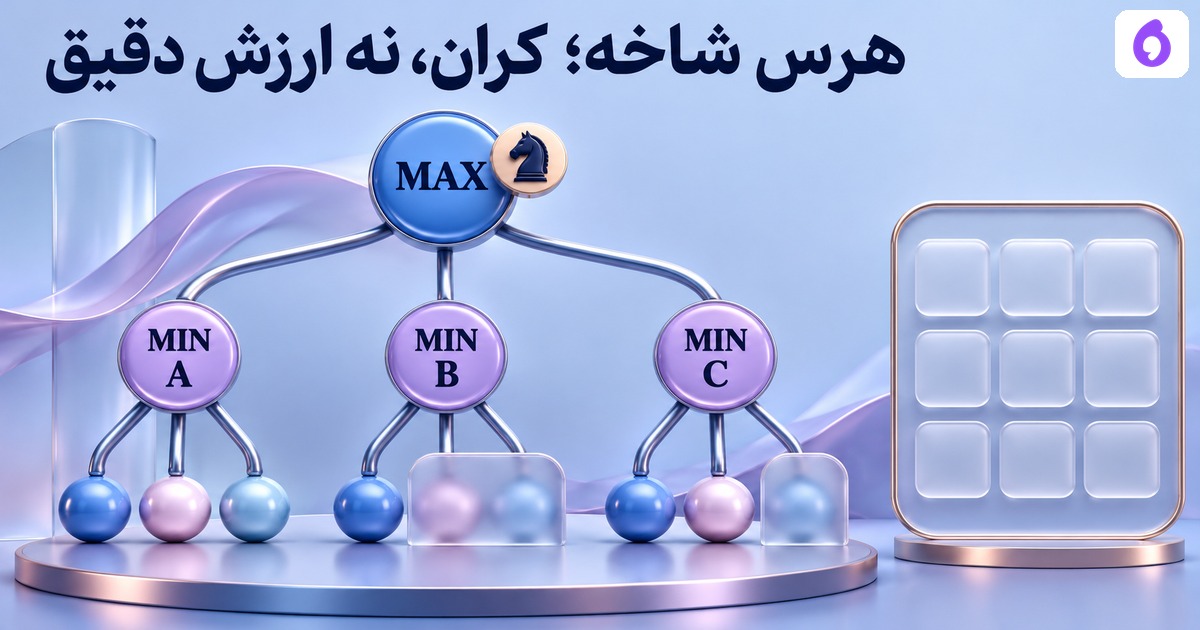
Minimax برایِ یک بازیِ نوبتیِ دوطرفه، تصمیمِ ما را با فرضِ بهترینِ پاسخِ حریف بررسی میکند. MAXبیشترین وMINکمترینِ امتیازِ ما را انتخاب میکند. هرسِ آلفا–بتا بعضی شاخهها را وقتی کنار میگذارد که دیگر رویِ تصمیمِ ریشه اثر ندارند؛ فرقش با حذفِ دلخواهِ شاخههایِ کمامتیاز را با یک درختِ کوچک اجرا میکنیم.
فرضهایِ بازی و جهتِ امتیاز
درختِ آموزشیِ ما متناهی، قطعی، کاملاً مشاهدهپذیر و جمعصفر است؛ امتیازِ حریف منفیِ امتیازِMAXفرض میشود. ریشه نوبتِMAXو لایهٔ بعد نوبتِMINاست. برگها پایانِ واقعیِ همین درخت با ارزشِ معلوماند؛ از تابعِ ارزیابیِ حدسی در عمقِ قطعشده استفاده نکردهایم. بازیِ واقعی، شطرنج یا یادگیریِ خودبازی اجرا نمیشود.
ریشه سه انتخابِA،BوCدارد. برگهایِAبهترتیب۴،۹،۶؛ برگهایِBبرابرِ۲،−۵،۱۰؛ و برگهایِCبرابرِ۵،۳،۷هستند. همهٔ امتیازها از دیدِMAXنوشته شدهاند. یک برگِ جذابِ۱۰درشاخهٔBبه معنیِ انتخابِ قطعیِ آن نیست؛ MINمیتواند گزینهٔ دیگری از همان شاخه را برگزیند.
اول جوابِ کامل را بدونِ هرس حساب کنیم
MINدرAکمترینِ۴،۹،۶یعنی۴را میگیرد؛ درBمنفی۵و درCعدد۳را. MAXدرریشه بیشترینِ۴،−۵،۳را انتخاب میکند، پس ارزشِریشه۴وحرکتِبهینهAاست. تابعِ مستقلِminimaxهرنه برگ را واقعاً میخواند واین جواب را بهعنوانِoracleِدرختِکوچک ثبت میکند.
| شاخه | برگها از دیدِMAX | ارزشِ دقیقِ MIN با خواندنِ همه |
|---|---|---|
| A | ۴،۹،۶ | ۴ |
| B | ۲،−۵،۱۰ | −۵ |
| C | ۵،۳،۷ | ۳ |
آلفا و بتا چه کرانی میدهند؟
آلفا کرانِ پایینِ انتخابی است که MAXدر مسیرِ بررسی دارد؛ بتا کرانِ بالایِ انتخابی است که MINمیتواند تحمیل کند. وقتی آلفا به بتا برسد یا ازآن بگذرد، ادامهٔ آن بخش برایِ تصمیمِ مربوط لازم نیست. این کرانها را احتمال، اعتمادِ مدل یا امتیازِ تجاری ننامید؛ با واحدِ همان utilityِساختهشدهاند.
پس ازخواندنِA، ریشه میداند گزینهٔ۴دارد. واردِBمیشویم؛ نخستینِبرگ۲است، پس MINدرBمیتواند امتیاز را حداکثر۲نگه دارد، حتی اگر بقیهٔبرگها را هنوز نخوانده باشیم. MAXبا داشتنِ۴، آن شاخه را ترجیح نمیدهد؛ دو برگِB2وB3واقعاً هرس میشوند.
گرهِ هرسشده را دقیقاً ارزشگذاریشده ننامیم
تابعِ هرس برایِBدراین لحظه۲برمیگرداند، اما ارزشِ دقیقِBمنفی۵است که oracleباخواندنِهمه مییابد. عددِ۲اینجا یک کرانِ کافی برایِ تصمیمِ ریشه است، نه ارزشِدقیقِگِرهِ نیمهخوانده. فایلِJSONاین تمایز را صریح نگه میدارد و همهٔ گرهها را بعد ازهرس «دقیق» معرفی نمیکند.
درC، اول۵دیده میشود وهنوز از۴بهتر به نظر میرسد؛ بعد۳میآید وبتا به۳میرسد. چون آلفایِریشه۴است، برگِآخرC3نیازی بهارزیابی ندارد. درمجموع، اجرایِهرس شش برگ ازنه برگ را ارزیابی و ارزشِ۴وحرکتِAرا مثلِoracleبرمیگرداند.
ترتیبِ فرزندان، مقدارِ کار را عوض میکند
ترتیبِ فرزندانِهمهٔگرهها را برعکس و روش را دوباره اجرا میکنیم. این بار هشت برگ ارزیابی میشود، اما ارزشِریشه۴وحرکتِAثابت میمانند. ترتیبِخوب میتواند زودتر کرانِموثر بسازد؛ ادعایِکمشدنِهمیشگیِزمان به یک نسبتِثابت ازاین مثال بهدست نمیآید.
قاعدهٔ تساویِکد، حفظِ اولینِحرکتِریشه با بهترینِارزش است. دراین داده بهترینِحرکت یکتاست؛ دربازیِدیگر ممکن است چند انتخاب ارزشِبرابر داشته باشند. تعدادِفراخوانیِارزشِبرگ را اندازه گرفتهایم، نه زمانِاجرایِعمومی؛ پیمایشِشناسههایِبرگِکنارگذاشتهشده برایِگزارش، ارزیابیِutilityِآنها نیست.
این هرس با Beam Search فرق دارد
Beam Search با عرضِمحدود ممکن است شاخهٔبهترینِدنباله را حذف کند. آلفا–بتایِاین درخت، با همان فرضها و کرانِتصمیم، ارزشِminimaxِریشه را حفظ میکند. بازیِاحتمالی، اطلاعاتِپنهان یا برگِحدسی به قراردادهایِدیگری نیاز دارد؛ تضمینِاین درخت را بیبررسی به آنها تعمیم ندهید.
یادگیریِتقویتی نیز با محیط وپاداش کار میکند، اما این کد هیچ سیاستی ازتجربه یاد نمیگیرد. برایِمبانی به آموزشِهوشِمصنوعی بروید؛ درنیازِپاسخگویی وپیگیریِمشتری، مسئله وشاهدِپذیرش را در راهکارهایِاپرا مشخص کنید. این بازیِآموزشی الگوریتمِمحصول را اعلام نمیکند.
فایل تمرین و منبع
Minimaxِ کامل و هرسِ واقعی با ثبتِ برگهایِ ندیده؛ Python · ارزشِ دقیقِ ریشه و کرانِ گرهِ نیمهخوانده، با دو ترتیب
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.