
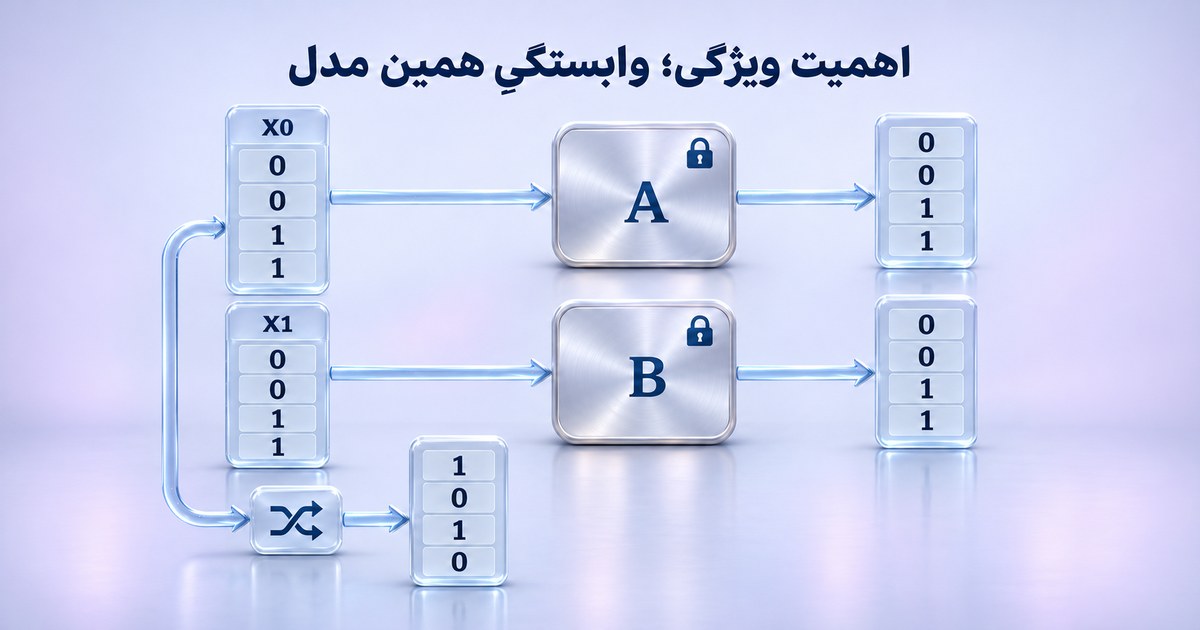
Permutation Importance میپرسد وقتی یک ستون ورودی را جابهجا کنیم، امتیازِ همین مدل روی همین داده چقدر افت میکند. این عدد، اهمیتِ ذاتی ویژگی یا اثرِ علتومعلولی آن نیست. دو مدل متفاوت میتوانند روی یک داده خروجی برابر بدهند، اما به ستونهای متفاوتی وابسته باشند.
مثال: دو ستون یکسان، دو مدل جدا
هشت ردیف ساختگی برای آموزش و چهار ردیف دیگر برای اعتبارسنجی داریم. ستونهای۰و۱ در این مثال کاملاً برابرند؛ ستون۲ یک الگوی صفر و یک دیگر است. مدلA فقط اجازه دارد ستون۰ را ببیند و مدلB فقط ستون۱ را. هر مدل یک درخت تکتقسیمی است که آستانه و برچسب دو طرفش را با کمترین تعداد خطای آموزش انتخاب میکند.
هر دو آستانهٔ صفر و قانون «بزرگتر از صفر، دستهٔ۱» را از دادهٔ آموزش پیدا میکنند. روی چهار ردیف اعتبارسنجی، هر دو چهار پاسخ درست دارند. این دقت کامل فقط برای نمونهٔ طراحیشده است؛ دربارهٔ مدل یا مشتری واقعی چیزی نمیگوید. نحوهٔ انتخاب شاخه در درخت تصمیم موضوعی جداست؛ اینجا تقسیم دو مدل را ثابت نگه میداریم و وابستگی خروجی را بررسی میکنیم.
چه چیزی را جابهجا میکنیم؟
برای هر ستون، تمام۲۴ جایگشت چهار شمارهٔ ردیف را اجرا میکنیم؛ برچسبها و دو ستون دیگر در جای خود میمانند. به دلیل مقادیر تکراری، بعضی جدولها تکرار میشوند؛ شمارش ما روی جایگشت شمارهٔ ردیفهاست، نه فقط جدولهای متمایز. مدل دوباره آموزش نمیبیند.
اهمیت در این قرارداد برابر دقت اولیه منهای میانگین دقتهای جابهجاشده است. برای مدلA، جابهجایی ستون۰ میانگین دقت را از۱ به۰٫۵ میرساند؛ افت۰٫۵ است. جابهجایی ستون۱ یا۲ اثری ندارد، چون این مدل آنها را نمیخواند.
| مدل ثابت | افت با جابهجایی ستون۰ | ستون۱ | ستون۲ |
|---|---|---|---|
| A؛ فقط ستون۰ | ۰٫۵ | ۰ | ۰ |
| B؛ فقط ستون۱ | ۰ | ۰٫۵ | ۰ |
صفر یعنی این ستون هیچ اطلاعاتی ندارد؟
خیر. ستون۱ در مدلA اهمیت صفر دارد، اما مدلB با همان ستون پاسخهای برابر میدهد. نتیجه دربارهٔ وابستگی مدل مشخص است، نه مفیدبودنِ همیشگیِ آن ستون. وقتی ویژگیها به هم وابستهاند، جابهجایی تکستون میتواند ردیفهایی بسازد که در واقعیت رخ نمیدهند؛ مثلاً دو مقدار همیشهبرابر را متفاوت کند. تفسیر باید این محدودیت را ببیند.
همچنین امتیاز انتخابی مهم است؛ افت accuracy و تغییر خطای پرهزینه یک واحد ندارند. اهمیت پایین در مدل ضعیف را گواه بیارزشبودن داده ندانید. ابتدا کیفیتِ خود مدل و استقلال دادهٔ سنجش را کنترل کنید؛ بیشبرازش با توضیح یک مدل از قبل ضعیف درمان نمیشود.
خروجی قابل بازتولید
کد با کتابخانهٔ استاندارد پایتون دو بار برازش انجام میدهد؛ سپس در مجموع۲مدل×۳ستون×۲۴جایگشت، یعنی۱۴۴ ارزیابی جابهجاشده دارد. دقت با کسر دقیق محاسبه شده و خروجی JSON همان اجراست. scikit-learn اجرا نشده؛ مستند اصلی آن برای تعریف روش و مرز تفسیر خوانده شده است. این نمونه، الگوریتم کامل درخت یا ابزار عمومی ورود داده نیست.
در یک پروژهٔ تحلیل درخواستها، ابتدا معلوم کنید کدام تصمیم را توضیح میدهید و پیامد اشتباه چیست. برای بررسی نیازِ تحلیل مکالمه، چند نمونهٔ مجاز و معیار انسانی را در مسیر کنترل کیفیت اپرا مطرح کنید؛ این راهنما ارائهٔ نمودار اهمیت ویژگی در محصول را اعلام نمیکند. امتیاز مصنوعیِ این تمرین هم شاهدِ بهبود فروش یا عملکرد آینده نیست.
فایل تمرین و منبع
برازش دو مدل کوچک و جابهجایی ستونهای اعتبارسنجی · خروجی دقیق دو مدل روی همان چهار ردیف تازه
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.