
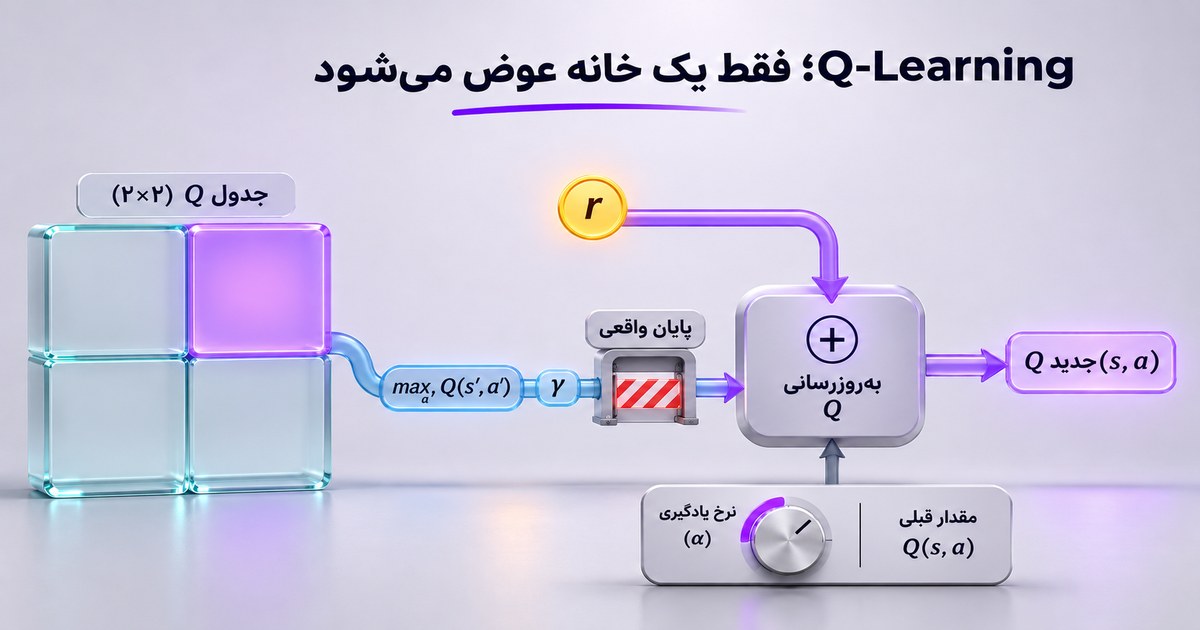
Q-Learning مقدارِ هر جفتِ وضعیت و عمل را با تجربه بهروز میکند. برخلافِ جمعزدنِ پاداشِ یک مسیر، اینجا تخمینِ قبلی را به سمتِ هدفی میبریم که پاداشِ فعلی و بهترین تخمینِ آینده را ترکیب میکند. این صفحه فقط حسابِ یک خانهٔ جدول را اجرا میکند؛ سیاستِ آماده یا عاملِ آموزشدیده تحویل نمیدهد.
جدول و تجربهٔ ساختگی
دو وضعیتِ فرضی A وB ودو عمل L وR داریم. در جدولِ اولیه Q(A,L)=۲،Q(A,R)=۰،Q(B,L)=۱ وQ(B,R)=۴ است. تجربهٔ ثبتشده میگوید از A با عمل L،پاداش۱گرفته و به B رسیدهایم. این داده ساختهٔ تمرین است؛ حرکتِ واقعیِ نرمافزار، تماس یا مشتری نیست.
نرخِ یادگیری α=۱÷۴ و ضریبِ تنزیل γ=۹÷۱۰ هستند. هدفِ غیرنهایی برابر reward+γ×max Q(next,action) است. مقدارِ تازه نیز old+α×(target−old) میشود. این max روی تخمینهای جدول است؛ دانستنِ قطعیِ بهترین پاداشِ واقعیِ آینده نیست.
گامِ غیرنهایی را حساب کنیم
بیشترین مقدارِ ردیف B برابر۴است. پس target=۱+۰٫۹×۴=۴٫۶،خطای TD برابر۴٫۶−۲=۲٫۶ و مقدارِ تازه۲+۰٫۲۵×۲٫۶=۲٫۶۵،یعنی۵۳÷۲۰است. فقط خانهٔ A,Lعوض میشود؛ A,Rوهر دو خانهٔ Bثابت میمانند.
این بهروزرسانی، یک مشاهده را با تخمینِ قبلی ترکیب میکند. مقدارِ هدف جای پاداشِ فوری را نمیگیرد؛ پاداش همچنان۱است. همچنین αوγدو نقشِ متفاوت دارند: یکی اندازهٔ اصلاحِ تخمین و دیگری وزنِ بخشِ آینده است.
پایانِ واقعی با قطعِ خارجی یکی نیست
اگر همین تجربه واقعاً به حالتِ نهاییِ مسئله ختم شده باشد، دیگر بخشِ آینده را bootstrapنمیکنیم. از همان مقدارِ اولیه۲،target=۱وnew=۲+۰٫۲۵×(۱−۲)=۱٫۷۵میشود. کد در این حالت حتی به ردیفِ بعدیِ جدول دسترسی نمیخواهد.
| حالتِ تجربه | target | new از old=۲ |
|---|---|---|
| ادامهٔ مسئله | ۴٫۶ | ۲٫۶۵ |
| پایانِ واقعی | ۱ | ۱٫۷۵ |
| قطعِ خارجی در مسئلهٔ ادامهدار | ۴٫۶ | ۲٫۶۵ |
ردیفِ سوم برای قراردادی است که مسئله از دیدِ MDPادامه دارد،اما جمعآوریِ تجربه با محدودیتِ خارجی قطع شده است. محدودیتِ زمانیِ ذاتیِ یک مسئلهٔ افقمحدود میتواند پایانِ واقعی باشد؛ پرچمها را از تعریفِ محیط بخوانید. این تمرین برای interruptedفقط به دلیلِ قطعِ خارجی بخشِ آینده را صفر نمیکند.
اجرای کد چه چیزی را ثابت میکند؟
سه ردیفِ جدول، سه آزمایشِ جدا از یک جدولِ اولیهاند؛ بهروزرسانیهای پیاپی نیستند. Pythonبا Fractionمحاسبه را دقیق اجرا و ثابتبودنِ خانههای دیگر را کنترل کرده است. هیچ محیطِ Gymnasium،حلقهٔ اکتشاف،انتخابِ تصادفیِ عمل یا آموزشِ چنددورهای اجرا نشده؛ پس بهینهبودنِ سیاست و همگرایی از آن نتیجه نمیشود.
راهنمای وضعیت،عمل وپاداش محیط وreturnرا جدا توضیح میدهد. این مقاله به جای تکرارِ آن مسیر،خودِ updateجدول را محاسبه میکند. برای پاسخگویی وپیگیریِ مشتری هم ابتدا کارِ مجاز و معیارِ پذیرش را در راهکارهای اپرا روشن کنید؛ نامِ ایجنت بهتنهایی شاهدِ آموزشِ محصول با Q-Learningنیست.
فایل تمرین و منبع
سه بهروزرسانیِ جدا از همان جدول اولیه، با کسر دقیق · old،target،TD وnew برای ادامه، پایان و قطع خارجی
منابع در ۳ نوامبر ۲۰۲۶ خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.