
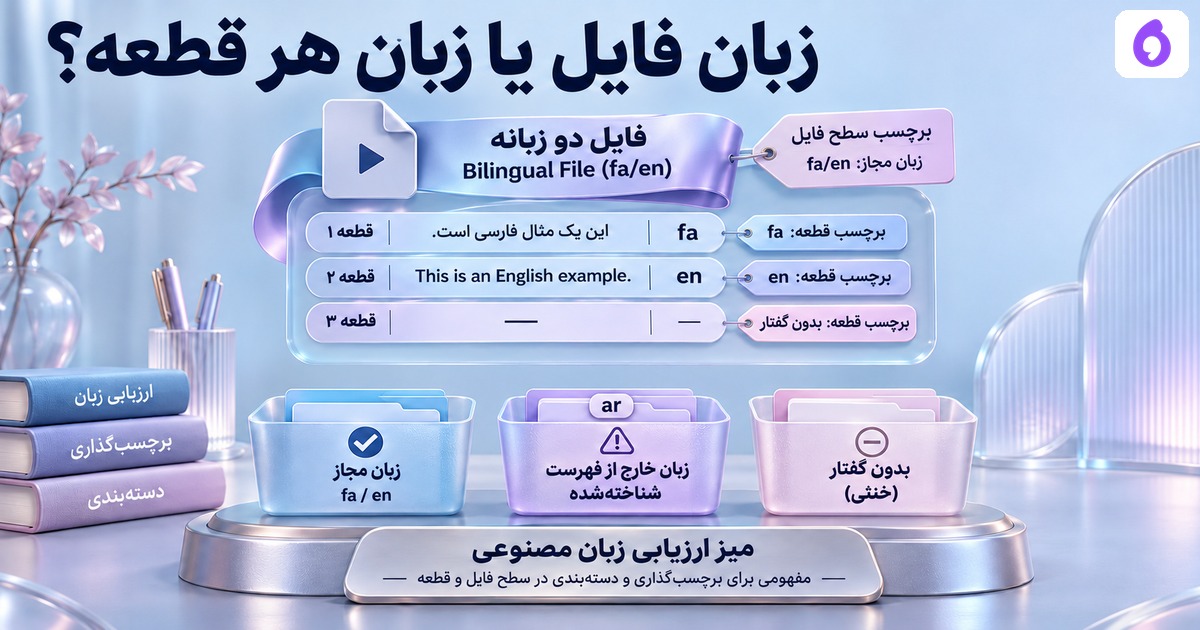
برای سنجشِ انتخابِ زبانِ صوت، اول معلوم کنید پاسخ را برای کلِ فایل میخواهید یا هر قطعه. فایلِ دوزبانه را بدونِ سیاستِ مرجع نمیتوان با یک برچسبِ اجباری داوری کرد. این راهنما یک ارزیابِ واقعی روی دادهها و پیشبینیهای کاملاً ساختگی اجرا میکند تا مخرجها، پاسخِ نامعلوم و زبانِ خارج از دامنه گم نشوند؛ دقتِ هیچ موتورِ گفتاری را اندازه نمیگیرد.
این مثال دو موتور را آزمایش نمیکند
نامِ دو مجموعهٔ پیشبینی «دستی» و«خودکار» است، اما هر دو را نویسنده بهصورتِ فرضی نوشته است. مجموعهٔ دستی همیشه fa میدهد؛ مجموعهٔ خودکار چند پاسخِ تعیینشده و چند None دارد. هیچ فایلِ صوتی، ASR،SDK،حسابِ سرویس یا تشخیصِ واقعی اجرا نشده است. اختلافِ نتیجه فقط حسابِ همین جدول است و مزیتِ محصول یا روشِ واقعی را ثابت نمیکند.
منابعِ اصلی هم ضرورتِ تعیینِ دامنه را نشان میدهند: Google انتخاب از فهرستِ زبانهای مورد انتظار را توضیح میدهد؛ Microsoft میان at-start وcontinuous LID فرق میگذارد و تشخیصِ پیوسته را معادلِ تشخیصِ تکتکِ کلماتِ زبانِ دیگر نمیداند. این توضیحِ فروشندگان را پشتیبانیِ اپرا یا قابلیتِ یکسانِ همهٔ مدلها نمینامیم.
واحدِ مرجع را صریح ثبت کنیم
مرجعِ ما پنج ردیفِ file دارد: یک فارسی، یک انگلیسی، یک بیگفتار، یک عربی و یک فایلِ مختلط. فهرستِ مجاز فقط fa وen است؛ ar زبانِ معلوم ولی خارج از فهرست است. بیگفتار با truth=None وکلاسِ no_speech جدا میماند؛ آن را زبانِ ناشناختهٔ تازه یا عربی ثبت نمیکنیم.
برای فایلِ مختلط سیاستِ صریح داریم: برچسبِ یکتای کلِ فایل از امتیازِ زبان کنار گذاشته میشود. سه قطعهٔ مرجعِ همان فایل جدا داریم:۰تا۲فارسی،۲تا۴انگلیسی و۴تا۵بیگفتار. این انتخابِ واحدِ ارزیابی است، نه ادعایِ خودکاربودنِ قطعهبندی. زمانها و حقیقتِ مرجع هم ساختهٔ تحریریهاند.
مخرجِ فایل و قطعه را مخلوط نکنیم
| سطح | همهٔ ردیفها | تکزبانِ داخلِ فهرست | کنارِ امتیاز نگهداشتهشده |
|---|---|---|---|
| فایل | ۵ | ۲ | بیگفتار،عربیِ خارج،مختلط |
| قطعه | ۳ | ۲ | یک بیگفتار |
ارزیاب برای هر سطح، تعدادِ درست، غلط، امتناعِ واجدشرایط و پاسخدادهشده را جدا میشمارد. ردیفِ خارج از دامنه یا بیگفتار از گزارش حذف نمیشود؛ شمارِ پاسخ یا امتناعش در ستونِ غیرواجدشرایط میماند، اما خودکار «درست» حساب نمیشود. نامِ ستون باید روشن کند چه چیزی سنجیده شده است.
نتیجهٔ جدولِ دستساز چه شد؟
در هر دو سطح، سیاستِ فرضیِ همیشهفارسی یک مورد از دو مرجعِ واجدشرایط را درست میزند؛ سیاستِ فرضیِ خودکار هر دو را درست میزند. این نسبتهای۱/۲و۲/۲فقط خروجیِ برنامه برای دادهٔ ساختهشدهاند. از هشت ردیفِ فرضی، درصدِ دقتِ سرویس، نرخِ موفقیتِ تماس یا نتیجهٔ مشتری استخراج نمیکنیم.
یک حالتِ سوم پاسخِ انگلیسیِ file را به None تبدیل میکند. پوشش از۲/۲به۱/۲میرسد؛ دقت میانِ پاسخدادهشدهها۱/۱میشود، ولی درست نسبت به همهٔ واجدشرایط۱/۲باقی میماند. اگر فقط۱/۱را نشان دهیم، کاهشِ پوشش پنهان میشود. امتناع را باید کنارِ کیفیتِ پاسخ گزارش کرد.
خطایِ اتصالِ پیشبینی به مرجع را زود بگیریم
کلیدِ هر ردیف، file،unit وid است. validator یکسانبودنِ مجموعهٔ کلیدها را میخواهد؛ جابهجاییِ شناسهٔ فایل واقعاً رد میشود. کدِ پیشبینیِ zz که خارج از فهرست است و تبدیلِ قطعهٔ زماندار به file نیز در آزمونِ منفی رد میشوند. وجودِ جدولِ زیبا جایِ تطبیقِ واحدها را نمیگیرد.
این نسخه فقط مجموعهٔ کوچکِ زبانهای معلوم و فهرستِ اعلامی را میشناسد؛ کدِ خارج از فرهنگِ مرجع باید پیش از اجرا تعیین تکلیف شود. صحتِ برچسبگذاریِ صوت، لهجه، اختلاطِ درونِ جمله و وابستگیِ آماریِ قطعههای یک فایل اینجا آزمایش نشدهاند. برای مطالعهٔ واقعی، مرجعِ مجاز و روشِ برچسبگذاریِ مستقل لازم است.
از سنجش به مسیرِ پاسخگویی برویم
مسیرِ زبانِ پشتیبانینشده میگوید پس از تشخیصِ محدودیت چه پاسخِ محترمانه و گزینهٔ واقعی بدهیم؛ این صفحه پیش از آن، قراردادِ سنجش و مخرجِ نتیجه را مشخص میکند. انتخابِ زبان را نشانِ ملیت یا هویتِ فرد ندانید.
برای درخواستِ اپرانگار یا بررسیِ منشی تلفنی، زبانهای لازم، نوعِ فایل یا تماس و خروجیِ مورد انتظار را مطرح کنید. فهرستِ پشتیبانی و روشِ ارائه را با تیم بررسی کنید؛ دادهٔ فرضیِ این راهنما هیچ پشتیبانیِ زبانی یا تشخیصِ خودکارِ فعال در اپرا را وعده نمیدهد.
فایل تمرین و منبع
کد کامل تمرین محلی و کنترلهای ورودی · دادهٔ ساختگی و خروجیِ اجرای واقعیِ تمرین
- Google Speech-to-Text، انتخاب از زبانهای مورد انتظار؛ بخشِ مرتبط خوانده شد، صفحه با بهروزرسانی۲۶اکتبر۲۰۲۶؛ API اجرا نشده
- Microsoft Learn، Candidate languages وAt-start/Continuous LID؛ بخشهای مرتبط خوانده شدند، نه همهٔ نمونههای SDK
منابع در 2026-11-04 خوانده شدند؛ این تاریخ، تاریخ انتشار منبع نیست. مثالها و فایلهای این راهنما آموزشی و ساختهٔ تحریریهاند.